
7. Teoria OLS nei campioni finiti
Non distorsione, varianze condizionate, Gauss–Markov e inferenza sotto normalità
Le domande della teoria dei campioni finiti
La teoria dei campioni finiti caratterizza gli stimatori per un dato n, sotto ipotesi formulate con precisione. Si distingue dalla teoria asintotica, che studia successioni di campioni di dimensione crescente. Nel consueto modello di regressione multipla y=Xβ+u, le affermazioni esatte sono spesso condizionate alla matrice osservata X. Questo consente di separare le proprietà stocastiche del termine di disturbo dalla variazione effettivamente osservata nei regressori.
Le ipotesi fondamentali sono un modello lineare nei coefficienti, un meccanismo di campionamento con adeguate condizioni di indipendenza, l'assenza di multicollinearità perfetta e una media condizionata nulla E[u|X]=0. Quest'ultima ipotesi è decisiva per la non distorsione di OLS; né l'omoschedasticità né la distribuzione normale dei disturbi sono necessarie per questa proprietà. Tuttavia, la sola media non condizionata nulla E[u]=0 non è sufficiente, perché l'errore potrebbe variare sistematicamente con i regressori.
Derivazione della non distorsione condizionata
Sostituendo y=Xβ+u nella formula OLS si ottiene
Se X ha rango pieno per colonne ed E[u|X]=0, l'aspettativa condizionata fornisce immediatamente E[β̂|X]=β. Applicando nuovamente l'aspettativa si dimostra E[β̂]=β. Questa dimostrazione è utile perché mostra esattamente dove interviene l'esogeneità: se E[u|X]≠0, OLS contiene generalmente una componente sistematica dipendente dai regressori. Il semplice fatto di stimare una regressione non dimostra l'ipotesi utilizzata per giustificarne il risultato.
L'ipotesi sull'aspettativa condizionata può non essere soddisfatta quando variabili omesse sono correlate con le variabili esplicative, quando gli agenti economici determinano congiuntamente le variabili esplicative e la variabile risultato oppure quando un regressore è misurato con errore sistematico. La regressione può comunque calcolare il coefficiente, ma il suo valore atteso non deve necessariamente coincidere con il parametro strutturale di interesse.
Matrice di covarianza condizionata di OLS
Indichiamo con Ω=Var(u|X) la matrice di covarianza condizionata del vettore dei disturbi. La sostituzione diretta fornisce
In presenza di omoschedasticità condizionata e assenza di correlazione tra unità, Ω=σ2I; l'espressione diventa
La consueta stima della varianza dell'errore è s2=RSS/(n−k−1), quando il modello contiene k regressori esplicativi e un'intercetta. Il denominatore tiene conto del numero di parametri stimati. Sotto le ipotesi condizionate classiche, questo è uno stimatore non distorto di σ2. I consueti errori standard sono le radici quadrate degli elementi sulla diagonale di s2(X′X)-1.
Se la varianza dell'errore differisce tra osservazioni, questi errori standard convenzionali possono essere inconsistenti anche quando la media condizionata nulla garantisce la non distorsione di OLS. Gli stimatori robusti vengono trattati separatamente, perché modificare il calcolo della varianza non modifica il coefficiente angolare stimato.
Il teorema di Gauss–Markov
Sotto le ipotesi di modello lineare, rango pieno, esogeneità ed errori sferici (disturbi omoschedastici e incorrelati), OLS è il miglior stimatore lineare non distorto (BLUE). «Migliore» significa che ha la matrice di covarianza condizionata più piccola tra gli stimatori lineari non distorti per ogni valore di β previsto dal modello; non significa che OLS abbia la varianza minima tra tutti gli immaginabili stimatori non lineari o distorti, né richiede che i disturbi abbiano distribuzione normale.
Per comprenderne l'intuizione, consideriamo un qualsiasi altro stimatore non distorto e lineare in y: β̃=Ay. Poiché la non distorsione richiede AX=I, scriviamo A=(X′X)-1X′+C con CX=0. Sotto Ω=σ2I, la differenza tra le matrici di covarianza dei due stimatori è
Poiché CC′ è semidefinita positiva, nessuno stimatore concorrente lineare e non distorto migliora OLS nell'ordinamento basato sulla semidefinitezza positiva. La dimostrazione individua esattamente le ipotesi che garantiscono l'efficienza e chiarisce perché questa possa venir meno in presenza di eteroschedasticità o autocorrelazione.
Distribuzioni campionarie con disturbi normali
Se u|X ha distribuzione normale congiunta N(0,σ2I), allora β̂|X è normale con media β e covarianza σ2(X′X)-1. In questo modello normale classico, ciascuna statistica t basata su una varianza opportunamente stimata ha una distribuzione t di Student esatta con n−k−1 gradi di libertà. Per q restrizioni lineari, un rapporto opportunamente costruito tra le somme dei quadrati del modello vincolato e di quello non vincolato segue una distribuzione F esatta con q e n−k−1 gradi di libertà.
In assenza dell'ipotesi di normalità, OLS può rimanere non distorto e BLUE, mentre le distribuzioni di riferimento convenzionali t e F per i campioni finiti non sono più esatte. I ricercatori si affidano allora comunemente a risultati asintotici ed errori standard robusti oppure a procedure di ricampionamento accuratamente giustificate.
Eteroschedasticità e conseguenze nei campioni finiti
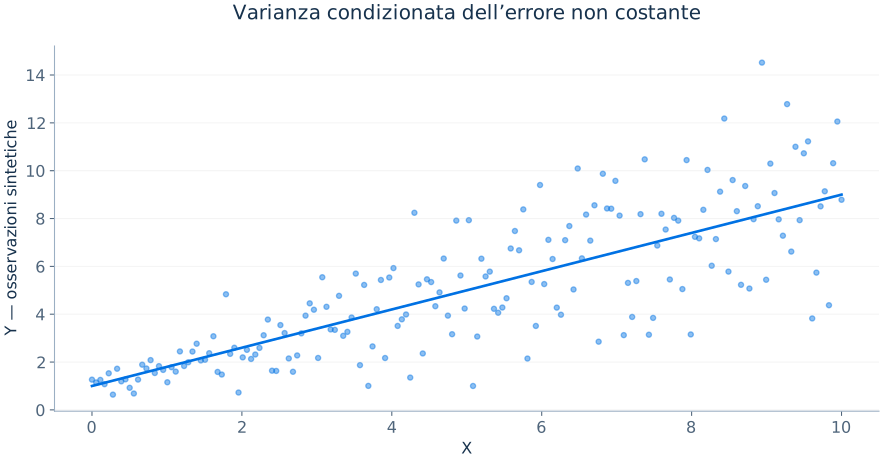
L'eteroschedasticità significa che Var(ui|Xi) cambia al variare dei regressori o di altre informazioni. Se E[ui|Xi]=0 rimane valida, la non distorsione dei coefficienti può conservarsi; la semplificazione convenzionale della varianza generalmente no. I test di omoschedasticità possono talvolta descrivere l'andamento della varianza, ma non sono necessari per giustificare l'impiego di stime della covarianza robuste all'eteroschedasticità. Gli errori standard robusti devono comunque fondarsi su una corretta struttura di indipendenza, raggruppamento o dipendenza.
Le ipotesi di Gauss–Markov in un linguaggio economico semplice
L'ipotesi di linearità riguarda la parametrizzazione della media condizionata del risultato, non l'assenza di trasformazioni non lineari delle variabili osservate. Il campionamento casuale descrive il modo in cui le unità economiche entrano nel dataset. L'assenza di collinearità perfetta richiede una variazione nei regressori che non possa essere rappresentata esattamente dagli altri regressori inclusi. La media condizionata nulla afferma che le determinanti escluse non cambiano sistematicamente con i regressori inclusi. L'omoschedasticità afferma che, condizionatamente ai regressori, la varianza non spiegata del risultato è costante; l'assenza di correlazione seriale richiede che disturbi distinti siano incorrelati. Ciascuna ipotesi deve essere valutata nel contesto del processo che ha generato i dati.
L'affermazione di Gauss–Markov riguarda una specifica classe di riferimento di stimatori; non è un'affermazione universale secondo cui OLS semplice domina ogni alternativa. Con una matrice di covarianza non sferica Ω nota, lo stimatore dei minimi quadrati generalizzati β̂ᴳᴸˢ=(X′Ω-1X)-1X′Ω-1y può essere più efficiente quando modello e covarianza sono specificati correttamente. I GLS fattibili stimano Ω dai dati e introducono quindi ulteriori ipotesi campionarie e una potenziale sensibilità agli errori di specificazione del modello della covarianza.
L'omoschedasticità come caso particolare
Per una variabile risultato binaria Y che assume valori zero e uno, E[Y|X]=p(X) e Var(Y|X)=p(X)(1−p(X)). A meno che p(X) sia costante o assuma valori particolari, questa varianza condizionata cambia con X. Un modello lineare di probabilità presenta quindi naturalmente eteroschedasticità anche quando la relazione media è approssimata correttamente. È un chiaro esempio del motivo per cui gli errori standard robusti non costituiscono un rimedio oscuro a rare patologie statistiche: l'eteroschedasticità deriva spesso direttamente dalla struttura dei dati economici.
Minimi quadrati ponderati e significato dei pesi
Quando la varianza condizionale è nota essere proporzionale a una funzione positiva hi, dividere l’intera equazione di ciascuna osservazione, intercetta compresa, per √hi rende omoschedastico il disturbo trasformato. I minimi quadrati ponderati minimizzano quindi i residui quadratici con pesi wi=1/hi. Un’osservazione più rumorosa riceve un peso minore perché fornisce meno informazione su un coefficiente comune della media condizionale. W è la matrice diagonale di questi pesi positivi.
Pesi di varianza corretti possono migliorare l’efficienza sotto l’ipotesi mantenuta di media condizionale nulla. Pesi stimati danno luogo a WLS fattibili e richiedono di verificare la specificazione della varianza; quando questa può essere errata, si usa uno stimatore di covarianza adeguato alle equazioni di stima trasformate. I pesi di precisione sono diversi dai pesi di campionamento delle indagini o dai pesi inversi della propensione, che riguardano la rappresentatività della popolazione o i confronti causali. In R, lm(y ~ x, weights = w, data = dat) richiede pesi inversamente proporzionali alla varianza per questa interpretazione di precisione. Quando la media lineare è soltanto un’approssimazione, la ponderazione può cambiare la proiezione nella popolazione che si sta stimando: una variazione dei coefficienti non dimostra automaticamente un miglioramento dell’identificazione causale.