
2. Probabilità per i dati economici
Variabili casuali, distribuzioni congiunte, aspettative condizionate e campionamento
Variabili casuali e distribuzioni
Una variabile casuale assegna un valore numerico a ogni possibile esito di un processo incerto. Le variabili casuali discrete possiedono una funzione di massa di probabilità p(x) = P(X=x) e le loro probabilità sommano a uno. Le variabili casuali continue sono rappresentate da una densità f(x): le probabilità corrispondono ad aree sotto la densità, non al suo valore in un singolo punto. La funzione di distribuzione cumulata F(x)=P(X≤x) esiste per entrambi i tipi ed è non decrescente.
Una variabile economica presenta spesso una distribuzione asimmetrica: redditi da lavoro, ricchezza e dimensioni delle imprese possono avere una lunga coda destra. La media campionaria descrive il reddito medio, mentre la mediana può rappresentare più efficacemente l'esperienza di un'osservazione tipica. Nessuna delle due statistiche, da sola, caratterizza la dispersione o le differenze tra sottogruppi della popolazione.
Valori attesi, varianza e covarianza
Il valore atteso è la media dei possibili risultati ponderata per le rispettive probabilità. Per una variabile discreta è E[X] = Σx x p(x); nel caso continuo è E[X] = ∫x f(x)dx, purché l'integrale esista. La linearità rende i valori attesi particolarmente utili:
A differenza della linearità dei valori attesi, alcune utili semplificazioni della varianza richiedono l'indipendenza. La varianza della popolazione è Var(X)=E[(X−μx)2]=E[X2]−μx2, con deviazione standard σx = √Var(X). La varianza è misurata in unità al quadrato; la deviazione standard torna alla scala di X. Per costanti a e b, Var(a+bX)=b2Var(X).
La covarianza misura la variazione congiunta tenendo conto del segno:
Il coefficiente di correlazione ρx𝓏=Cov(X,Z)/(σxσ𝓏) è adimensionale ed è compreso tra −1 e 1. Una correlazione nulla esclude un'associazione lineare, ma non ogni dipendenza non lineare. L'indipendenza implica covarianza nulla quando i momenti esistono, ma una covarianza nulla non implica generalmente indipendenza. Per esempio, una variabile casuale X simmetrica attorno a zero e il suo quadrato X2 possono essere incorrelati, quando i momenti necessari esistono, anche se X2 è completamente determinato da X.
La varianza di una somma è
Se la covarianza è negativa, combinare variabili può ridurre il rischio. Questo è il fondamento statistico della diversificazione di portafoglio; variabili indipendenti hanno covarianza nulla, ma la formula utile della varianza non richiede di per sé l'indipendenza.
Aspettative condizionate e legge delle aspettative iterate
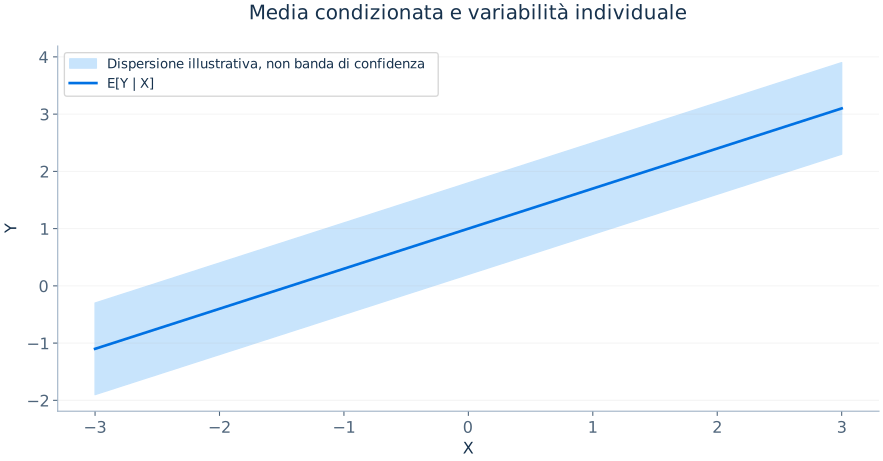
L'aspettativa condizionata E[Y|X=x] è il valore medio di Y tra le osservazioni con X=x nella distribuzione della popolazione. È una funzione di x, non una costante. Nella relazione tra reddito e consumo, descrive il consumo medio a diversi livelli di reddito. La funzione di aspettativa condizionata (CEF) è la relazione media non vincolata, mentre una regressione lineare approssima tale relazione mediante una combinazione lineare di regressori.
La legge delle aspettative iterate stabilisce che
La media complessiva può essere ottenuta calcolando dapprima la media di Y nei gruppi definiti da X e poi la media di tali medie di gruppo usando le probabilità dei gruppi nella popolazione. Definiamo ε=Y−E[Y|X]. Per costruzione E[ε|X]=0 ed ε è incorrelato con ogni funzione integrabile di X. Questa scomposizione esatta non richiede che la CEF sia lineare.
La legge della varianza totale precisa ulteriormente questa scomposizione:
La prima componente misura la variazione delle medie condizionate al variare di X e la seconda misura la variazione media all'interno dei gruppi definiti da X. Ciò aiuta a spiegare l'adattamento della regressione come ripartizione tra variazione prevista e variazione non spiegata.
Indipendenza condizionata
Se Y e D sono condizionatamente indipendenti dato X, conoscere D non aggiunge informazioni sulla distribuzione di Y una volta noto X. Per l'inferenza causale, spesso si richiede la condizione più forte che il vettore dei risultati potenziali (Y(0),Y(1)) sia indipendente dal trattamento D condizionatamente ai controlli precedenti al trattamento X. Questa condizione è talvolta chiamata assenza di confondimento o selezione sulle variabili osservabili. È un'ipotesi relativa a controfattuali non osservati, non qualcosa che un elevato R2 della regressione possa dimostrare.
L'indipendenza condizionata non significa che X non abbia alcuna relazione con il trattamento o con il risultato. Il suo scopo è garantire che i confronti a parità di X siano credibili. Per confrontare unità trattate e non trattate con caratteristiche simili serve anche la sovrapposizione, ossia 0<P(D=1|X=x)<1 per i valori studiati. Se un certo sottogruppo è sempre trattato, i suoi risultati controfattuali in assenza di trattamento non possono essere ricostruiti in modo non parametrico dal campione osservato.
Campionamento casuale e statistiche descrittive
Con un campionamento indipendente e identicamente distribuito, ogni osservazione segue la stessa distribuzione della popolazione ed è indipendente dalle altre. La media campionaria e la consueta varianza campionaria non distorta sono
L'errore standard della media campionaria è σ/√n quando σ è noto e il campionamento è indipendente; s/√n ne fornisce una stima nelle applicazioni ordinarie. Il fattore √n è centrale: quadruplicare un campione indipendente di norma dimezza l'errore standard. La distorsione sistematica, invece, generalmente non scompare per il solo aumento di n.
Distribuzioni di probabilità utilizzate nell'inferenza
Una variabile distribuita normalmente è simmetrica ed è completamente descritta dalla sua media e dalla sua varianza. Se Z è normale standard, P(|Z|≤1.96)≈0.95. La distribuzione χ2 deriva da somme di quadrati di variabili normali standard. La distribuzione t di Student deriva dalla divisione di una quantità normale per una deviazione standard stimata indipendente, e i gradi di libertà influenzano lo spessore delle code. La distribuzione F è il rapporto tra variabili χ2 indipendenti opportunamente scalate e compare nei test di più restrizioni lineari.
Queste distribuzioni sono importanti perché le procedure di verifica delle ipotesi richiedono affermazioni sul comportamento campionario degli stimatori. La validità di una distribuzione t o F esatta dipende da ipotesi più forti di quelle necessarie per un'approssimazione normale in grandi campioni.
Legge dei grandi numeri e teorema del limite centrale
La legge debole dei grandi numeri (LLN) stabilisce la convergenza della media campionaria verso la media della popolazione in presenza di opportune condizioni di campionamento e sui momenti. Il teorema del limite centrale (CLT) caratterizza la distribuzione campionaria dei suoi scostamenti. Per osservazioni indipendenti con varianza finita,
La freccia indica la convergenza in distribuzione. La LLN spiega perché la stima diventi accurata al crescere di n; il CLT spiega come si possa quantificare la sua incertezza. Una distribuzione campionaria di forma normale non significa che salari, redditi individuali o profitti delle imprese seguano distribuzioni normali.
Regola di Bayes e condizionamento rispetto a eventi
La regola di Bayes è un metodo sistematico per aggiornare una probabilità dopo aver ricevuto nuove informazioni. Per eventi A e B con P(B)>0,
Supponiamo che il 4% delle imprese di un settore risulti insolvente nel corso dell'anno. Un indicatore di valutazione preliminare è positivo per l'80% delle imprese che diventeranno insolventi e per il 15% delle imprese che non lo diventeranno. La probabilità di un segnale positivo è 0.80×0.04+0.15×0.96=0.176. La probabilità di insolvenza dato un segnale positivo è 0.032/0.176≈0.182, ossia 18.2%. Il segnale identifica un rischio più elevato, ma non implica una probabilità di insolvenza dell'80%. Questa distinzione mostra l'importanza economica delle frequenze di base per l'analisi del rischio di credito e per i modelli di classificazione.
Le probabilità condizionate si estendono alle variabili continue mediante le densità condizionate. Per Y e X continue dotate di densità congiunta, f(y|x)=f(x,y)/fx(x) dove fx(x)>0. La media condizionata E[Y|X=x] integra y rispetto a questa densità condizionata. Una regressione modella alcuni aspetti di tale distribuzione condizionata, non l'intera distribuzione congiunta, a meno che non vengano imposte ulteriori ipotesi statistiche.
Disuguaglianza di Jensen, utilità attesa e trasformazioni logaritmiche
Per una funzione concava h, la disuguaglianza di Jensen implica E[h(X)]≤h(E[X]) in condizioni appropriate; la disuguaglianza si inverte per funzioni convesse. Poiché ln è concava, E[ln Y]≤ln(E[Y]) per Y positivo. Questo spiega perché la media del logaritmo del reddito non sia il logaritmo del reddito medio. La distinzione è rilevante anche per interpretare le regressioni logaritmiche stimate e per distinguere tra variazioni proporzionali medie e variazioni di una media aritmetica.
Nella teoria economica delle decisioni, la concavità dell'utilità genera avversione al rischio: l'utilità della ricchezza attesa può superare l'utilità attesa di una ricchezza rischiosa. Dal punto di vista econometrico, applicare trasformazioni alla variabile di risultato modifica la funzione di perdita e la quantità la cui aspettativa condizionata viene approssimata dalla regressione. Un modello del logaritmo dei salari non è semplicemente un espediente numerico equivalente a un modello dei salari.
La covarianza delle medie campionarie in presenza di dipendenza
Per osservazioni indipendenti e identicamente distribuite, Var(Ȳ)=σ2/n. In assenza di indipendenza, la varianza della media è
I termini di covarianza incrociata si annullano in presenza di indipendenza, ma non necessariamente per studenti della stessa classe o per osservazioni ripetute di una stessa impresa. Questa identità è la ragione elementare per cui il raggruppamento delle osservazioni e la correlazione seriale influenzano gli errori standard. Se l'errore di ogni studente include lo stesso shock di classe, la quantità effettiva di informazione può essere molto più vicina al numero di classi che al numero totale di studenti.