
16. Contrazione dei coefficienti, Big Data e previsione regolarizzata
Ridge, Lasso, validazione incrociata e componenti principali
Previsione con numerosi regressori potenziali
Il numero dei predittori disponibili può diventare elevato rispetto al numero di osservazioni. Campagne pubblicitarie, acquisti dei consumatori e previsioni macroeconomiche possono essere descritti da centinaia di covariate e ritardi. Una regressione OLS non vincolata può adattarsi estremamente bene ai dati di addestramento e tuttavia produrre risultati scadenti fuori campione, perché i suoi coefficienti rispondono al rumore campionario. La regolarizzazione introduce deliberatamente una distorsione per ridurre la varianza e, potenzialmente, migliorare la previsione.
Un modello predittivo e un modello causale vengono giudicati con criteri differenti. Un predittore utile non deve necessariamente causare un esito: può essere semplicemente un segnale anticipatore o correlato. Per esempio, le ricerche sul web possono aiutare a prevedere le vendite senza essere una determinante del consumo su cui sia possibile intervenire. Una stima causale ben progettata richiede invece un confronto controfattuale difendibile, spesso con un insieme di variabili di controllo strutturato con attenzione.
Il compromesso tra distorsione e varianza
Per una nuova osservazione con covariate X0, una stima predittiva ŷ(X0) presenta, sotto un opportuno condizionamento, un errore quadratico medio composto dal quadrato della distorsione, dalla varianza e dal rumore irriducibile dell’esito. Aumentare la flessibilità del modello può ridurre la distorsione di approssimazione, ma accrescere la varianza di stima. Un modello molto complicato può catturare schemi specifici del campione di addestramento che non si ripresentano nelle nuove osservazioni. La contrazione dei coefficienti mira a controllare questo compromesso.
Regressione ridge
La regressione ridge minimizza la funzione di perdita OLS aggiungendo una penalizzazione basata sui coefficienti al quadrato:
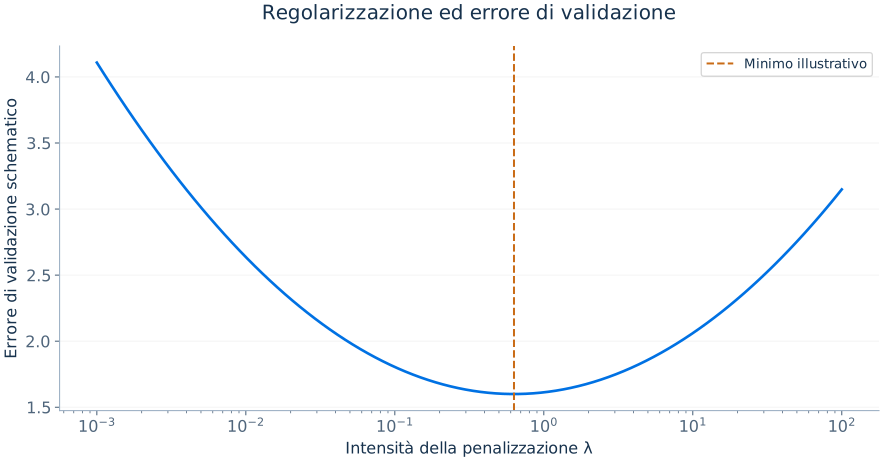
L’intercetta viene normalmente lasciata senza penalizzazione e le variabili esplicative vengono standardizzate prima della stima. Il parametro di regolazione λ≥0 controlla l’intensità della contrazione: λ=0 restituisce OLS in presenza di rango pieno; valori più elevati di λ spostano i coefficienti verso zero. Per X e Y centrati, la forma matriciale è β̂ʳⁱᵈᵍᵉ=(X′X+λI)-1X′y. Ridge stabilizza specificazioni quasi collineari, ma normalmente non rende singoli coefficienti esattamente uguali a zero.
Lasso e modelli sparsi
Lasso sostituisce la penalizzazione quadratica con la penalizzazione dei valori assoluti Σ|βj|, permettendo di selezionare le variabili mediante coefficienti esattamente nulli. Quando un numero relativamente piccolo di predittori contiene la maggior parte del segnale utile, Lasso può fornire un modello di previsione compatto. Non è automaticamente superiore a ridge: blocchi di variabili predittive altamente correlate possono portare a una selezione instabile, mentre ridge può distribuire il peso dei coefficienti in modo più uniforme. Elastic net combina penalizzazioni L1 e L2 e può essere utile in presenza di numerosi predittori correlati.
Il parametro di regolazione non viene stimato a partire dalle normali statistiche t di OLS. Viene comunemente scelto per minimizzare la perdita predittiva nella validazione incrociata. Scegliere sia le trasformazioni delle variabili sia la penalizzazione controllando ripetutamente lo stesso campione di test contamina la valutazione. Un vero insieme di dati tenuto da parte deve rimanere inutilizzato fino alla valutazione finale.
Validazione incrociata a K gruppi
Si divide il campione di addestramento in K gruppi. Per ogni valore candidato di λ, si stima il modello su K−1 gruppi e si prevedono le osservazioni del gruppo escluso. Si calcola la media delle perdite sui gruppi esclusi e si sceglie una penalizzazione con prestazioni soddisfacenti nella validazione incrociata. Infine, si ristima il modello sull’intero campione di addestramento e lo si valuta una sola volta su un insieme di test mai utilizzato. Una validazione annidata o una fase separata di validazione può essere utile quando si confrontano molti iperparametri e famiglie di modelli.
Componenti principali
L’analisi delle componenti principali trasforma un vettore di regressori correlati in combinazioni lineari ortogonali, ordinate in base alla quantità di varianza dei predittori che spiegano. Se la matrice dei dati standardizzati è X, le direzioni delle componenti principali risolvono un problema di autovettori per X′X o per la corrispondente matrice di covarianza. Un modello predittivo può regredire Y su un numero limitato delle prime componenti. Questo può ridurre la dimensionalità, ma le componenti che spiegano la maggior parte della variabilità di X non spiegano necessariamente la maggior parte di quella di Y: il numero di componenti va quindi scelto in funzione del compito predittivo.
Previsione di serie storiche con numerosi predittori
La previsione macroeconomica può impiegare molte serie correlate, come occupazione, fiducia, produzione, prezzi e indicatori finanziari. I modelli a fattori dinamici assumono che gran parte della loro variabilità congiunta rifletta un numero minore di fattori latenti. Le previsioni basate su fattori possono ridurre la complessità della stima sfruttando un insieme informativo più ampio, ma le revisioni dei dati, i cambiamenti delle relazioni e l’uso improprio di informazioni future complicano la valutazione.
Una semplice implementazione in R
Il seguente esempio schematico presuppone dati completi e predittori numerici con nomi e ordine identici in train e test. Per impostazione predefinita, glmnet standardizza internamente i predittori. In presenza di fattori, la matrice di test va costruita usando i termini, i livelli dei fattori e i contrasti definiti nel campione di addestramento, verificando poi che le colonne siano identiche; due chiamate separate a model.matrix non garantiscono da sole una codifica compatibile. Per confrontare ridge e Lasso si usano le stesse partizioni prestabilite, escludendo gli esiti del campione di test da qualsiasi decisione di taratura.
library(glmnet)
X <- model.matrix(y ~ . - 1, data = train)
y <- train$y
set.seed(2026)
fold_id <- sample(rep(seq_len(10), length.out = nrow(X)))
ridge <- cv.glmnet(X, y, alpha = 0, foldid = fold_id)
lasso <- cv.glmnet(X, y, alpha = 1, foldid = fold_id)
coef(lasso, s = "lambda.min")
newX <- model.matrix(y ~ . - 1, data = test)
stopifnot(identical(colnames(X), colnames(newX)))
pred <- as.numeric(predict(lasso, newx = newX, s = "lambda.min"))
sqrt(mean((test$y - pred)^2))Contrazione ridge e valori singolari
Sia X=UΣV′ la scomposizione ai valori singolari della matrice dei regressori centrata. I minimi quadrati ordinari, nelle sue direzioni principali, moltiplicano le componenti dell’esito per il reciproco dei valori singolari. Quando un valore singolare è molto piccolo, minime oscillazioni dell’esito possono generare grandi variazioni dei coefficienti. Ridge modifica il contributo sostituendo la ponderazione inversa instabile con i fattori σj/(σj2+λ), attenuando le direzioni con scarsa variabilità dei predittori. Questo spiega perché ridge funziona spesso bene con indicatori economici collineari.
La penalizzazione λ deve essere scelta sui dati di addestramento e la valutazione del modello deve utilizzare osservazioni realmente nuove. L’inferenza sui singoli coefficienti ridge o Lasso non si ottiene leggendo le normali statistiche t di OLS da un modello selezionato: la distorsione introdotta dalla regolarizzazione e la fase di selezione richiedono metodi specifici.
Scegliere gli strumenti di previsione per un compito specifico
Usa OLS semplice quando i predittori sono pochi, le relazioni sono approssimativamente lineari e l’estrapolazione o l’interpretazione sono importanti. Considera ridge quando molti predittori sono correlati e la previsione conta più della selezione delle variabili. Considera Lasso quando è plausibile una rappresentazione predittiva sparsa e una specificazione compatta è utile. Le componenti principali possono aiutare quando molti indicatori condividono pochi fattori latenti; i modelli a fattori dinamici estendono questa intuizione ai panel macroeconomici con dipendenza temporale.