
6. Non linearità, logaritmi e interazioni
Medie condizionate flessibili con coefficienti che restano interpretabili
Linearità nei parametri e linearità nei regressori
La formula classica dei minimi quadrati stima modelli lineari nei coefficienti incogniti, non necessariamente lineari nelle variabili originarie dei dati. Un modello con X2, log(X), un'interazione del trattamento o indicatori annuali rimane lineare nei parametri se questi regressori trasformati entrano in modo additivo con coefficienti lineari. Viceversa, Y=exp(β0+β1X)+u è non lineare nei parametri e non può essere stimato nella forma scritta mediante i normali minimi quadrati lineari senza modificare il modello e le ipotesi sugli errori.
Le scelte di forma funzionale impongono affermazioni sostanziali sugli effetti marginali. Aggiungere un polinomio non è un espediente puramente estetico: significa ammettere che la relazione possa curvarsi in modo sistematico. Utilizzare i logaritmi può creare un'interpretazione in termini di effetti proporzionali, gestire una forte asimmetria ed esprimere elasticità economiche. Il modello deve comunque essere verificato rispetto alla plausibilità delle previsioni, alle osservazioni influenti e alle nuove restrizioni imposte dalla trasformazione scelta.
I principali modelli logaritmici
Per Y e X positive, sono utili quattro forme comuni. Livello–livello: Y=β0+β1X+u presenta una variazione marginale costante di Y pari a β1 unità. Log–livello: ln(Y)=β0+β1X+u presenta una variazione approssimata di Y del 100β1 per cento per unità di X. Livello–log: Y=β0+β1ln(X)+u presenta una variazione approssimata di Y pari a β1/100 unità per un aumento dell'1% di X. Log–log: ln(Y)=β0+β1ln(X)+u ha elasticità costante β1, per cui un aumento dell'1% di X corrisponde a una differenza di Y approssimativamente pari a β1%.
| Forma | Specificazione | Significato del coefficiente |
|---|---|---|
| Livello–livello | Y = β0 + β1X + u | Unità di Y per unità di X |
| Log–livello | ln Y = β0 + β1X + u | ≈ 100β1 % di Y per unità di X |
| Livello–log | Y = β0 + β1ln X + u | ≈ β1/100 unità di Y per 1% di X |
| Log–log | ln Y = β0 + β1ln X + u | Elasticità esatta del predittore logaritmico esponenziato: β1 |
Quando la variabile dipendente è espressa in logaritmi, esponenziare la media condizionata stimata di ln(Y) non riproduce generalmente E[Y|X]. La disuguaglianza di Jensen implica che E[exp(log Y)|X] non sia semplicemente exp(E[log Y|X]). Le previsioni nelle unità originarie possono richiedere una correzione di ritrasformazione o di smearing, soprattutto in presenza di residui logaritmici eteroschedastici.
Termini quadratici e di ordine superiore
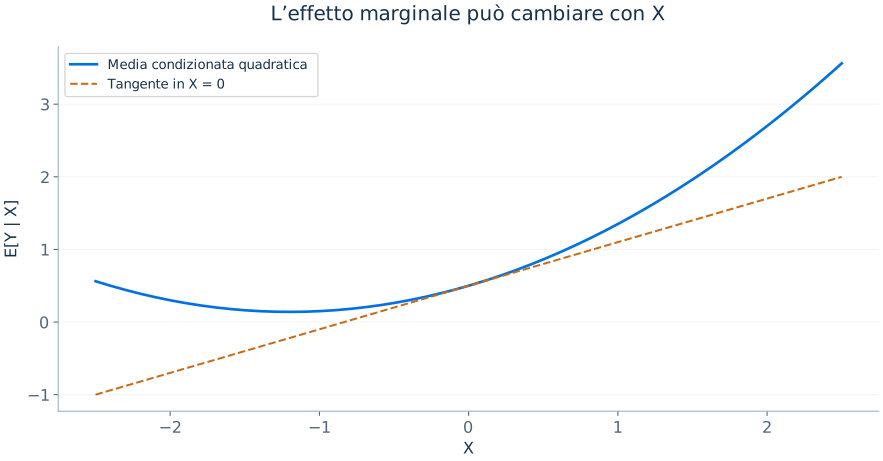
Una specificazione quadratica è
Il suo effetto marginale è β1+2β2X. Se β2<0, la funzione è concava e un β1 positivo può infine tradursi in un effetto marginale negativo. Il punto di inversione è X*=−β1/(2β2), se β2≠0. Prima di interpretarlo economicamente, occorre indicare se questo punto ricade nell'intervallo dei dati osservati. Polinomi di grado arbitrariamente elevato possono adattarsi eccessivamente al campione, oscillare bruscamente vicino ai limiti e offrire estrapolazioni poco attendibili.
Interazioni tra due regressori continui
Sia E[Y|X,Z]=β0+β1X+β2Z+β3XZ. Mantenendo Z costante, l'effetto marginale di X è
Il coefficiente di X descrive il suo effetto per Z=0, che potrebbe trovarsi fuori dall'intervallo di interesse sostanziale. Centrare Z attorno alla sua media fa sì che β1 si riferisca al livello medio osservato di Z, migliorandone l'interpretabilità. Il coefficiente dell'interazione misura come cambia l'effetto marginale di X per un aumento unitario di Z; la sua incertezza campionaria e la covarianza tra le stime contano nel calcolo degli errori standard di uno specifico effetto marginale.
Interazioni binaria × continua e binaria × binaria
Il modello E[Y|D,X]=β0+β1D+β2X+β3(DX) permette coefficienti angolari diversi nel gruppo trattato e in quello non trattato. Per D=0 il coefficiente angolare rispetto a X è β2; per D=1 è β2+β3. Il confronto tra trattamento e controllo per X=x è β1+β3x, non semplicemente β1. L'errore standard di questo confronto utilizza Var(β̂1)+x2Var(β̂3)+2xCov(β̂1,β̂3).
Con due variabili binarie A e B, aggiungere A×B permette al gruppo che possiede entrambe le caratteristiche di differire dalla somma dei loro effetti principali separati. In un modello con due indicatori binari e tutte le interazioni, le medie stimate coincidono con le quattro medie specifiche dei gruppi. Questo è un esempio di modello lineare saturo. La stessa algebra è alla base della più semplice specificazione delle differenze nelle differenze discussa nel capitolo sui dati panel.
Regressione flessibile e interpretazione parziale
Un modello statistico può approssimare in modo flessibile la media condizionata senza identificare un meccanismo causale. Aggiungere molte trasformazioni non elimina i fattori confondenti omessi o l'endogeneità. Una regressione non lineare stimata richiede inoltre di valutare l'effetto marginale rilevante in corrispondenza di valori economicamente appropriati, accompagnandolo con intervalli di incertezza, anziché dichiarare che il coefficiente del termine originario rappresenti l'intero effetto.
La formula multivariata dell'effetto marginale
Per una media condizionata regolare m(x)=E[Y|X=x], l'effetto marginale di Xj è ∂m(x)/∂xj. Per un trattamento discreto o binario, le derivate possono essere inappropriate; è invece opportuno calcolare la variazione del risultato previsto tra gli stati del trattamento, mantenendo costanti le altre covariate. Gli effetti marginali medi sono la media degli effetti parziali specifici delle singole unità nel campione osservato; gli effetti marginali in corrispondenza della media valutano una funzione non lineare in un particolare vettore artificiale di covariate. Queste quantità differiscono perché, in generale, applicare una funzione non lineare e calcolare una media non sono operazioni intercambiabili.
Se m(X)=β0+β1X+β2X2, la derivata β1+2β2X è specifica dell'individuo. In questo caso quadratico l'effetto marginale medio è β1+2β2X̄, ma funzioni più complesse possono richiedere di calcolare gli effetti per tutte le osservazioni e poi farne la media. Quando i modelli contengono più covariate interagite, occorre indicare esattamente quali vengano mantenute costanti e in quale punto sia valutata la derivata.
Inferenza per punti di inversione ed elasticità
Il punto di inversione di una funzione quadratica, X*=−β1/(2β2), è un rapporto tra coefficienti stimati. Se β2 è stimato con scarsa precisione vicino a zero, questo rapporto può avere una distribuzione fortemente asimmetrica; il metodo delta standard può risultare inaffidabile. Un grafico della funzione stimata con bande di confidenza spesso comunica l'incertezza in modo più responsabile rispetto a un singolo valore del punto di inversione. Per un effetto previsto L(β̂) che coinvolge più coefficienti, occorre incorporare l'intera matrice di covarianza stimata.
Consideriamo un modello log–log con coefficiente angolare stimato pari a 0.75 ed errore standard robusto 0.12. Un semplice intervallo al 95% per l'elasticità è approssimativamente 0.75±1.96(0.12), ossia (0.515,0.985). Questo intervallo caratterizza l'incertezza campionaria del coefficiente nell'ambito del modello, non stabilisce se una variazione di prezzo indotta da una politica abbia lo stesso effetto di un'associazione storica di mercato.
Dalle previsioni logaritmiche agli esiti nelle unità originali
Un modello stimato in logaritmi descrive m(x)=E[ln(Y)|X=x]. Il suo esponenziale exp(m(x)) è una media geometrica condizionale ed è una mediana condizionale quando il disturbo logaritmico ha mediana condizionale zero. Per ottenere la media aritmetica condizionale, si scrive Y=exp(m(X))exp(u) e si calcola la media del secondo fattore condizionatamente a X. La correzione risultante può variare con i valori delle covariate; la sola esponenziazione generalmente sottostima la media condizionale.
Se u condizionatamente a X è normale con varianza costante σ2, la correzione è exp(σ2/2). Con una distribuzione dell’errore costante, ma senza normalità, una stima mediante smearing usa la media campionaria di exp(ûi). Un unico fattore globale di smearing è generalmente insufficiente quando la distribuzione di u varia con X. Per esempio, se m(x)=2 e σ2=0,25, exp(2) è circa 7,39, mentre la media condizionale è exp(2,125), circa 8,37. Nei confronti moltiplicativi tra due valori delle covariate, la correzione si semplifica soltanto se è identica nei due casi.
Esiti binari: probabilità lineare, logit e probit
Per un esito binario, la media condizionale è una probabilità. Un modello di probabilità lineare usa p(x)=x′β e interpreta un coefficiente di 0,04 come una variazione di quattro punti percentuali, mantenendo fissi gli altri regressori. Il modello è semplice, ma può prevedere valori inferiori a zero o superiori a uno e la sua varianza dell’errore p(x)[1−p(x)] è generalmente eterogenea.
Il logit usa la funzione di distribuzione logistica Λ e il probit usa la funzione di distribuzione normale standard Φ. Entrambi mantengono le probabilità stimate tra zero e uno. Con osservazioni indipendenti, la massima verosimiglianza sceglie i coefficienti che massimizzano la log-verosimiglianza di Bernoulli riportata sotto, dove pi è la probabilità stimata e yi è zero oppure uno. Un coefficiente logit descrive una variazione del logaritmo degli odds, non una variazione in punti percentuali. Per un regressore continuo non trasformato e privo di interazioni, l’effetto marginale sulla probabilità è βjpi(1−pi); l’analogo probit è βjφ(xi′β), dove φ è la densità normale standard. Per i regressori binari, si confrontano le probabilità previste impostando il regressore a zero e a uno, calcolando la media delle differenze se l’oggetto della stima è un effetto medio. Anche questi modelli richiedono un’argomentazione credibile di identificazione per sostenere conclusioni causali.
| Modello | Funzione di probabilità | Interpretazione principale |
|---|---|---|
| Probabilità lineare | x′β | Pendenza in unità di probabilità; usare una matrice di covarianza robusta appropriata |
| Logit | Λ(x′β) | Pendenza nel logaritmo degli odds; calcolare differenze di probabilità |
| Probit | Φ(x′β) | Pendenza nell’indice normale; calcolare differenze di probabilità |