
15. Dati panel, differenze prime ed effetti fissi
Usare la variazione interna alle unità per controllare l’eterogeneità invariata nel tempo
Perché i panel modificano il problema di identificazione
Le regressioni trasversali confrontano individui, imprese o regioni differenti. Se le unità possiedono caratteristiche persistenti ma non osservate, come capacità manageriale, qualità istituzionale o preferenze consolidate, questi fattori possono confondere le associazioni trasversali. I dati panel osservano ripetutamente le stesse unità e permettono di rimuovere le caratteristiche non osservate fisse mediante confronti interni a ciascuna unità. Questo vantaggio comporta nuove ipotesi sui fattori confondenti variabili nel tempo e sulla dipendenza all’interno delle unità.
Il modello canonico a effetti fissi additivi è
Qui αi è un effetto dell’unità invariato nel tempo, λt è un effetto temporale comune alle unità e uit è la componente residua di disturbo variabile nel tempo. Il coefficiente β è identificato dalle variazioni di X interne a ciascuna unità, dopo aver corretto per gli shock temporali comuni, sotto le ipotesi di esogeneità pertinenti. Per una variabile che non cambia mai all’interno di un individuo non è possibile identificare separatamente un proprio coefficiente in un modello con effetti fissi individuali non vincolati.
Differenziazione prima con due periodi
Con due periodi, si parte da Yi1=αi+βXi1+ui1 e Yi2=αi+βXi2+ui2. Sottraendo la prima equazione dalla seconda:
La componente non osservata αi scompare esattamente. OLS sulle differenze stima β in modo consistente quando le variazioni di X sono opportunamente esogene rispetto alle variazioni del disturbo. Non è necessario che una caratteristica individuale non osservata costante sia incorrelata con X in livelli: questo è il principale vantaggio del metodo.
Tuttavia, la differenziazione prima non elimina i fattori non osservati che variano nel tempo. Se un’impresa modifica gli investimenti perché uno shock di domanda non registrato aumenta le vendite attese, quello shock può influenzare sia ΔX sia ΔY. Anche l’errore di misurazione può diventare più importante dopo la differenziazione, perché il segnale di una variabile persistente si riduce mentre il rumore di misurazione rimane.
Stima a effetti fissi mediante trasformazione within
Con più di due periodi, si calcola la media temporale di ciascun individuo. Il modello Yit=αi+βXit+uit implica Ȳi=αi+βX̄i+ūi. Si sottrae l’equazione delle medie da ciascun periodo:
OLS su questi dati depurati delle rispettive medie stima il coefficiente basato sulla variazione interna alle unità. Uno stimatore equivalente dei minimi quadrati con variabili dummy include un’intercetta per ciascuna unità, salvo una categoria di riferimento omessa, quando ciò è praticabile. Entrambi gli stimatori eliminano αi additivo e invariato nel tempo e producono lo stesso coefficiente a parità di specificazione.
L’ipotesi standard per il modello statico a effetti fissi è spesso l’esogeneità stretta: E[uit|Xi1,…,Xit,…,XiT,αi]=0 per ogni t. Richiede che ciascun disturbo uit abbia media zero condizionatamente all’intera storia dei regressori, compresi i valori futuri di X. In particolare, esclude meccanismi di retroazione in cui uno shock odierno modifica il regressore del periodo successivo; è più forte dell’esogeneità sequenziale talvolta impiegata nei modelli dinamici di serie storiche. La presenza di una variabile dipendente ritardata insieme agli effetti fissi crea ulteriori complicazioni nei panel brevi.
Effetti fissi delle unità e del tempo
L’aggiunta di λt corregge per shock o tendenze comuni che interessano tutte le unità. Una regressione a effetti fissi a due vie, con dummy delle unità e del tempo, è
In assenza di altri controlli, β confronta le variazioni interne alle unità con le corrispondenti variazioni nelle altre unità che contribuiscono all’identificazione della regressione. Gli effetti fissi a due vie possono essere un’utile strategia di controllo descrittivo, ma in presenza di adozione scaglionata delle politiche ed effetti dinamici eterogenei del trattamento, il coefficiente non coincide necessariamente con una media ponderata trasparente e convessa degli effetti del trattamento. Per questi disegni possono essere preferibili metodi moderni delle differenze nelle differenze.
Differenze nelle differenze
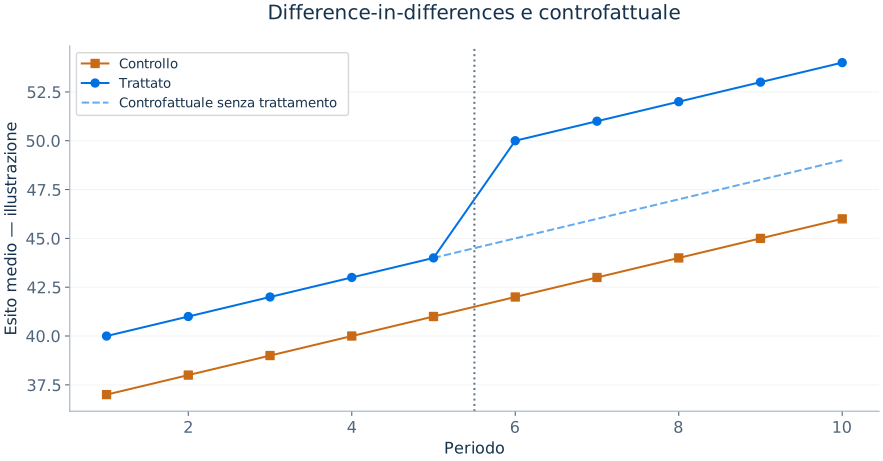
Con unità trattate e di controllo osservate prima e dopo una politica, lo stimatore DID di base è
L’ipotesi fondamentale delle tendenze parallele afferma che, in assenza di trattamento, le unità trattate e quelle di controllo avrebbero sperimentato la stessa variazione attesa dell’esito nel periodo di confronto. Questa ipotesi riguarda variazioni controfattuali non osservate; le tendenze precedenti alla politica possono fornire evidenze utili, ma non possono dimostrare logicamente l’ipotesi controfattuale per il periodo successivo alla politica.
Effetti casuali ed effetti casuali correlati
Un modello convenzionale a effetti casuali considera l’effetto individuale incorrelato con le variabili esplicative, consentendo una combinazione ponderata delle informazioni interne alle unità e tra unità. Quando questa esogeneità è valida, RE può essere più efficiente di FE. Quando αi è correlato con X, il modello RE standard può essere inconsistente, mentre FE può restare consistente sotto le proprie ipotesi. Una specificazione a effetti casuali correlati, o di Mundlak, include le medie per unità dei regressori variabili nel tempo per modellare la dipendenza tra αi e X. Queste formulazioni possono collegare FE e RE e fornire parametri aggiuntivi significativi in determinati contesti.
La scelta del modello non si risolve esclusivamente mediante un test di Hausman applicato meccanicamente. Meritano attenzione le ipotesi, gli effetti di interesse, la rilevanza dei regressori invarianti nel tempo e la struttura dei raggruppamenti.
Correlazione seriale e inferenza per cluster
Le osservazioni della stessa unità nel tempo sono raramente indipendenti. Una regressione FE richiede normalmente errori standard raggruppati per unità, nell’ambito di un’approssimazione asintotica basata su un elevato numero di cluster e sotto ipotesi di indipendenza tra cluster. Se gli shock sono anche correlati tra unità nella stessa data, la dipendenza può richiedere ulteriori correzioni o una diversa strategia inferenziale. Spesso è possibile stimare modelli su panel non bilanciati, ma l’uscita dal campione collegata a esiti potenziali non osservati può influenzarne l’interpretazione.
library(fixest)
fe <- feols(y ~ x1 + x2 | firm_id + year, data = dat,
            vcov = ~ firm_id)
summary(fe)
# A DID specification when policy adopts at a common date:
did <- feols(y ~ treated:post | firm_id + year,
             data = dat, vcov = ~ firm_id)
summary(did)Un esempio della trasformazione a effetti fissi
Supponiamo di osservare due regioni per tre anni e che il ricercatore voglia stimare la relazione tra presenza della polizia e criminalità. La prima regione ha un livello di criminalità di base permanentemente più elevato a causa di condizioni storiche non misurate; la seconda ha un livello di base permanentemente più basso. Una regressione pooled può confondere queste differenze fisse con la presenza della polizia se anche le risorse delle forze dell’ordine sono sistematicamente maggiori nella prima regione. Gli effetti fissi regionali sottraggono dagli esiti e dai regressori la media di ciascuna regione, lasciando soltanto gli scostamenti interni a quella regione nel tempo.
Questa procedura non rende esogeno un aumento della presenza della polizia. Se una regione assume altri agenti in previsione di un’ondata di criminalità, la variazione interna alla regione può essere ancora correlata con lo shock imminente non osservato. Una fonte di identificazione più solida potrebbe essere una formula di finanziamento, uno shock predeterminato negli organici o un altro cambiamento di politica motivato dall’esterno. Gli effetti fissi rimuovono il confondimento fisso, non la risposta della politica alle condizioni economiche e sociali.
Raggruppamenti e informazione effettiva nei panel
Le osservazioni ripetute sulla stessa regione o impresa condividono influenze non osservate, perciò una regressione con migliaia di righe impresa-anno ma soltanto 20 imprese può contenere meno informazione indipendente di quanto suggerisca il numero grezzo di righe. Il livello di raggruppamento deve riflettere i meccanismi di assegnazione e degli shock. Se una riforma viene assegnata a livello regionale, raggruppare a livello del singolo lavoratore è normalmente inadeguato, perché la variazione del trattamento e gli shock condivisi si verificano a livello regionale. Se gli shock regionali e annuali presentano entrambi una dipendenza complessa, può essere necessaria un’inferenza più sofisticata.
Momento del trattamento, effetti per coorte e confronti nel tempo relativo
Sia Gi il primo periodo nel quale l’unità i riceve il trattamento. L’effetto gruppo-periodo ATT(g,t) confronta l’esito medio alla data t della coorte trattata per la prima volta in g con il suo esito controfattuale se fosse rimasta non trattata. Questo oggetto di stima permette all’effetto di variare tra coorti e con la durata dell’esposizione. L’identificazione richiede un’appropriata ipotesi di trend paralleli, assenza di anticipazione nella finestra specificata, adeguato supporto comune e un gruppo di confronto non trattato.
Per esempio, una coorte trattata nel 2023 può essere confrontata nel 2024 con unità ancora non trattate nel 2024, se queste forniscono un controfattuale credibile. Le unità trattate nel 2022 sono già esposte; usarle come controlli può sottrarre l’evoluzione dei loro effetti del trattamento. Gli stimatori per coorte e periodo rendono esplicito questo confronto prima dell’aggregazione. Il tempo relativo e=t−g misura la durata dall’adozione, mentre il tempo di calendario t colloca gli shock comuni. L’aggregazione deve dichiarare i pesi delle coorti e quali coorti restano osservate a ogni orizzonte. Il mancato rifiuto delle differenze anteriori al trattamento sostiene una verifica diagnostica limitata; non dimostra l’esistenza di trend controfattuali paralleli dopo il trattamento.