
5. Regressione multipla ed effetti parziali
Interpretazione ceteris paribus, struttura della regressione e multicollinearità
Perché è necessaria la regressione multipla
I risultati economici raramente rispondono a una sola determinante osservata. I lavoratori con maggiore istruzione tendono a differire anche per esperienza, settore, localizzazione e condizioni familiari. Una regressione dei salari sulla sola istruzione incorpora nello stesso coefficiente angolare tutte le dimensioni correlate con l'istruzione. La regressione multipla cerca di descrivere l'associazione tra salari e istruzione mantenendo costanti alcune altre caratteristiche selezionate. Scriviamo
Qui ogni βj descrive il cambiamento nel predittore lineare condizionato di Y associato a un aumento unitario di Xj, mantenendo costanti gli altri regressori. Questa espressione interpreta un confronto matematico condizionato; non garantisce che tale confronto sia realizzabile nella popolazione osservata o che βj rappresenti un effetto causale.
Per esempio, supponiamo che il reddito annuo da lavoro sia legato a istruzione, esperienza e settore. Il coefficiente dell'istruzione in questo modello si riferisce a lavoratori con uguale esperienza inclusa nel modello e uguale settore. Se le capacità non sono misurate e influenzano sia l'istruzione sia il reddito, il coefficiente dell'istruzione può comunque essere distorto. Aggiungere variabili non è sempre meglio: condizionare sui mediatori di un effetto o sui collider può creare nuove distorsioni anziché eliminare il confondimento.
Come l'OLS risolve il problema della regressione multipla
Lo stimatore OLS minimizza la somma dei quadrati dei residui rispetto a tutti i k+1 coefficienti. Con una matrice dei regressori X di dimensione n×(k+1), un vettore y di n elementi e un vettore dei coefficienti β, il modello e la funzione obiettivo dei minimi quadrati possono essere scritti come
Derivando si ottengono le equazioni normali X′Xβ̂=X′y. Se X ha rango pieno per colonne, la soluzione unica è
La matrice X′X rappresenta la variabilità e le correlazioni tra i regressori; X′y rappresenta la loro covariazione con Y. Il rango pieno per colonne esclude dipendenze lineari esatte e richiede un numero di righe almeno pari a quello dei parametri. Per avere gradi di libertà residui positivi occorre inoltre n>k+1; l’indipendenza statistica è un’ipotesi distinta sul campionamento. Il rango pieno non richiede che le variabili esplicative siano tra loro incorrelate: i coefficienti di regressori fortemente correlati sono stimabili, sebbene con minore precisione.
La matrice di proiezione Px = X(X′X)-1X′ soddisfa ŷ=Pxy, mentre i residui sono û=(I−Px)y. La proiezione rende il vettore dei residui ortogonale a ogni regressore incluso, X′û=0. Queste espressioni mostrano l'interpretazione geometrica dell'OLS come proiezione sullo spazio generato dalle colonne di X.
Il teorema di Frisch–Waugh–Lovell
Il teorema di Frisch–Waugh–Lovell (FWL) offre una procedura intuitiva per comprendere β̂1. Prima si regredisce X1 su tutte le altre variabili esplicative incluse e si conserva il residuo r1. Poi si regredisce Y sulle stesse altre variabili e si conserva il residuo rᵧ. Infine si regredisce rᵧ su r1 senza aggiungere un'intercetta. Il coefficiente angolare coincide con β̂1 della regressione multipla completa:
Il coefficiente utilizza la variazione di X1 che non può essere prevista linearmente dagli altri regressori. Se l'istruzione è prevista quasi perfettamente dall'età e dai controlli occupazionali, resta poca variazione indipendente per identificarne il coefficiente angolare. Il FWL spiega anche perché aggiungere controlli possa modificare una stima: viene ridefinita la variazione rilevante di X1, non soltanto il numero di gradi di libertà residui.
Per eliminare l'influenza lineare degli altri controlli, è matematicamente corretto ottenere i residui di Y e X1 rispetto a tali controlli. In generale non basta ottenere i residui della sola Y, perché il denominatore e la covarianza devono corrispondere alla variazione depurata di X1. La procedura che utilizza entrambi i residui offre uno strumento diagnostico pratico ed è particolarmente utile nei metodi che correggono per molte componenti accessorie ad alta dimensionalità.
La formula della distorsione da variabile omessa
Supponiamo che il vero modello condizionato includa sia X sia Z:
Se Z viene omessa, il coefficiente angolare della regressione semplice di Y su X nella popolazione soddisfa
Questa formula esatta della popolazione isola due elementi: la variabile omessa deve influenzare il risultato (β2≠0) ed essere correlata con il regressore incluso (Cov(X,Z)≠0). Il segno della distorsione è il prodotto di questi due segni. Se le capacità aumentano il reddito da lavoro e sono positivamente associate all'istruzione, ometterle tende a distorcere verso l'alto l'associazione osservata con l'istruzione, anche se il segno e la dimensione della distorsione effettiva dovuta alle capacità sono questioni empiriche.
La formula si generalizza alla regressione multipla: si sostituisce X con il suo residuo dopo la proiezione sugli altri controlli inclusi e si misura la covarianza tra questo residuo e la variabile omessa. Una variabile non correlata con il regressore una volta considerati i controlli appropriati non può generare la consueta distorsione da variabile omessa nel suo coefficiente, anche se quella variabile omessa è importante per spiegare Y.
La trappola delle variabili dummy e i regressori qualitativi
Le variabili dummy codificano una caratteristica categoriale. Un modello con intercetta e tre categorie settoriali mutuamente esclusive include normalmente soltanto due dummy, lasciando la terza come categoria di riferimento. Includerle tutte e tre crea multicollinearità esatta perché l'intercetta è la somma dei tre indicatori. La categoria di riferimento omessa non viene ignorata: è rappresentata dall'intercetta e i coefficienti delle dummy incluse confrontano i gruppi con quel gruppo di riferimento, condizionatamente agli altri regressori.
Cambiare la categoria di riferimento modifica i coefficienti delle dummy riportati, ma non i valori stimati. Per una variabile categoriale con più livelli, riportare i risultati medi stimati o confronti espliciti tra coppie di gruppi può essere più informativo che interpretare singolarmente coefficienti riferiti a una categoria base arbitraria.
Multicollinearità e precisione
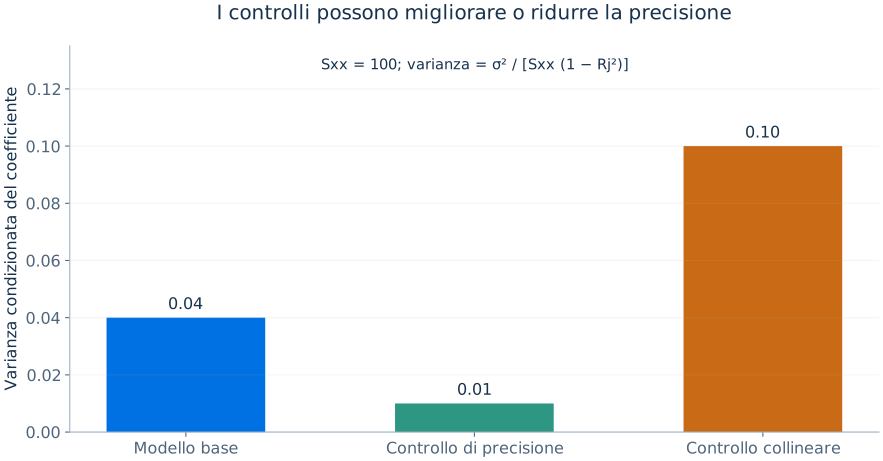
La multicollinearità imperfetta significa che i regressori sono fortemente, ma non perfettamente, legati tra loro. I coefficienti OLS restano calcolabili, ma la loro varianza aumenta perché la variazione residua di uno specifico regressore è limitata. In presenza di omoschedasticità,
dove Rj2 si ottiene regredendo Xj sugli altri regressori. Il fattore di inflazione della varianza VIFj=1/(1−Rj2) riassume l'aumento rispetto al caso di regressori ortogonali. Un VIF elevato segnala minore precisione, non automaticamente distorsione o necessità di eliminare controlli economicamente indispensabili. L'appropriatezza di una variabile deve essere valutata sulla base del disegno di ricerca.
Scala, standardizzazione e interpretazione
La standardizzazione sostituisce un regressore osservato con il suo scarto dalla media campionaria diviso per la propria deviazione standard campionaria. Se sono standardizzati sia Y sia Xj, la pendenza esprime la variazione dell’esito in deviazioni standard associata a un aumento di una deviazione standard di Xj, mantenendo fissi gli altri regressori. Standardizzando soltanto Xj, il coefficiente rimane espresso nelle unità originali di Y per una deviazione standard di Xj. Questi coefficienti possono facilitare il confronto delle associazioni, ma non devono sostituire gli effetti espressi in unità economicamente significative. Il cambiamento di scala e il centramento modificano le intercette e, in presenza di interazioni, alcuni coefficienti di pendenza; non creano identificazione.
Consideriamo il modello stimato log(wage)=β0+β1educ+β2exper+β3exper2+u. L'effetto percentuale previsto di un ulteriore anno di istruzione è approssimativamente 100β1%, mentre la variazione marginale del logaritmo dei salari rispetto all'esperienza è β2+2β3exper e varia con l'esperienza. Riportare il solo β2 come effetto marginale costante è scorretto.
Confondimento, controlli per la precisione e controlli inappropriati
Una distinzione utile separa i controlli che proteggono l'identificazione causale dalle variabili che migliorano principalmente la precisione. Una variabile precedente al trattamento e legata sia al trattamento sia al risultato può ridurre il confondimento quando l'ipotesi di indipendenza condizionata è plausibile. Una variabile iniziale fortemente predittiva del risultato, ma non legata al trattamento casuale, può ridurre la varianza residua e quindi migliorare la precisione. Una variabile successiva al trattamento può invece eliminare parte dell'effetto stesso di interesse e non deve essere inclusa automaticamente. Una buona modellizzazione sceglie i controlli in base alla sequenza temporale economica, alle istituzioni e alla logica causale, anziché applicare una regola universale di inclusione di tutte le variabili.
Per esempio, supponiamo che l'istruzione influenzi l'occupazione, che a sua volta influenza i salari. Quando si cerca l'effetto totale dell'istruzione, controllare per l'occupazione può bloccare un importante percorso causale e produrre un estimando diverso. Se l'occupazione è influenzata anche da fattori non misurati che incidono sui salari, il condizionamento può creare ulteriore distorsione. Un ricercatore interessato all'effetto diretto dell'istruzione non mediato dall'occupazione necessita di un estimando alternativo e di ipotesi più forti, non di una reinterpretazione disinvolta dello stesso coefficiente di regressione.
Interpretare una tabella completa di regressione
Una tabella di regressione interpretata con attenzione riporta le unità dei coefficienti, le variabili esplicative, la numerosità campionaria, R2 o una misura comparabile dell'adattamento, gli eventuali effetti fissi e un'indicazione chiara del metodo per gli errori standard. Quando un coefficiente cambia dopo l'aggiunta di controlli, rimangono possibili diverse spiegazioni: confondimento omesso nella specificazione precedente, cambiamenti nel campione analizzato dovuti a valori mancanti nelle variabili di controllo, modifica della ponderazione implicita nella regressione, interazioni o specificazione funzionale errata. Per isolare l'effetto dei controlli, è opportuno confrontare le specificazioni sullo stesso campione di stima ogni volta che sia possibile.
Il coefficiente di una politica può rimanere quasi costante quando si aggiungono controlli, ma la sola stabilità del coefficiente non verifica l'esogeneità: tutti i modelli potrebbero omettere lo stesso fattore confondente non osservato. Viceversa, i cambiamenti tra specificazioni ben giustificate dovrebbero indurre un approfondimento sostanziale, anziché la selezione meccanica del coefficiente con il p-value più basso.