
3. Stima e inferenza statistica
Distribuzioni campionarie, distorsione, consistenza, efficienza e incertezza
Parametri e stimatori
Un parametro è una caratteristica fissa della distribuzione di una popolazione; uno stimatore è una variabile casuale perché cambia da un campione all'altro. La distorsione di θ̂ è E[θ̂]−θ e la non distorsione significa che il suo valore atteso coincide con il parametro. La consistenza significa che lo stimatore si avvicina in probabilità al parametro al crescere del campione; queste proprietà non sono equivalenti. Uno stimatore può essere distorto nei piccoli campioni e tuttavia consistente, oppure non distorto in determinate condizioni e avere comunque una varianza inaccettabilmente elevata.
L'errore quadratico medio (MSE) combina distorsione e varianza campionaria:
Uno stimatore lievemente distorto può avere un MSE inferiore rispetto a un'alternativa non distorta. Questa è una delle ragioni principali per utilizzare metodi di shrinkage nella previsione. Per la stima causale, tuttavia, occorre distinguere attentamente l'MSE campionario dalla distorsione dovuta all'identificazione: ridurre un coefficiente verso un valore di riferimento non può correggere uno strumento non valido o il confondimento causato da variabili non osservate.
Distribuzione campionaria della media
Per un campione indipendente con varianza finita σ2, E[Ȳ]=μ e Var(Ȳ)=σ2/n. Se le osservazioni sottostanti sono distribuite normalmente, la media campionaria è esattamente normale per qualsiasi n. Altrimenti è spesso approssimativamente normale in campioni sufficientemente grandi, grazie al CLT. Una distribuzione campionaria è una distribuzione concettuale riferita a insiemi di dati ripetutamente estratti attraverso lo stesso meccanismo; normalmente si osserva un solo insieme di dati e si stima l'incertezza che ne deriva.
L'errore standard stimato SE(Ȳ)=s/√n è esso stesso casuale. Quando gli errori sono distribuiti normalmente e σ2 è sconosciuto, (Ȳ−μ)/(s/√n) segue una distribuzione t di Student con n−1 gradi di libertà. Le code si avvicinano a quelle della normale standard all'aumentare dei gradi di libertà. Quando l'ipotesi di normalità non è plausibile, un'approssimazione normale per grandi campioni può rimanere utile, purché valgano il CLT e l'affidabilità dello stimatore della varianza.
Intervalli di confidenza
Un intervallo di confidenza al 95% è una procedura che genera un intervallo casuale con probabilità di copertura del 95% nel modello ipotizzato e in un campionamento ripetuto. Nella terminologia frequentista classica, non afferma che vi sia una probabilità del 95% che un intervallo realizzato e fisso contenga il parametro fisso. Un intervallo approssimato è
Per un piccolo campione normale con varianza sconosciuta, il moltiplicatore è generalmente il valore critico t appropriato anziché 1.96. Gli intervalli devono utilizzare uno stimatore della varianza coerente con il disegno dei dati. Limiti di confidenza basati sull'indipendenza risultano spesso troppo stretti in presenza di osservazioni positivamente correlate.
Verifica delle ipotesi
Un test statistico utilizza la distribuzione campionaria di uno stimatore per valutare se l'evidenza osservata sia compatibile con un'ipotesi nulla. Per H0: θ=θ0, la consueta statistica è
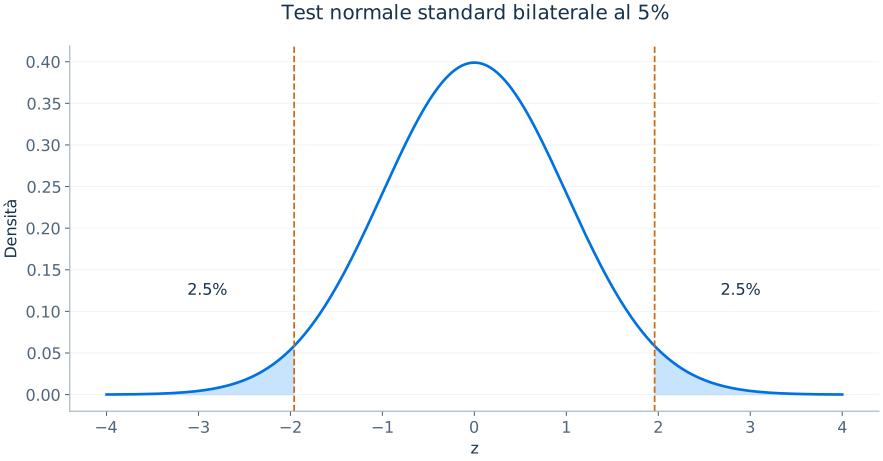
Il p-value è la probabilità, sotto l'ipotesi nulla, di ottenere una statistica del test almeno altrettanto estrema di quella osservata, secondo la definizione fornita dall'ipotesi alternativa. Non è né la probabilità che H0 sia vera né la probabilità che l'alternativa sia corretta. Un test bilaterale al 5% rifiuta per valori t positivi o negativi sufficientemente estremi; un test unilaterale assegna preventivamente la regione di rifiuto a una sola coda.
Esistono almeno tre criteri distinti per discutere una stima: significatività statistica, entità economica e qualità dell'identificazione. Un coefficiente può essere statisticamente distinguibile da zero e tuttavia troppo piccolo per avere rilevanza economica. Viceversa, un effetto stimato di una politica può essere elevato ma avere un ampio intervallo di confidenza perché il campione indipendente è piccolo. Nessuna delle due situazioni dimostra, da sola, la causalità.
Confrontare due medie di popolazione
Per campioni indipendenti dei gruppi A e B, la differenza tra medie campionarie Δ̂=Ȳa−Ȳᵦ stima la corrispondente differenza tra medie di popolazione. Se i gruppi sono indipendenti, un errore standard stimato che ammette varianze diverse è
Non è necessario aggregare le varianze dei gruppi, salvo che il modello con varianze uguali sia esplicitamente giustificato. Se le osservazioni costituiscono invece coppie abbinate o misurazioni ripetute sulle stesse unità, la covarianza tra osservazioni modifica la formula della varianza; trattare come indipendenti le osservazioni appaiate spreca informazione o sottostima l'incertezza.
Fonti di errore che gli intervalli di confidenza non correggono
L'errore standard tiene conto della variabilità campionaria nell'ambito del modello di campionamento scelto. Non considera automaticamente errori di codifica, misurazioni distorte, pubblicazione selettiva, dinamiche specificate erroneamente, fattori confondenti omessi o strumenti non validi. Gli intervalli di confidenza quantificano una parte dell'incertezza: non certificano la validità dell'interpretazione economica. Questa distinzione diventa essenziale quando i metodi diventano più sofisticati.
Il bootstrap e il suo corretto ambito di applicazione
Un bootstrap non parametrico campiona ripetutamente con reinserimento le osservazioni dalla distribuzione empirica osservata, ricalcolando lo stimatore per ogni pseudocampione. In condizioni appropriate, la distribuzione risultante delle stime bootstrap approssima la distribuzione campionaria dello stimatore. Gli intervalli bootstrap percentili, di base e studentizzati possono differire, soprattutto quando le distribuzioni sono asimmetriche. Il bootstrap deve seguire la struttura del processo generatore dei dati: occorre ricampionare i gruppi anziché i singoli studenti se le unità statistiche sono le classi, e utilizzare schemi a blocchi appropriati per le serie storiche quando le osservazioni presentano dipendenza seriale.
Il bootstrap non è una soluzione universale ai problemi di identificazione o di strumenti deboli. Ricampionare dati osservativi affetti da confondimento ne riproduce l'associazione confusa; non ricrea un esperimento ideale. Le procedure bootstrap standard possono inoltre non funzionare per stimatori non regolari o non differenziabili e per parametri non regolari. Un metodo di ricampionamento deve essere validato per lo stimatore e per lo schema di campionamento utilizzati.
Errori di I e di II tipo
Un errore di I tipo consiste nel rifiutare un'ipotesi nulla vera. Per un test al 5% correttamente calibrato, la sua probabilità sotto l'ipotesi nulla è il 5%. Un errore di II tipo consiste nel non rifiutare un'ipotesi nulla falsa; la potenza è uno meno la probabilità di errore di II tipo per un'alternativa specificata. Queste probabilità variano con la numerosità campionaria, la varianza della popolazione, l'entità dell'effetto reale e il disegno del test. Una soglia di significatività del 5% non costituisce una garanzia sostanziale che un'affermazione pubblicata sia probabilmente vera.