
14. Serie storiche, modelli AR e previsione
Dipendenza nel tempo, stazionarietà, selezione dei ritardi e valutazione rigorosa delle previsioni
La natura della variabilità nelle serie storiche
Una serie storica è una sequenza ordinata di osservazioni indicizzate nel tempo, come il PIL trimestrale, l’inflazione mensile o i rendimenti giornalieri delle attività finanziarie. A differenza delle osservazioni trasversali indipendenti, le osservazioni vicine nel tempo contengono spesso informazioni sovrapposte: la produzione di oggi dipende da quella di ieri, i livelli dei prezzi incorporano le variazioni passate e la volatilità finanziaria può persistere per più periodi. L’inferenza statistica e la previsione devono tenere conto di questa struttura temporale, invece di applicare meccanicamente formule ricavate per osservazioni indipendenti.
Una trasformazione utile è la differenza prima ΔYt=Yt−Yt₋1. Per una serie positiva, Δln(Yt)=ln(Yt)−ln(Yt₋1) approssima il tasso di crescita tra t−1 e t. Se Y è un indice o il livello generale dei prezzi, una differenza può essere significativa nelle unità dei livelli, mentre una differenza logaritmica misura una variazione proporzionale. Le trasformazioni possono eliminare alcune forme di tendenza, ma possono anche modificare la domanda economica e introdurre una propria struttura di correlazione seriale.
Autocovarianza, autocorrelazione e stazionarietà
Per un processo debolmente stazionario, la media E[Yt]=μ è invariata nel tempo, la varianza è finita e costante e la covarianza tra Yt e Yt₋k dipende soltanto dal ritardo k, non dalla data t. Indichiamo questa autocovarianza con γ(k)=Cov(Yt,Yt₋k). L’autocorrelazione è ρ(k)=γ(k)/γ(0). Un’autocorrelazione positiva di primo ordine significa che le osservazioni superiori alla media tendono a essere seguite da ulteriori osservazioni superiori alla media.
Le serie storiche non stazionarie possono presentare medie variabili, varianza variabile o tendenze stocastiche persistenti. Una serie che mostra visivamente una tendenza non è automaticamente un processo con radice unitaria; distinguere le tendenze deterministiche da quelle stocastiche è importante per le trasformazioni, i test delle ipotesi e l’incertezza delle previsioni.
Il modello autoregressivo di ordine uno
Un processo AR(1) ha la forma
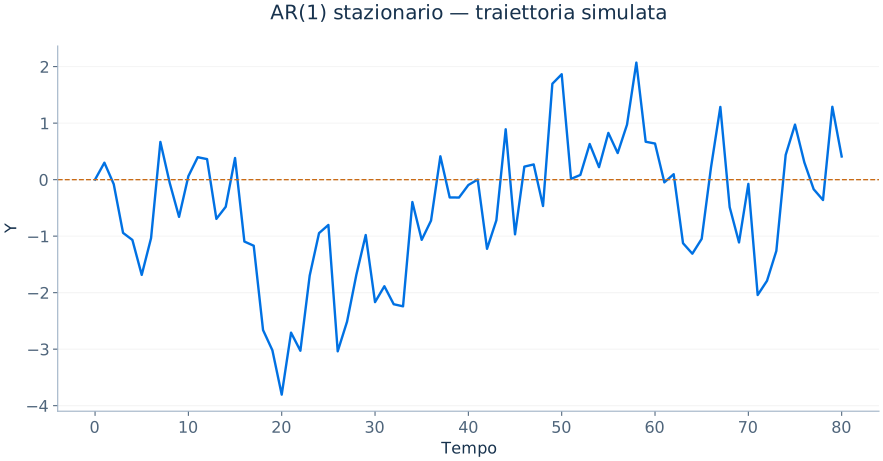
dove εt ha media condizionale nulla data l’informazione disponibile al tempo t−1. Con |φ|<1 e innovazioni di rumore bianco di varianza σ2, la soluzione stazionaria causale ha media μ=c/(1−φ) e varianza σ2/(1−φ2). Questi momenti stazionari valgono quando il processo è inizializzato nella propria distribuzione stazionaria; un valore iniziale arbitrario genera una fase transitoria. La media condizionale nulla, che è più forte della semplice assenza di correlazione con il passato, giustifica la previsione condizionale riportata di seguito. Per φ positivo e inferiore a uno, uno shock si attenua gradualmente anziché scomparire immediatamente.
La previsione condizionata a k passi, con parametri noti, è
Quando |φ|<1, le previsioni tendono alla media di lungo periodo all’aumentare di k. Se φ si avvicina a uno, gli shock si attenuano molto lentamente e l’incertezza su orizzonti lunghi diventa considerevole. Per φ=1, il processo è una passeggiata aleatoria con deriva: le formule standard dei modelli AR stazionari non sono più applicabili.
Autoregressioni di ordine superiore
Un modello AR(p) include p ritardi della variabile dipendente:
Ordini di ritardo più elevati consentono di rappresentare forme di persistenza più articolate, ma aggiungono parametri e richiedono un campione effettivo di stima più ampio. La condizione di stabilità pertinente per un AR(p) riguarda le radici del polinomio caratteristico, non semplicemente il fatto che ciascun coefficiente stimato abbia individualmente valore assoluto inferiore a uno. La regressione può essere stimata con OLS sotto opportune ipotesi di esogeneità dei predittori ritardati rispetto all’innovazione corrente e ulteriori ipotesi di stazionarietà o regolarità.
Selezione del modello: AIC, BIC e validazione
L’ordine dei ritardi p può essere scelto mediante criteri informativi che bilanciano adattamento ai dati e complessità del modello. Una forma comune di tipo gaussiano, basata su una stima della varianza residua, è
dove kp conta i parametri stimati e T è la numerosità campionaria effettiva. Nell’insieme dei modelli candidati, valori inferiori del criterio sono preferibili secondo la convenzione scelta. La penalizzazione del BIC cresce con ln T e favorisce maggiormente i modelli parsimoniosi quando il campione aumenta. Per effettuare confronti validi, i diversi ordini di ritardo devono essere valutati su campioni di stima comparabili e i criteri devono adottare normalizzazioni compatibili.
La validazione incrociata delle serie storiche deve preservare l’ordine cronologico. Una strategia è la valutazione con origine mobile: si stima il modello usando i dati disponibili fino alla data t, si prevede t+1, si avanza nel tempo e si ripete. In questo modo si ottiene una stima pratica delle prestazioni nella previsione di osservazioni realmente future. La validazione incrociata con suddivisioni casuali può introdurre informazioni future nella stima se le suddivisioni interrompono la struttura temporale.
MSFE, incertezza delle previsioni e modelli di riferimento
Per le previsioni a h passi Ŷt₊h|t, gli errori di previsione sono et₊h=Yt₊h−Ŷt₊h|t. L’errore quadratico medio di previsione è MSFE=(1/m)Σe2, calcolato su effettive date di valutazione. Un buon riferimento può essere una media storica, una passeggiata aleatoria o un semplice modello AR. I modelli sofisticati devono essere confrontati con alternative più semplici e credibili, utilizzando dati non impiegati nella stima.
Gli intervalli di previsione devono considerare l’incertezza delle innovazioni, quella dei parametri e la possibile instabilità del modello. In un AR(1) stazionario con φ noto e innovazioni di varianza condizionale costante σ2 e media condizionale nulla, la varianza dell’errore di previsione a k passi dovuta alle innovazioni è
Orizzonti più lunghi comportano normalmente un accumulo di incertezza. Se i parametri del modello sono stimati, occorre considerare l’incertezza aggiuntiva quando la dimensione campionaria la rende rilevante.
Radici unitarie e regressione spuria
Una passeggiata aleatoria Yt=Yt₋1+εt ha una radice unitaria e non è debolmente stazionaria. Regredire una serie con tendenza su un’altra serie con tendenza priva di legami con la prima può produrre statistiche t e valori di R2 apparentemente notevoli, anche se le innovazioni sottostanti sono indipendenti: è una regressione spuria. I test di radice unitaria hanno distribuzioni di riferimento non standard e non devono essere interpretati come normali test t di regressione. In alcuni casi la differenziazione permette di ottenere un processo stazionario, ma differenziare una relazione che è effettivamente stazionaria dopo aver eliminato la tendenza può far perdere informazioni preziose.
Quando due serie non stazionarie condividono una relazione di equilibrio stabile di lungo periodo, possono essere cointegrate. Un modello a correzione dell’errore può rappresentare sia le variazioni di breve periodo sia l’aggiustamento verso l’equilibrio di lungo periodo. Si tratta di un’estensione sostanziale; trovare semplicemente una regressione statisticamente significativa tra due livelli dei prezzi non costituisce una prova sufficiente di cointegrazione.
La previsione in pratica con R
L’esempio seguente illustra la stima di un modello AR, l’addestramento rispettoso dell’ordine temporale e alcuni principi diagnostici di base. Nella ricerca effettiva occorre verificare gli effetti stagionali, l’autocorrelazione dei residui, le rotture strutturali e la stabilità delle previsioni.
# Assume y is a numeric time-series vector ordered chronologically.
y_train <- head(y, length(y) - 12)
y_test  <- tail(y, 12)
fit_ar <- arima(y_train, order = c(1, 0, 0), include.mean = TRUE)
fc <- predict(fit_ar, n.ahead = 12)
rmse <- sqrt(mean((y_test - fc$pred)^2))
print(rmse)
acf(residuals(fit_ar))Effetti dinamici e modelli a ritardi distribuiti
Un’economia può non rispondere interamente a una politica nello stesso periodo in cui questa viene attuata. Un modello a ritardi distribuiti descrive l’esito come funzione delle variabili esplicative correnti e ritardate, per esempio
Qui δ0 è la risposta contemporanea, mantenendo fissi gli altri termini esplicativi, mentre δ1 e δ2 rappresentano ulteriori risposte su orizzonti successivi secondo l’interpretazione temporale del modello. Se un aumento permanente di un’unità di X persiste dal periodo t in avanti, la risposta cumulata, dopo che tutti i ritardi inclusi hanno prodotto i loro effetti, è δ0+δ1+δ2. L’errore standard di questa somma deve comprendere le covarianze tra le stime dei coefficienti dei ritardi.
Per un’interpretazione causale, la sequenza degli input X deve essere esogena in un senso sufficientemente forte rispetto agli shock non osservati. Ritardare un regressore non elimina automaticamente l’endogeneità: gli agenti possono anticipare gli shock, le politiche possono rispondere a perturbazioni passate e condizioni persistenti non osservate possono essere correlate con i valori presenti di X.
Confronto tra previsioni e rotture strutturali
Una rottura strutturale si verifica quando cambiano la media, la varianza o i coefficienti predittivi. Un modello AR stimato interamente prima di una riforma importante può produrre previsioni scadenti dopo la riforma, anche con un basso errore residuo storico. Le valutazioni mobili e i test di stabilità sono quindi fondamentali per l’affidabilità delle previsioni. Un modello può offrire ottime previsioni a un passo, ma peggiorare su orizzonti più lunghi perché piccoli errori dinamici si accumulano. Indica sempre l’orizzonte, la finestra di addestramento e il modello di riferimento; affermare che un modello di previsione è «accurato» senza questi dettagli è incompleto.
Verificare una radice unitaria: conta l’ipotesi nulla
La regressione di Dickey–Fuller aumentata spiega la differenza prima usando il livello ritardato, eventuali termini deterministici e ritardi della differenza prima. Nell’equazione seguente, l’ipotesi nulla di radice unitaria è γ=0. L’alternativa stazionaria presenta un coefficiente di aggiustamento negativo nell’appropriata specificazione stabile. La costante, il trend e l’ordine dei ritardi influenzano la distribuzione di riferimento e l’interpretazione; un valore critico ordinario della t di Student non è appropriato.
Non rifiutare una radice unitaria non ne dimostra la presenza, soprattutto in serie brevi o molto persistenti. Il test KPSS parte invece da un’ipotesi nulla di stazionarietà, quindi il suo p-value risponde a una domanda diversa. Risultati contrastanti dovrebbero indurre a esaminare rotture strutturali, trend deterministici e potenza nei campioni finiti, anziché a contare quale esito prevale tra i test. Una differenziazione eccessiva può introdurre correlazione seriale non necessaria ed eliminare relazioni in livelli economicamente significative. In R, tseries::adf.test include per impostazione predefinita una costante e un trend lineare; questa scelta va compresa e non scambiata per un test neutrale rispetto a qualsiasi possibile specificazione deterministica.
| Test | Ipotesi nulla | Significato del rifiuto |
|---|---|---|
| ADF | Radice unitaria con i termini deterministici specificati | Evidenza contraria a quel modello con radice unitaria |
| KPSS | Stazionarietà in livello o attorno a un trend, secondo la specificazione | Evidenza contraria a quel modello di stazionarietà |