
11. OLS nei grandi campioni e inferenza robusta
Consistenza, normalità asintotica e covarianza consistente in presenza di eteroschedasticità
Perché conta la teoria dei grandi campioni
La non distorsione nei campioni finiti è desiderabile, ma può richiedere ipotesi forti o risultare difficile da dimostrare nei modelli complessi. La teoria asintotica si chiede invece come si comporti la distribuzione di uno stimatore al crescere del numero di osservazioni campionate in modo appropriato. La consistenza significa convergenza in probabilità al parametro; la normalità asintotica caratterizza le fluttuazioni intorno a quel limite sulla scala √n. Queste proprietà sono logicamente distinte: uno stimatore può convergere a un parametro pseudo-vero errato e avere comunque una distribuzione limite normale intorno a esso.
Nella regressione multipla, l'identità OLS è β̂=β+(X′X)-1X′u. Riordinando si ottiene
Se (1/n)X′X converge in probabilità a una matrice finita e non singolare Q=E[XiXi′] e (1/n)X′u converge a zero, allora β̂ converge a β. La condizione decisiva è un momento di ortogonalità, E[Xiui]=0; nei modelli standard, l'indipendenza in media condizionata è un requisito sufficiente ma più forte.
Derivazione della consistenza
La legge dei grandi numeri (LLN) fa sì che le medie campionarie si avvicinino alle corrispondenti grandezze della popolazione. Per osservazioni indipendenti e identicamente distribuite, adeguati momenti finiti e non singolarità implicano
Pertanto E[Xu]=0 garantisce la consistenza, mentre E[Xu]≠0 produce tipicamente una distorsione asintotica non nulla. Questa espressione collega direttamente la stima nei grandi campioni ai problemi di variabili omesse ed endogeneità introdotti in precedenza. Un campione di un milione di osservazioni può stimare con precisione eccezionale il coefficiente angolare sbagliato della popolazione se E[Xu] non è zero.
La distribuzione asintotica e la varianza sandwich
Sia Ω=E[XiXi′ui2]. Con osservazioni indipendenti, adeguate condizioni sui momenti e un teorema del limite centrale (CLT),
Questa è la formula generale della covarianza asintotica robusta all'eteroschedasticità per uno stimatore lineare dei momenti correttamente riferito al parametro di interesse. La corrispondente covarianza approssimata per un campione finito è (1/n)Q-1ΩQ-1. Nella pratica, si sostituiscono Q e Ω con gli analoghi campionari e ui con i residui stimati:
L'apice HC0 indica la forma di base di Eicker–Huber–White. HC1 la moltiplica per un opportuno fattore di correzione dei gradi di libertà, mentre HC2 e HC3 applicano correzioni per la leva statistica osservazione per osservazione. La scelta può essere rilevante in presenza di osservazioni influenti e dataset più piccoli.
Perché gli errori standard robusti non correggono coefficienti distorti
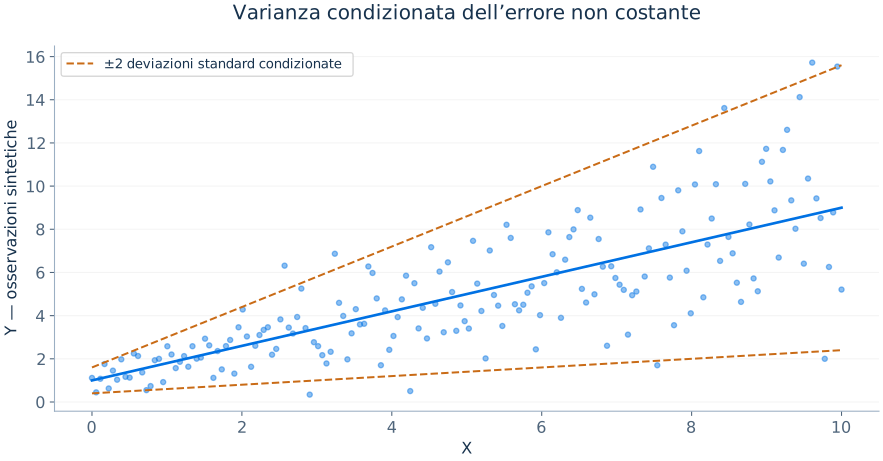
OLS ordinario e OLS robusto all'eteroschedasticità usano gli stessi coefficienti stimati. La procedura robusta modifica la varianza stimata dello stimatore, non la strategia di identificazione. Se l'istruzione è correlata con l'abilità omessa, calcolare errori standard HC3 non trasforma l'associazione con gli anni di istruzione in un rendimento causale. L'inferenza può essere robusta all'eteroschedasticità mentre la stima puntuale rimane inconsistente a causa dell'endogeneità.
Osservazioni raggruppate e dipendenti nel tempo
Se gli studenti condividono le classi, i lavoratori condividono le imprese o le osservazioni si ripetono all'interno degli stessi paesi, gli errori possono essere correlati entro i cluster. Trattare osservazioni raggruppate come indipendenti può produrre un'eccessiva fiducia molto marcata. Gli stimatori della covarianza robusti per cluster aggregano i contributi allo score all'interno di ciascun cluster indipendente; la quantità effettiva di informazioni dipende spesso più dal numero di cluster indipendenti che dal conteggio grezzo delle osservazioni.
Siano Xg e ûg le osservazioni appartenenti al cluster g. Uno stimatore sandwich per cluster senza correzioni ha la forma
Le procedure pratiche applicano correzioni per piccoli campioni e usano distribuzioni di riferimento che tengono conto dei cluster. Con pochissimi cluster, l'asintotica standard può essere inaffidabile; possono essere necessari metodi bootstrap appropriati per cluster o disegni di ricerca alternativi. Per i dati di serie storiche, la stima della covarianza consistente in presenza di eteroschedasticità e autocorrelazione (HAC) considera esplicitamente la correlazione tra ritardi.
Il metodo delta per grandezze non lineari
Gli economisti riportano spesso una funzione g(β̂), come un'elasticità, un rapporto di coefficienti, un punto di svolta o un effetto dinamico cumulato. Se β̂ è asintoticamente normale e g è differenziabile nel parametro di interesse, il metodo delta fornisce
Per un rapporto g(a,b)=a/b, il gradiente è (1/b, −a/b2). I rapporti diventano instabili quando il denominatore è vicino a zero, perciò le approssimazioni delta del primo ordine possono funzionare male: un'avvertenza importante per gli stimatori a variabili strumentali con primi stadi deboli.
Test robusti nella pratica
Usa uno stimatore robusto della covarianza coerente con il disegno osservazionale, non semplicemente un'opzione predefinita. Gli errori standard HC presuppongono indipendenza tra osservazioni, pur consentendo varianze dell'errore diverse, mentre gli stimatori per cluster e HAC si rivolgono a strutture di dipendenza differenti. L'output di regressione pertinente dovrebbe dichiarare il numero di osservazioni, i controlli, le unità di raggruppamento e lo stimatore degli errori standard.
fit <- lm(y ~ x1 + x2 + x3, data = dat)
library(sandwich)
library(lmtest)
coeftest(fit, vcov. = vcovHC(fit, type = "HC3"))
# Cluster-robust inference when 'firm_id' identifies independent firms:
coeftest(fit, vcov. = vcovCL(fit, cluster = ~ firm_id))Varianza robusta e matrice hat
La leva statistica dell'osservazione i nella regressione lineare è hi=xi′(X′X)-1xi. Nei piccoli campioni, i residui stimati possono sottostimare sistematicamente i disturbi delle osservazioni ad alta leva. HC2 sostituisce ûi2 con ûi2/(1−hi), mentre HC3 usa ûi2/(1−hi)2 nella parte centrale dello stimatore sandwich. Queste correzioni possono produrre errori standard sensibilmente diversi quando il disegno contiene valori insoliti di X.
Nessuno stimatore HC corregge la dipendenza tra osservazioni. Ad esempio, se 500 studenti provengono da 10 classi, un calcolo HC3 continua a trattare le righe come indipendenti. In presenza di shock comuni alla classe, il raggruppamento a livello di classe è più pertinente. Dieci cluster possono essere troppo pochi per le convenzionali approssimazioni della distribuzione t basate sull'asintotica per cluster, perciò possono essere necessarie procedure per un numero finito di cluster o evidenze più forti fondate sul disegno di ricerca.
Il significato della normalità asintotica
L'affermazione √n(β̂−β)→ᵈN(0,V) implica che gli scostamenti campionari si riducano alla velocità 1/√n e si avvicinino a una forma normale dopo la standardizzazione. Non implica che β̂ sia non distorto per ogni n finito, né che sia universale la soglia di dimensione campionaria oltre la quale l'approssimazione diventa buona. Regressori quasi singolari, code pesanti e strumenti deboli sono esempi in cui il comportamento nei campioni finiti può discostarsi nettamente da una formula asintotica apparentemente attraente.
Una cautela particolarmente importante riguarda i rapporti. Uno stimatore 2SLS divide un momento campionario casuale per un altro. Se la rilevanza dello strumento è debole, il denominatore può essere vicino a zero con probabilità non trascurabile, rendendo la distribuzione del rapporto fortemente asimmetrica o a code pesanti. Trattare questo stimatore come approssimativamente normale può produrre intervalli di confidenza invalidi anche con molte osservazioni.
Covarianza HAC e scelta della finestra dei ritardi
Con osservazioni di serie storiche, la covarianza dello score della regressione st=xtut comprende prodotti tra date diverse. Uno stimatore consistente in presenza di eteroschedasticità e autocorrelazione, abbreviato HAC, ne stima la covarianza di lungo periodo invece di mantenere soltanto i prodotti relativi alla stessa data. Newey–West combina le autocovarianze campionarie degli score fino a una finestra di ritardi L, assegnando un peso minore ai ritardi più lontani; il peso di Bartlett al ritardo ℓ è 1−ℓ/(L+1).
Una finestra troppo breve può trascurare una dipendenza persistente, mentre una finestra lunga stima molte autocovarianze rumorose. Vanno indicati l’ordinamento delle osservazioni, la larghezza della finestra o la regola dei ritardi, l’eventuale prewhitening e una verifica di sensibilità significativa. HAC non corregge regressori endogeni, radici unitarie o un meccanismo causale omesso. Per una regressione stazionaria opportunamente specificata in R, sandwich::NeweyWest(fit, lag = 4, prewhite = FALSE) richiede un calcolo di Bartlett con quattro ritardi; quattro è un esempio, non una scelta universale. I panel con raggruppamenti e una singola serie temporale ordinata hanno strutture informative diverse, quindi un’opzione HAC non deve sostituire meccanicamente il clustering.