
8. Difference-in-differences
Il metodo difference-in-differences, solitamente abbreviato in DiD, stima un effetto confrontando la variazione di un risultato in un gruppo trattato con la sua variazione in un gruppo di confronto. Utilizza due dimensioni di variazione: le differenze tra gruppi e le differenze nel tempo. La sua domanda centrale è se l'evoluzione del gruppo di confronto possa rivelare che cosa sarebbe accaduto al gruppo trattato in assenza di trattamento. Il metodo è particolarmente utile quando una politica cambia in un luogo o per un gruppo, mentre un gruppo di confronto credibile rimane non trattato.
Perché occorre una doppia differenza
Un confronto prima-dopo all'interno di un gruppo trattato combina l'effetto del trattamento con tutto ciò che è cambiato nel tempo. Un aumento delle rese agricole successivo a una riforma può riflettere in parte condizioni meteorologiche migliori o nuove varietà di sementi. Il confronto tra trattati e controlli dopo la riforma presenta un problema diverso: i gruppi potevano essere diversi già prima di qualsiasi riforma. Il DiD sottrae la variazione del gruppo di confronto da quella del gruppo trattato, eliminando sia un cambiamento temporale comune sia una differenza stabile preesistente tra i gruppi.
Indichiamo con il gruppo trattato, con il gruppo di confronto e con e i periodi precedenti e successivi al trattamento. Lo stimatore campionario è
Equivalentemente, è la differenza tra i gruppi dopo il trattamento meno la loro differenza prima del trattamento. Questo calcolo è sempre possibile quando esistono le quattro medie. Che il risultato rappresenti un effetto causale dipende dalle ipotesi sul controfattuale non osservato. Un comando di regressione non può fornire tali ipotesi.
Un calcolo completo: riforma delle affittanze agricole e rese del riso
L'Operazione Barga, introdotta nel Bengala Occidentale nel 1978, mirava a regolamentare i canoni delle affittanze agricole e a rafforzare la sicurezza dei mezzadri. Una maggiore sicurezza e una quota maggiore di prodotto trattenuto potevano modificare gli incentivi all'impegno, all'investimento e alla contrattazione. Un noto esempio associato al lavoro di Banerjee, Gertler e Ghatak confronta le rese del riso nel Bengala Occidentale con quelle del vicino Bangladesh, che non fu interessato dalla stessa riforma. Il risultato è misurato in chilogrammi per ettaro, quindi le differenze mantengono questa unità di misura.
| Gruppo | Prima della riforma | Dopo la riforma | Variazione |
|---|---|---|---|
| Bengala Occidentale | 1,308 | 1,650 | 342 |
| Bangladesh | 1,297 | 1,562 | 265 |
| Bengala Occidentale meno Bangladesh | 11 | 88 | 77 |
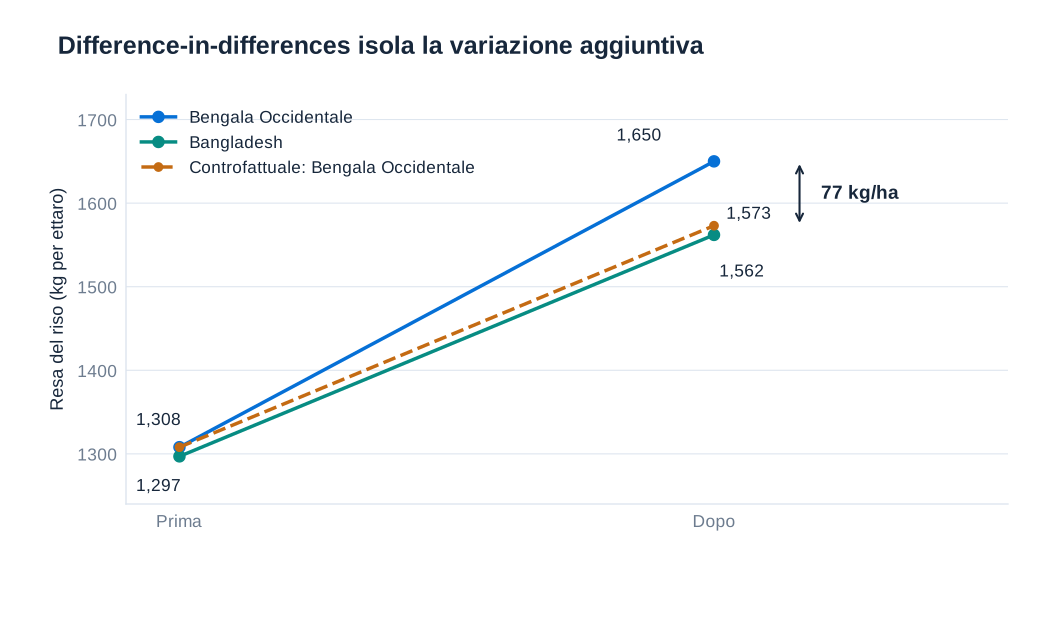
L'aumento del gruppo trattato è kg/ha. L'aumento del gruppo di confronto è kg/ha. La loro differenza è quindi kg/ha. Lo stesso risultato si ottiene da . Utilizzare soltanto l'aumento del gruppo trattato attribuirebbe alla riforma tutti i 342 kg/ha. Utilizzare soltanto la differenza finale tra i gruppi produrrebbe 88 kg/ha e ignorerebbe il divario iniziale.
La resa controfattuale del Bengala Occidentale dopo la riforma è la sua resa iniziale più l'aumento del gruppo di confronto:
L'effetto stimato è la distanza verticale tra la resa effettiva, 1,650, e la resa controfattuale, 1,573: precisamente 77 kg/ha. La resa finale effettiva del gruppo di controllo è 1,562, che non rappresenta il controfattuale del gruppo trattato perché i loro livelli iniziali erano diversi. Rispetto al controfattuale stimato, 77 kg/ha corrispondono a circa il 4.9%; rispetto alla resa iniziale del gruppo trattato, a circa il 5.9%. Queste percentuali rispondono a domande diverse e devono essere indicate di conseguenza. Quattro medie sono sufficienti per calcolare una stima puntuale, ma non forniscono un errore standard né dimostrano che valgano le ipotesi identificanti.
I trend paralleli sono un'ipotesi controfattuale
Indichiamo con il risultato che l'unità avrebbe senza trattamento e con il risultato in presenza di trattamento. Sia l'indicatore di appartenenza al gruppo trattato. L'ipotesi di trend paralleli richiede variazioni medie uguali nei risultati potenziali in assenza di trattamento:
Questo non richiede livelli iniziali uguali del risultato. Non richiede neppure che i risultati osservati rimangano paralleli dopo il trattamento; è proprio un effetto del trattamento a poter far divergere le traiettorie osservate. L'ipotesi riguarda la traiettoria che il gruppo trattato avrebbe seguito senza trattamento. Tale traiettoria non è osservata dopo l'inizio del trattamento, ed è per questo che l'ipotesi di trend paralleli non può essere verificata direttamente usando i dati successivi al trattamento.
In assenza di anticipazione e con un gruppo di confronto non trattato, il DiD osservato è uguale all'effetto medio del trattamento sui trattati più la differenza tra i trend che i gruppi avrebbero seguito senza trattamento. L'ipotesi di trend paralleli pone quest'ultimo termine uguale a zero. Si identifica così un effetto per la popolazione trattata, non necessariamente l'effetto che si avrebbe se ogni altro gruppo adottasse la stessa politica. Una geografia simile o medie iniziali simili possono contribuire a giustificare un confronto, ma nessuna delle due proprietà garantisce variazioni controfattuali simili.
Anticipazione, effetti di propagazione e composizione
Assenza di anticipazione significa che il comportamento precedente alla data di trattamento stabilita non ha già reagito alla politica imminente. Se una riforma viene annunciata in anticipo e gli agricoltori iniziano subito a investire, trattare il periodo tra annuncio e attuazione come una situazione iniziale non influenzata può distorcere la stima. La data di trattamento pertinente dovrebbe riflettere il momento in cui il comportamento può cambiare.
Assenza di interferenza tra i gruppi confrontati richiede un'attenta riflessione sugli effetti di propagazione. Una regione vicina può essere un controllo interessante perché affronta condizioni simili, eppure il commercio, la migrazione o la concorrenza tra politiche possono trasmettere il trattamento anche a quella regione. Se reagisce anche il risultato del gruppo di confronto, il contrasto stimato generalmente non rappresenta l'effetto sul gruppo trattato rispetto a un mondo completamente privo di trattamento.
Anche la composizione dei gruppi deve rimanere adatta al confronto. Nelle sezioni trasversali ripetute possono essere osservate persone diverse prima e dopo, e la migrazione indotta dal trattamento o la mancata risposta a un'indagine possono cambiare la popolazione rappresentata dalla media di un gruppo. Un panel riduce alcuni problemi di composizione, ma può comunque risentire di uscite selettive dal campione. Le covariate che variano nel tempo possono migliorare un confronto condizionato quando rappresentano fattori confondenti appropriati; controllare una variabile causata dal trattamento può invece eliminare parte dell'effetto che si intende stimare o introdurre distorsione.
La regressione con due gruppi e due periodi
Il DiD elementare può essere stimato mediante una regressione con interazione:
Qui dopo il trattamento e zero prima. L'intercetta è la media del gruppo di confronto prima del trattamento. Il coefficiente è la differenza iniziale del gruppo trattato rispetto a tale media. Il coefficiente è la variazione nel tempo del gruppo di confronto. L'interazione coglie la variazione aggiuntiva del gruppo trattato. Queste affermazioni si ricavano ponendo i due indicatori uguali a zero o a uno in ciascuna delle quattro celle.
| Grandezza | Espressione nella regressione | Valore (kg/ha) |
|---|---|---|
| Gruppo di confronto, prima | 1,297 | |
| Gruppo trattato, prima | 1,308 | |
| Gruppo di confronto, dopo | 1,562 | |
| Gruppo trattato, dopo | 1,650 | |
| Differenza iniziale tra gruppi | 11 | |
| Variazione del gruppo di confronto | 265 | |
| Variazione aggiuntiva del gruppo trattato | 77 |
La regressione satura riproduce le quattro medie campionarie delle celle e la stessa stima puntuale DiD. Se si introducono pesi o regressori aggiuntivi, la stima risultante riflette tali scelte e non deve necessariamente coincidere con il semplice contrasto non ponderato tra le quattro medie. Un coefficiente in chilogrammi per ettaro rimane un effetto assoluto sulla resa; un modello con risultato in logaritmi richiederebbe invece un'interpretazione sulla scala logaritmica e una trasformazione esplicitamente giustificata.
Molte unità, molti periodi e intensità del trattamento
Con molte unità e molti periodi, gli effetti fissi offrono una rappresentazione utile in forma di regressione:
Gli effetti di unità sostituiscono un'unica differenza media di livello tra trattati e controlli con un'intercetta per ciascuna unità. Gli effetti di periodo sostituiscono un singolo indicatore successivo al trattamento con un'intercetta per ciascuna data. La variabile di trattamento registra l'esposizione effettiva di quell'unità in quel periodo. Questa flessibilità è utile, ma non significa che ogni coefficiente a effetti fissi a due vie stimi automaticamente un effetto causale medio ben definito.
Le politiche sull'età minima legale per l'acquisto di alcol illustrano perché il trattamento non debba essere necessariamente binario o iniziare in una data comune. Dopo la fine del proibizionismo negli Stati Uniti, gli Stati stabilirono regole diverse sull'età; diversi di essi abbassarono le soglie nei primi anni 1970. Nel confronto storico, l'Alabama abbassò la soglia a 19 anni nel 1975, l'Arkansas la mantenne a 21 e il Tennessee la abbassò a 18 nel 1971, prima di rialzarla a 19 nel 1979. Successivamente, la politica federale favorì un'età minima di 21 anni, adottata in tutti gli Stati entro il 1988. Questi cambiamenti creano variazione nella quota di giovani adulti legalmente autorizzati ad acquistare alcol.
Definiamo come la proporzione di persone di età pari a 18–20 anni nello Stato e nell'anno legalmente autorizzate all'acquisto. Un modello per il loro tasso di mortalità può essere scritto come
Quando è codificata tra zero e uno e rappresenta i decessi per 100,000 persone, descrive la differenza stimata associata al passaggio da nessun individuo autorizzato a tutti gli individui autorizzati nella fascia d'età. Un aumento di 10 punti percentuali della quota autorizzata corrisponde a . Il modello impone una relazione lineare nell'intensità del trattamento; per interpretare causalmente le differenze tra dosi sono necessarie ipotesi più forti. Gli effetti di Stato assorbono le differenze fisse tra Stati e gli effetti di anno assorbono gli shock annuali comuni, mentre cambiamenti simultanei delle politiche o trend differenziati di mortalità possono ancora confondere la stima.
Evidenza precedente al trattamento ed event study
Diversi periodi precedenti al trattamento rendono un disegno di ricerca più informativo perché rivelano se i gruppi si stavano già muovendo in modo diverso. Per una data di trattamento comune , una specificazione event study sostituisce un unico coefficiente successivo al trattamento con interazioni tra l'appartenenza al gruppo trattato e le date relative al trattamento:
Il periodo immediatamente precedente al trattamento, , viene omesso come riferimento. I coefficienti precedenti al trattamento misurano quanto il divario tra gruppo trattato e gruppo di confronto nelle date anteriori differisca da quel divario di riferimento. I coefficienti successivi al trattamento descrivono come il divario evolva dopo l'esposizione. Rappresentare graficamente le stime puntuali con intervalli di incertezza appropriati consente di valutare tempi, precisione e persistenza più facilmente che con un unico coefficiente medio.
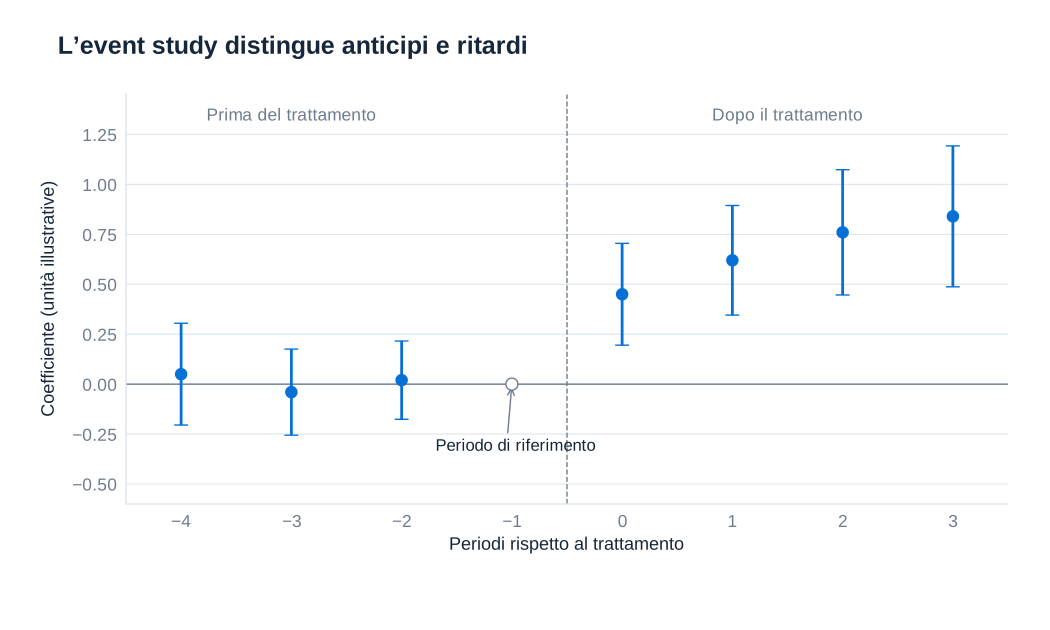
Stime precedenti al trattamento vicine a zero sono compatibili con trend paralleli, ma non dimostrano l'ipotesi. Un test può avere bassa potenza, gli intervalli di confidenza possono ammettere differenze economicamente rilevanti e un nuovo shock successivo al trattamento può influenzare i gruppi in modo diverso nonostante storie simili. Viceversa, differenze significative prima del trattamento possono rivelare anticipazione, un gruppo di confronto inadeguato o una specificazione errata. Sono informativi sia le singole stime sia un test congiunto dei coefficienti precedenti al trattamento, insieme a una conoscenza sostanziale del contesto. La credibilità riguarda i trend controfattuali successivi al trattamento, quindi un test non significativo sui trend precedenti non deve mai essere presentato come una validazione conclusiva.
Trend differenziati e relativi limiti
Un DiD convenzionale non funziona quando le unità trattate e quelle di confronto avrebbero continuato a seguire trend diversi in assenza di trattamento. Una specificazione per l'analisi di sensibilità aggiunge trend temporali lineari specifici per unità:
Il coefficiente consente a ciascuna unità di avere uno scostamento lineare stabile dalla traiettoria temporale comune. Il coefficiente del trattamento riflette quindi gli scostamenti da tali traiettorie stimate. Questo sostituisce la semplice ipotesi di trend paralleli con un'affermazione più forte sulla forma funzionale che descrive come sarebbero evolute le differenze in assenza di trattamento. Non è una correzione generale per qualsiasi divergenza arbitraria.
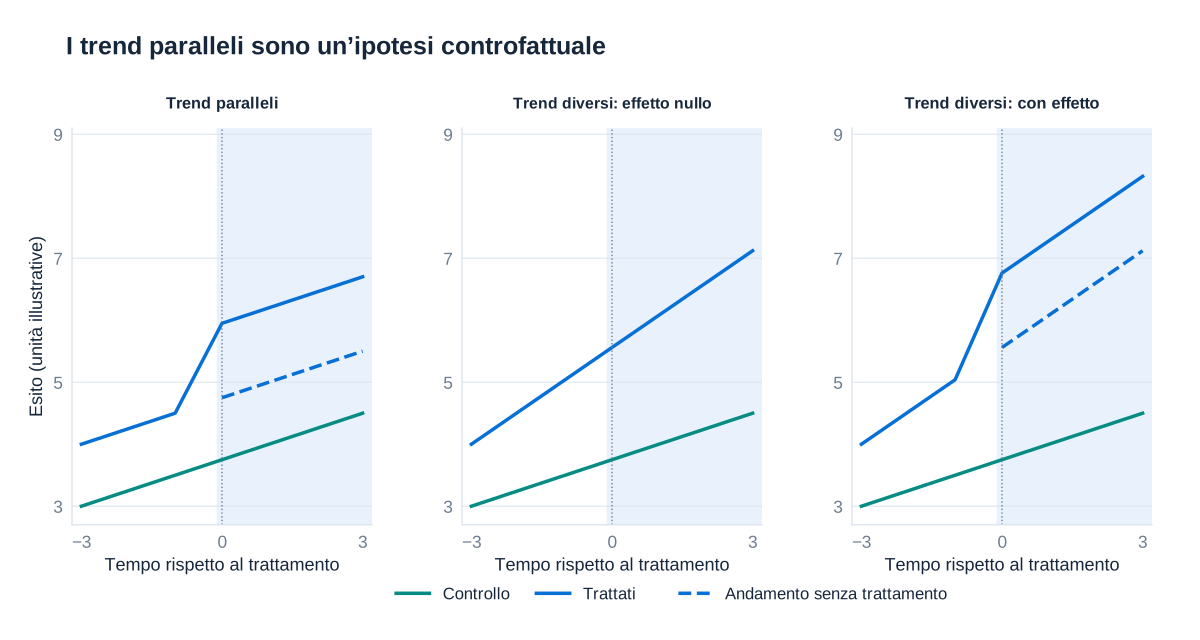
Tre casi chiariscono la distinzione. Con traiettorie parallele in assenza di trattamento e un salto discreto indotto dal trattamento, un DiD standard può recuperare il salto. Con traiettorie non parallele in assenza di trattamento e nessun effetto del trattamento, il divario variabile tra i gruppi può produrre un DiD spurio. Con traiettorie non parallele e un salto effettivo, un modello con trend differenziati correttamente specificato può separare la discontinuità da una divergenza preesistente regolare. Tuttavia, se gli effetti del trattamento emergono gradualmente, stimare trend specifici per unità utilizzando tutti i periodi può assorbire parte dell'effetto. Le conclusioni dovrebbero quindi considerare l'interazione tra le stime dei trend, la dinamica del trattamento e la finestra precedente al trattamento scelta.
Adozione scaglionata ed effetti eterogenei
Quando le unità adottano il trattamento in date diverse e gli effetti variano tra coorti o durate di esposizione, una regressione convenzionale a effetti fissi a due vie può utilizzare unità già trattate come controlli per unità appena trattate. Il coefficiente risultante può combinare confronti con pesi difficili da interpretare o persino negativi e non deve necessariamente coincidere con l'effetto medio del trattamento sui trattati che si intende stimare. L'interpretazione chiara del DiD elementare non dovrebbe essere trasferita automaticamente.
Gli approcci moderni stimano effetti per coorti e date di trattamento utilizzando unità di confronto appropriate, mai trattate o non ancora trattate, e poi aggregano tali effetti in modo trasparente. Il ricercatore deve definire la popolazione di interesse e lo schema di ponderazione, giustificare i trend paralleli e l'assenza di anticipazione per i confronti selezionati e individuare quali orizzonti successivi al trattamento dispongano di controlli credibili. Le politiche reversibili e il trattamento continuo richiedono ulteriore cautela, perché i metodi concepiti per un'unica data di adozione definitiva non si applicano automaticamente.
Incertezza e quantità effettiva di informazione
I risultati e l'esposizione alle politiche spesso persistono nel tempo. Trattare ogni osservazione persona-anno o Stato-anno come indipendente può rendere gli errori standard troppo piccoli. In un disegno basato su politiche statali, costruire cluster a livello di Stato consente ai disturbi di essere correlati tra anni e tra osservazioni che condividono lo stesso Stato. Se shock importanti attraversano i confini statali, i soli cluster di Stato possono non cogliere l'intera struttura di dipendenza. Il livello appropriato segue il disegno di ricerca e la correlazione plausibile dei disturbi.
Un numero maggiore di osservazioni all'interno delle stesse poche unità di politica non crea molti esperimenti di politica indipendenti. Il punto rilevante è il numero e il bilanciamento dei cluster indipendenti, soprattutto quanti di essi ricevono il trattamento. Non esiste una soglia universale oltre la quale l'inferenza robusta per cluster diventi automaticamente affidabile. Con pochi cluster possono essere necessari metodi quali correzioni appropriate per piccoli campioni, procedure wild-cluster bootstrap o inferenza per randomizzazione basata sul disegno, esplicitandone le ipotesi. Le quattro medie aggregate delle rese del riso, per esempio, non possono da sole giustificare un errore standard convenzionale. Uno studio DiD completo combina calcoli trasparenti, un controfattuale difendibile e un calcolo dell'incertezza coerente con l'effettiva struttura di assegnazione.