
4. Verifica delle ipotesi e inferenza statistica
Una stima puntuale è una realizzazione di una procedura applicata ai dati. Un altro campione potrebbe produrre un'altra stima, anche se la relazione nella popolazione rimanesse invariata. L'inferenza statistica misura questa incertezza campionaria e la utilizza per valutare ipotesi e costruire intervalli di confidenza. Le sue conclusioni dipendono sia da un modello credibile per il coefficiente sia da una stima credibile della sua variabilità. Né un p-value piccolo né un intervallo stretto correggono la distorsione da variabile omessa o un disegno causale non valido.
Campionamento casuale e assegnazione casuale rispondono a domande diverse
Il campionamento casuale riguarda il modo in cui le osservazioni entrano in un dataset. Un campione casuale semplice permette di fare inferenza dalle unità osservate alla popolazione dalla quale sono state estratte. L'assegnazione casuale riguarda il modo in cui il trattamento viene distribuito tra le unità e può rendere lo stato di trattamento indipendente dai loro risultati potenziali. Uno studio può prevedere un'assegnazione casuale senza estrarre un campione rappresentativo della popolazione, oppure un campione rappresentativo senza assegnazione casuale del trattamento.
La distinzione separa l'identificazione dalla generalizzazione. L'assegnazione casuale può fornire un confronto credibile del trattamento all'interno del gruppo studiato; estendere tale effetto ad altri gruppi può richiedere ipotesi aggiuntive. Viceversa, campionare casualmente le persone non rende esogene la loro istruzione, il loro reddito o le loro scelte di trattamento. Nella regressione su dati osservazionali, l'incertezza su quali unità siano state campionate e la distorsione dovuta al legame del regressore con determinanti non osservati sono problemi diversi.
La distribuzione campionaria descrive le stime che si otterrebbero ripetendo la procedura di campionamento con la stessa popolazione e lo stesso modello. Si tratta di una ripetizione concettuale, non dell'affermazione che il ricercatore osservi effettivamente molte popolazioni. Gli errori standard approssimano la dispersione di questa distribuzione usando i dati disponibili e ipotesi sulla dipendenza. Se il processo di campionamento coinvolge famiglie, scuole, regioni oppure osservazioni ripetute, le unità indipendenti rilevanti possono essere gruppi anziché singole righe.
Gli errori standard misurano l'incertezza di uno stimatore
La deviazione standard di un risultato descrive la variazione tra osservazioni. L'errore standard di uno stimatore descrive la variazione tra ipotetiche stime ripetute. Queste grandezze rispondono a domande diverse e hanno unità di misura diverse. L'errore standard di un coefficiente angolare di regressione si misura nelle stesse unità del coefficiente: per una regressione dei punteggi nei test sul numero di studenti per insegnante, si tratta di punti del test per unità del rapporto.
Per una regressione semplice con intercetta, errori condizionatamente omoschedastici e incorrelati e una specificazione valida della media condizionata, la varianza del coefficiente angolare condizionata ai regressori osservati è
Poiché la varianza del disturbo è sconosciuta, viene stimata a partire dai residui. Con due coefficienti stimati, lo stimatore abituale è . L'errore standard convenzionale del coefficiente angolare è la radice quadrata della varianza stimata del coefficiente. La corrispondente intuizione per grandi campioni è .
Una maggiore variazione non spiegata del risultato aumenta l'incertezza; un maggior numero di osservazioni indipendenti e una maggiore variazione utile del regressore la riducono. Nella regressione multipla, la variazione utile di un regressore è quella che rimane dopo aver tenuto conto degli altri regressori. Una forte collinearità può quindi produrre errori standard elevati anche in un dataset con molte osservazioni. Queste relazioni riguardano la precisione sotto le ipotesi del modello, non la capacità del modello di identificare un effetto causale.
Ipotesi nulle, statistiche t e distribuzioni di riferimento
Un'ipotesi nulla specifica un valore per un parametro della popolazione, come . Per un'alternativa bilaterale, , la statistica t misura la distanza stimata dall'ipotesi nulla in unità di errore standard:
Quando , questa espressione si riduce al consueto rapporto tra coefficiente ed errore standard. Un valore di significa che la stima si trova quattro errori standard stimati al di sotto del valore ipotizzato. L'ipotesi riguarda il coefficiente della popolazione; la stima osservata è già nota e, dopo aver osservato i dati, non è essa stessa un'incognita casuale.
Con errori indipendenti, distribuiti normalmente e condizionatamente omoschedastici, e con le consuete ipotesi del modello lineare, la statistica t convenzionale ha una distribuzione t di Student esatta con gradi di libertà, dove comprende l'intercetta. Con errori standard robusti all'eteroschedasticità, questo risultato esatto per campioni finiti generalmente non vale. Sotto opportune condizioni di regolarità, la statistica studentizzata si avvicina invece a una distribuzione normale standard al crescere della numerosità campionaria effettiva. I software possono usare come approssimazione una distribuzione t di riferimento con un aggiustamento dei gradi di libertà; la sua validità va valutata alla luce del disegno dello studio.
Il teorema del limite centrale si applica alle medie standardizzate
Il teorema del limite centrale spiega perché le approssimazioni normali possano essere utili anche quando le singole osservazioni non sono distribuite normalmente. Per variabili casuali indipendenti e identicamente distribuite, con media e varianza positiva e finita , la versione di base del teorema afferma
Le osservazioni originarie non diventano normali al crescere del campione. È la media campionaria centrata e riscalata ad avvicinarsi a una distribuzione normale, mentre la media campionaria non riscalata si concentra vicino alla propria media nella popolazione. L'inferenza nella regressione utilizza un ragionamento analogo perché, sotto ipotesi appropriate, l'errore di uno stimatore può essere rappresentato approssimativamente come una media di contributi casuali. Una studentizzazione valida richiede inoltre una stima consistente dell'errore standard.
Consideriamo una variabile di Bernoulli che assume valore uno con probabilità 0.8 e zero altrimenti. Ogni osservazione rimane binaria per qualsiasi numerosità campionaria. La sua media è 0.8 e la sua varianza è . La deviazione standard della sua media campionaria è quindi . Per numerosità campionarie pari a 10, 100, 1,000 e 10,000, essa diventa rispettivamente circa 0.1265, 0.0400, 0.01265 e 0.0040.
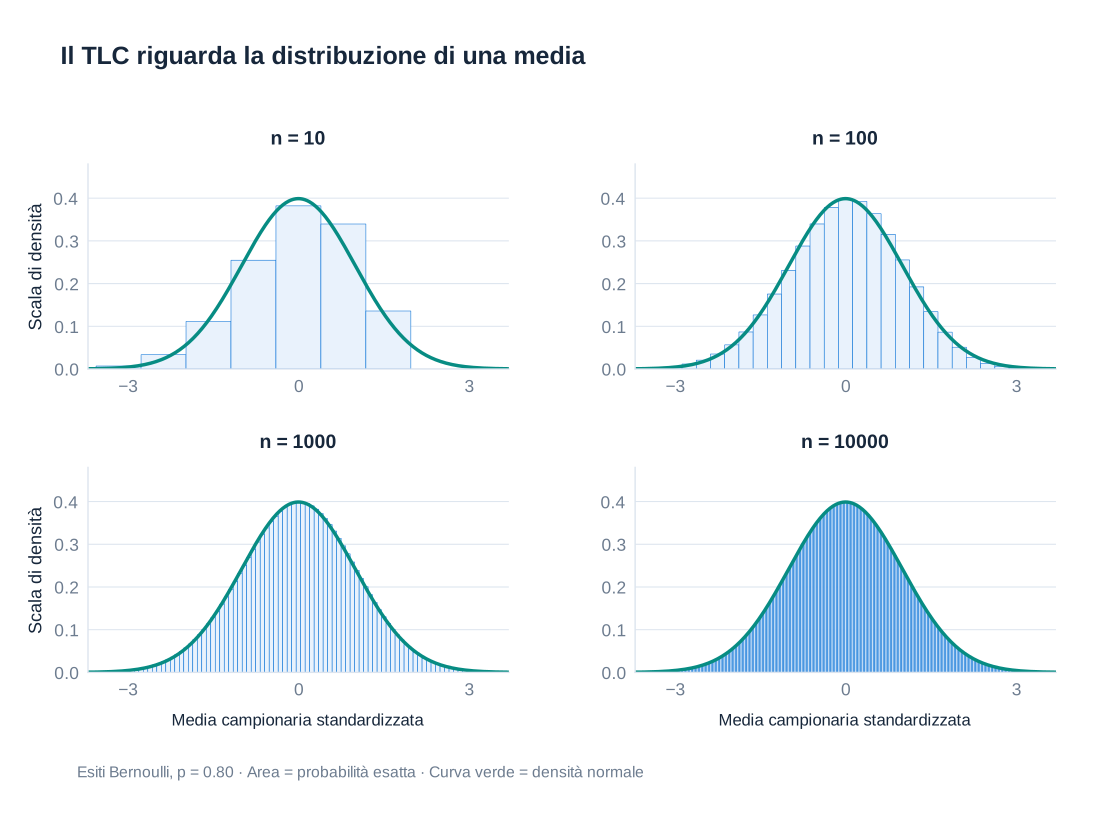
La distribuzione della media campionaria è discreta, con valori possibili separati da . Nei piccoli campioni può essere visibilmente asimmetrica perché la probabilità di successo è elevata; nei campioni più ampi la sua forma standardizzata è ben approssimata dalla distribuzione normale. L'approssimazione non è una conseguenza automatica di un elevato numero di righe. Code pesanti, dipendenza, identificazione debole oppure un numero limitato di cluster indipendenti possono compromettere le condizioni necessarie per i consueti ragionamenti sui grandi campioni.
Regioni di rifiuto e significatività statistica
Un livello di significatività specifica la probabilità di rifiutare un'ipotesi nulla vera che la procedura di verifica è progettata per controllare sotto le proprie ipotesi. Per un test bilaterale con distribuzione normale standard di riferimento, un livello di significatività del 5% colloca il 2.5% in ciascuna coda e utilizza valori critici approssimativamente pari a e . Rifiutare quando individua quindi stime insolitamente lontane dall'ipotesi nulla rispetto alla loro variabilità campionaria stimata.
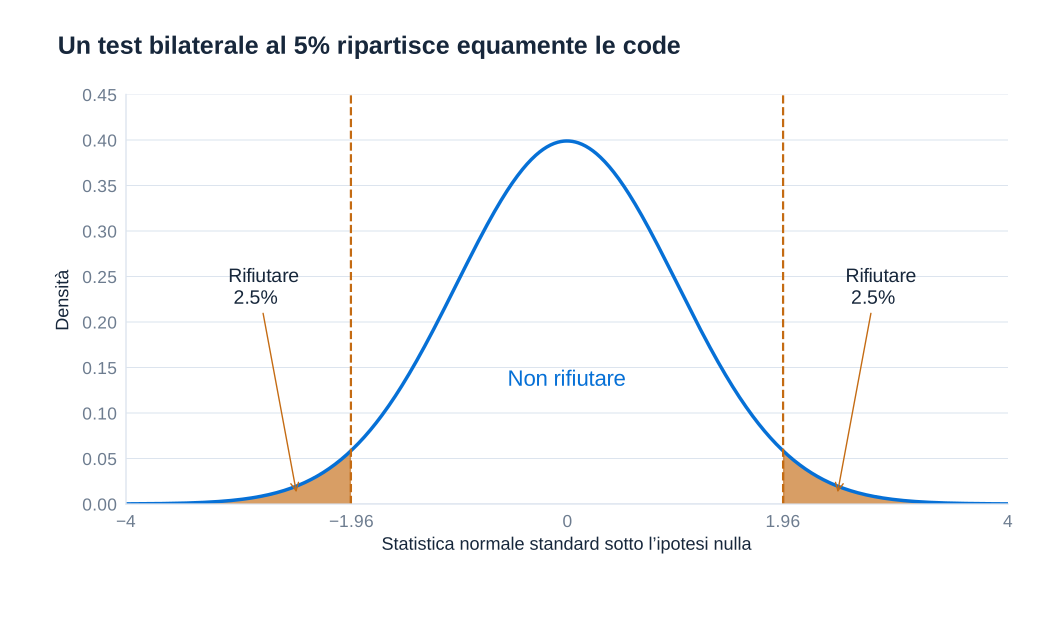
La consueta affermazione secondo cui circa il 95% di una distribuzione normale si trova entro due deviazioni standard è un'approssimazione utile; la probabilità normale centrale esatta tra e è circa il 95%, mentre l'intervallo da a contiene circa il 95.45%. Un test t esatto utilizza un valore critico basato sui propri gradi di libertà, che nei campioni finiti è maggiore di 1.96.
Un rifiuto non dimostra che vi sia una probabilità del 95% che l'alternativa sia vera. Il mancato rifiuto non dimostra che l'ipotesi nulla sia vera. I test possono commettere un errore di tipo I rifiutando un'ipotesi nulla vera oppure un errore di tipo II non rifiutando un'ipotesi nulla falsa. La potenza è la probabilità di rifiuto sotto una specifica alternativa; campioni piccoli e misurazioni rumorose possono rendere difficile individuare effetti economicamente importanti. I test unilaterali collocano la regione di rifiuto in una sola direzione e dovrebbero essere giustificati prima di esaminare il segno stimato.
I p-value esprimono l'incompatibilità con il modello sotto l'ipotesi nulla
Un p-value è la probabilità, calcolata sotto l'ipotesi nulla e le ipotesi statistiche mantenute, di ottenere una statistica test almeno tanto estrema quanto quella osservata. Per un test bilaterale basato sulla normale standard,
dove è la funzione di distribuzione cumulata della normale standard. Con un'appropriata distribuzione t di riferimento, la sua funzione di distribuzione cumulata sostituisce . Il calcolo comprende risultati più estremi della statistica osservata; non è la probabilità di ottenere esattamente quella stima.
Un p-value di 0.04 significa che, se valessero l'ipotesi nulla e il modello statistico, una statistica almeno altrettanto estrema si verificherebbe con probabilità del 4%. Costituisce evidenza contro quell'ipotesi nulla al livello del 5%, non una probabilità del 4% che l'ipotesi nulla sia vera né la prova che l'effetto stimato sia causale. Un p-value di 0.50 indica evidenza più debole contro l'ipotesi nulla, ma non dimostra che il vero effetto sia zero. Può riflettere un effetto piccolo, una stima imprecisa oppure entrambe le cose.
La significatività statistica è inoltre diversa dall'importanza economica. Un effetto minuscolo può produrre un p-value piccolo in un campione molto ampio, mentre una stima elevata ma imprecisa può non superare una soglia convenzionale. Le unità di misura dell'effetto, l'intervallo di confidenza, la rilevanza sostanziale e le ipotesi di identificazione dovrebbero accompagnare il p-value. Verificare molti risultati o molte specificazioni e riportare soltanto i p-value più piccoli modifica l'interpretazione dei livelli nominali di significatività.
Gli intervalli di confidenza conservano informazioni sull'entità dell'effetto
Un intervallo di confidenza bilaterale combina la stima con un margine di incertezza:
dove è il valore critico corrispondente al livello di confidenza e alla distribuzione di riferimento. Una procedura di confidenza al 95% è costruita in modo che, su campioni ripetuti e sotto le proprie ipotesi, circa il 95% degli intervalli risultanti contenga il parametro fisso della popolazione. Una volta calcolato uno specifico intervallo, i suoi estremi sono fissi e il parametro si trova al suo interno oppure no; l'interpretazione frequentista non è una probabilità a posteriori assegnata a quel parametro.
Quando l'intervallo e il test utilizzano le stesse ipotesi e la stessa distribuzione di riferimento, l'intervallo contiene i valori del parametro sotto l'ipotesi nulla che il corrispondente test bilaterale al 5% non rifiuterebbe. Se zero è esterno a un intervallo al 95%, il coefficiente è statisticamente distinguibile da zero a quel livello. Se zero è interno, l'intervallo può comunque includere valori positivi o negativi economicamente rilevanti. Leggere l'intero intervallo fornisce quindi più informazioni che aggiungere un asterisco di significatività alla stima puntuale.
Un esempio completo di regressione dei punteggi nei test
La regressione dei punteggi medi dei distretti nei test sul rapporto studenti/insegnanti utilizza 420 osservazioni ed errori standard robusti all'eteroschedasticità. L'equazione stimata è . La regressione spiega circa il 5.12% della variazione campionaria del risultato, quindi . La radice dell'errore quadratico medio è pari a 18.581 punti del test. Queste statistiche di adattamento descrivono l'adattamento della regressione al campione e la scala dei residui, non la validità di un'interpretazione causale.
| Regressore | Coefficiente | Errore standard robusto | Statistica t | p-value bilaterale | Intervallo di confidenza al 95% |
|---|---|---|---|---|---|
| Rapporto studenti/insegnanti | −2.279808 | 0.5194892 | −4.39 | < 0.001 | [−3.300945, −1.258671] |
| Intercetta | 698.933 | 10.36436 | 67.44 | < 0.001 | [678.5602, 719.3057] |
Verificare che il coefficiente del rapporto sia zero dà . L'output utilizza 418 gradi di libertà residui e riporta per la restrizione su un solo coefficiente; in questo caso la statistica F è il quadrato della statistica t, a meno degli arrotondamenti. Il p-value bilaterale del coefficiente del rapporto, usando questa distribuzione t di riferimento, è circa 0.0000145. Un p-value visualizzato come 0.000 dopo l'arrotondamento significa quindi molto piccolo, non letteralmente nullo.
Il valore critico t al 95% con 418 gradi di libertà è circa 1.96566. Applicandolo si ottiene l'intervallo riportato . L'approssimazione normale con 1.96 fornisce l'intervallo molto simile . Combinare un coefficiente fortemente arrotondato, un valore critico diverso ed estremi riportati con maggiore precisione creerebbe discrepanze aritmetiche apparenti, quindi nei calcoli occorre mantenere la precisione originaria fino alla presentazione finale.
L'intervallo descrive l'incertezza sull'associazione di regressione sotto le ipotesi del modello mantenuto. Un rapporto maggiore di un'unità è associato a una diminuzione compresa tra circa 1.26 e 3.30 punti del test a questo livello di confidenza. Rimane valido il ragionamento del capitolo precedente sul reddito omesso: gli errori standard robusti affrontano un problema di varianza, non il confondimento che può separare questo coefficiente dall'effetto causale di una variazione nella dimensione delle classi.
Eteroschedasticità ed errori standard robusti
Omoschedasticità significa che la varianza condizionata del disturbo è costante: . Eteroschedasticità significa che questa varianza cambia al variare dei regressori o di altre caratteristiche osservate. Un grafico può mostrare osservazioni più disperse intorno alla media condizionata per valori maggiori di . La pendenza di quella media e l'ampiezza della distribuzione del disturbo sono caratteristiche distinte del modello.
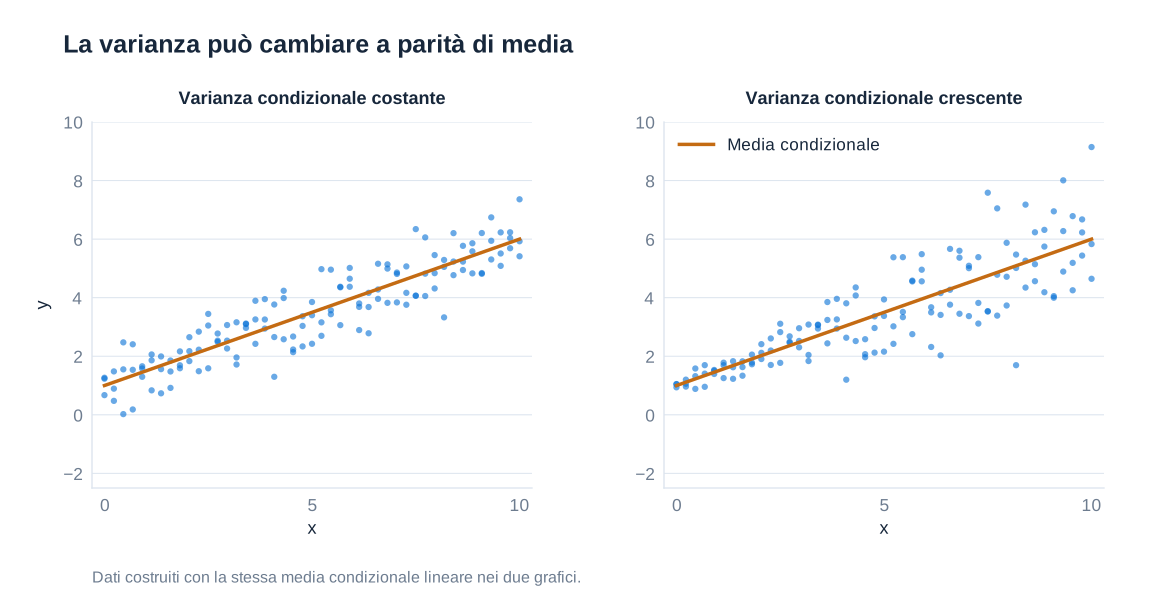
Se continuano a valere l'esogeneità e le condizioni di campionamento rilevanti, l'eteroschedasticità non rende di per sé inconsistenti i coefficienti OLS. Invalida però la formula convenzionale della varianza sotto omoschedasticità. Gli errori standard calcolati con tale formula possono essere troppo piccoli oppure troppo grandi; la distorsione verso il basso e la significatività sovrastimata sono preoccupazioni frequenti, ma la direzione non è garantita.
Per una regressione semplice con intercetta e osservazioni indipendenti, lo stimatore di base della varianza robusto all'eteroschedasticità può essere scritto come
Ogni residuo al quadrato contribuisce separatamente, consentendo alla varianza del disturbo di differire tra osservazioni. Altri stimatori robusti correggono per i gradi di libertà o per i valori di leva; la versione HC1 moltiplica la stima della varianza per . Passare dagli errori standard convenzionali a quelli robusti lascia invariate le stime puntuali OLS quando il campione e la specificazione della regressione non cambiano, ma può modificare intervalli di confidenza, statistiche t e p-value.
Gli errori standard robusti all'eteroschedasticità non sono una correzione generale per la dipendenza tra osservazioni, le variabili omesse o l'errore di misurazione. Possono inoltre essere poco affidabili in campioni piccoli o in presenza di osservazioni influenti. Il termine “robusto” descrive la specifica restrizione sulla varianza che viene allentata, non un'immunità da ogni problema di modellizzazione.
Osservazioni dipendenti e inferenza per cluster
Le osservazioni all'interno di un gruppo condividono spesso shock non osservati. Per osservazioni ripetute sugli Stati, un esempio semplice è , dove è una componente persistente dello Stato. Due osservazioni sullo stesso Stato possono quindi avere errori correlati nel tempo. In alternativa, rappresenta uno shock comune dell'anno che colpisce Stati diversi. Gli indici sono importanti perché questi processi implicano strutture di dipendenza diverse e, potenzialmente, scelte diverse di raggruppamento in cluster.
Gli aiuti federali ricevuti da uno Stato in anni successivi, per esempio, possono essere influenzati da caratteristiche persistenti dello Stato e da programmi in corso. Trattare ogni osservazione Stato-anno come una fonte di informazione indipendente può sovrastimare la precisione. Gli ordinari errori standard robusti all'eteroschedasticità ammettono varianze individuali diverse, ma omettono i termini di covarianza tra osservazioni differenti. Gli errori standard robusti per cluster conservano questi termini di covarianza interni al gruppo, facendo affidamento su un'appropriata indipendenza o dipendenza debole tra cluster.
Indicando la matrice dei regressori per il cluster con e il suo vettore dei residui con , lo stimatore di base della matrice di covarianza robusto per cluster è
Nella pratica si applicano spesso correzioni per campioni finiti. Il raggruppamento in cluster non richiede di calcolare medie dei dati ottenendo una sola osservazione per gruppo: la regressione può mantenere tutte le osservazioni individuali, mentre il calcolo della varianza riconosce la loro dipendenza. Il livello appropriato dipende dal disegno dello studio, dall'assegnazione del trattamento e dagli shock condivisi plausibili. In presenza di dipendenza persistente a livello di Stato, il raggruppamento per Stato ammette una correlazione arbitraria nel tempo all'interno dello stesso Stato. Una dipendenza che si manifesta sia all'interno degli Stati sia tra Stati nello stesso anno può richiedere un metodo che tenga conto di entrambe le dimensioni.
L'inferenza convenzionale per cluster dipende principalmente dal numero e dal comportamento dei cluster indipendenti, non semplicemente dal numero complessivo di righe. Non esiste una soglia universale oltre la quale diventi affidabile: pochi cluster molto grandi, un'assegnazione disomogenea del trattamento o valori di leva elevati possono rimanere problematici anche quando si rispetta una regola pratica numerica. Con pochi cluster, possono essere necessari metodi appropriati per piccoli campioni oppure un'inferenza basata sul disegno dello studio. Infine, la dipendenza seriale non deve essere confusa con l'esogeneità: cambiare lo stimatore dell'errore standard non corregge un coefficiente reso inconsistente dalla correlazione tra regressori e disturbi.