
2. Randomizzazione e regressione lineare
Un confronto causale dovrebbe isolare il cambiamento di interesse mantenendo costanti le alternative rilevanti. L'assegnazione casuale offre un termine di riferimento per questo compito. La regressione lineare permette di descrivere le relazioni e, sotto ipotesi aggiuntive, di effettuare confronti tra osservazioni comparabili utilizzando dati osservazionali. Comprendere la distinzione tra ciò che uno stimatore calcola e ciò che le sue ipotesi di identificazione giustificano è essenziale per entrambi gli approcci.
L'assicurazione sanitaria e il problema della comparabilità
Consideriamo la domanda se l'assicurazione sanitaria migliori la salute. Confrontare persone assicurate e non assicurate sembra semplice: si calcola la salute media in ciascun gruppo e si sottraggono i due valori. La difficoltà è che la copertura assicurativa non viene generalmente assegnata in modo casuale. Persone con coperture diverse possono differire anche per reddito, istruzione, occupazione, età e salute iniziale. Questi fattori possono influenzare sia la copertura sia i risultati successivi.
La National Health Interview Survey del 2009 illustra il problema. Tra i rispondenti coniugati del campione riportato, i mariti assicurati presentavano un indice medio di salute pari a 4.01, contro 3.70 per i mariti non assicurati. La differenza riportata era 0.31. Anche le mogli assicurate presentavano un indice medio più elevato. Tuttavia, i rispondenti assicurati erano sostanzialmente più istruiti e avevano redditi familiari molto più alti. Il confronto combina quindi l'assicurazione con altre differenze potenzialmente rilevanti per la salute.
| Caratteristica | Mariti assicurati | Mariti non assicurati | Differenza, mariti | Mogli assicurate | Mogli non assicurate | Differenza, mogli |
|---|---|---|---|---|---|---|
| Indice di salute | 4.01 [0.93] | 3.70 [1.01] | 0.31 (0.03) | 4.02 [0.92] | 3.62 [1.01] | 0.39 (0.04) |
| Quota di persone non bianche | 0.16 | 0.17 | −0.01 (0.01) | 0.15 | 0.17 | −0.02 (0.01) |
| Età, anni | 43.98 | 41.26 | 2.71 (0.29) | 42.24 | 39.62 | 2.62 (0.30) |
| Istruzione, anni | 14.31 | 11.56 | 2.74 (0.10) | 14.44 | 11.80 | 2.64 (0.11) |
| Numero di componenti della famiglia | 3.50 | 3.98 | −0.47 (0.05) | 3.49 | 3.93 | −0.43 (0.05) |
| Quota di occupati | 0.92 | 0.85 | 0.07 (0.01) | 0.77 | 0.56 | 0.21 (0.02) |
| Reddito familiare, dollari statunitensi | 106,467 | 45,656 | 60,810 (1,355) | 106,212 | 46,385 | 59,828 (1,406) |
I campioni di assicurati e non assicurati comprendono rispettivamente 8,114 e 1,281 mariti e 8,264 e 1,131 mogli. Le parentesi quadre riportano le deviazioni standard dell'indice di salute; le parentesi tonde riportano gli errori standard delle differenze. Le differenze sono le stime originariamente riportate e possono discostarsi leggermente dalla sottrazione delle medie arrotondate visualizzate. Una deviazione standard descrive la dispersione tra individui; un errore standard descrive l'incertezza di una media o di una differenza stimata. Nessuno dei due risolve il problema della comparabilità.
Risultati potenziali e distorsione da selezione
Indichiamo con la presenza di assicurazione e con la sua assenza. L'individuo ha due risultati potenziali: è la salute con assicurazione e è la salute senza assicurazione. L'effetto causale individuale è . Per ciascun individuo, nel momento rilevante, si osserva un solo risultato potenziale:
Il risultato non osservato è il controfattuale. Il seguente esempio ipotetico rende concreto il problema che ne deriva. Khuzdar sceglie di assicurarsi e Maria no. Il confronto osservato è , sebbene l'assicurazione migliori di un punto la salute di Khuzdar e non abbia alcun effetto sulla salute di Maria.
| Grandezza | Khuzdar | Maria |
|---|---|---|
| Salute senza assicurazione, | 3 | 5 |
| Salute con assicurazione, | 4 | 5 |
| Condizione assicurativa scelta, | 1 | 0 |
| Salute osservata, | 4 | 5 |
| Effetto causale individuale | 1 | 0 |
Aggiungere e sottrarre il risultato potenziale di Khuzdar senza assicurazione scompone la differenza osservata nell'effetto dell'assicurazione e in una differenza preesistente:
La scomposizione generale rende esplicita la grandezza a cui si riferisce il termine causale:
Il primo termine è l'effetto medio del trattamento sui trattati, o ATT. Il secondo è la distorsione da selezione: la differenza tra i gruppi nei risultati potenziali in assenza di trattamento. Non deve necessariamente coincidere con una differenza direttamente osservabile. Istruzione e reddito possono rivelare alcune fonti di selezione; preferenze, condizioni iniziali o altri fattori non misurati possono non rivelarne alcuna. Inoltre, quando gli effetti differiscono tra individui, l'ATT non coincide necessariamente con l'effetto medio del trattamento sull'intera popolazione.
Assegnazione casuale e legge dei grandi numeri
L'assegnazione casuale rende lo stato di trattamento indipendente dai risultati potenziali. Con un trattamento ben definito e in assenza di interferenze tra individui, implica che i risultati potenziali medi in assenza di trattamento siano uguali tra i gruppi di assegnazione nella popolazione. Rende inoltre comparabili i gruppi trattati e non trattati rispetto ai loro effetti medi del trattamento. La differenza tra le medie dei gruppi può quindi identificare l'effetto causale medio.
La randomizzazione bilancia le caratteristiche in valore atteso; non rende identico ogni campione effettivamente realizzato. Il lancio di una moneta che assegna al trattamento una persona su due non può evidentemente garantire la corrispondenza di età, redditi o generi. Campioni più grandi tendono a ridurre gli squilibri accidentali, ma un campione ampio non sostituisce un'assegnazione effettivamente casuale. Anche il campionamento casuale e l'assegnazione casuale sono distinti: il primo riguarda la rappresentazione di una popolazione, mentre la seconda riguarda la comparabilità dei gruppi di trattamento.
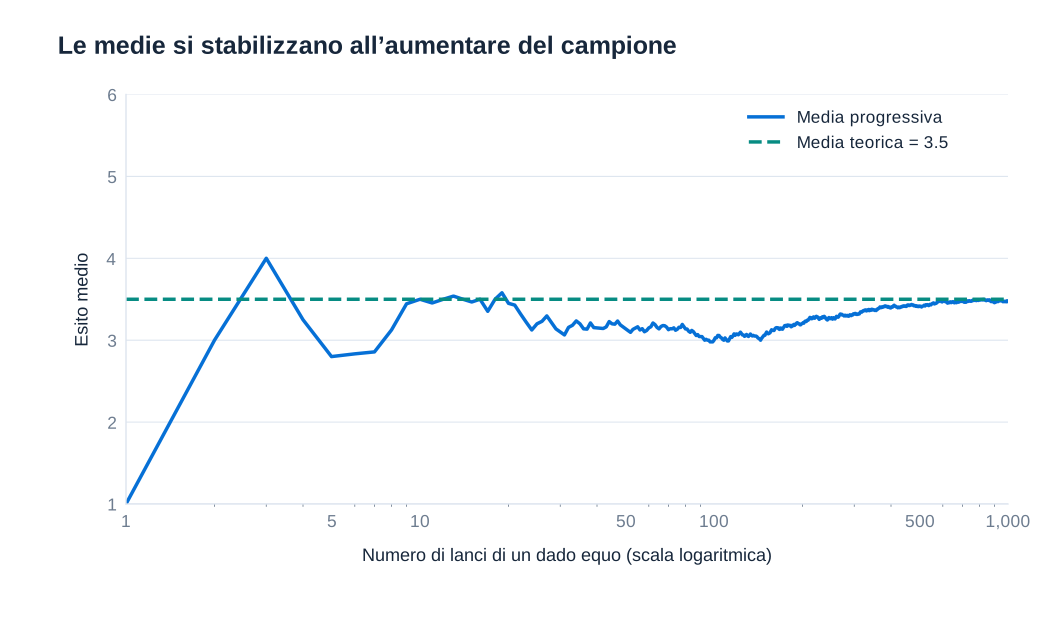
La legge dei grandi numeri spiega perché le medie si stabilizzino. Per osservazioni indipendenti e identicamente distribuite con valore atteso finito, una versione standard afferma:
La convergenza in probabilità significa che, al crescere del campione, la probabilità di uno scostamento superiore a una qualsiasi tolleranza positiva fissata tende a zero. Per un dado equo a sei facce, il risultato atteso è . Una media progressiva può oscillare ampiamente all'inizio e poi stabilizzarsi vicino a 3.5. Non deve necessariamente avvicinarsi a 3.5 in modo monotono e nessuna soglia universale, come 100 osservazioni, garantisce una precisione adeguata.
La dimensione campionaria necessaria dipende dalla variabilità del risultato, dall'effetto del trattamento di interesse, dallo schema di assegnazione e dalla precisione desiderata. La presenza di cluster può ridurre l'informazione fornita da un campione nominalmente ampio, perché le osservazioni all'interno di un gruppo possono essere correlate. Anche la mancata adesione all'assegnazione, l'abbandono del campione e gli effetti di propagazione possono modificare l'interpretazione di un esperimento. L'effetto dell'assegnazione all'assicurazione, per esempio, non coincide necessariamente con l'effetto di ricevere effettivamente una copertura, se alcune persone non rispettano l'assegnazione ricevuta.
Come leggere una tabella di bilanciamento
Una tabella di bilanciamento confronta caratteristiche misurate prima del trattamento. Aiuta a valutare se i gruppi di assegnazione appaiano comparabili e se l'attuazione o l'abbandono del campione abbiano creato differenze problematiche. Il RAND Health Insurance Experiment offre un esempio che confronta piani più generosi con un piano di copertura per eventi catastrofici. La prima colonna numerica seguente riporta la media iniziale del gruppo con copertura catastrofica. Le altre colonne riportano le differenze rispetto a quella media, non le medie dei gruppi alternativi.
| Caratteristica | Media: copertura catastrofica | Differenza: franchigia | Differenza: compartecipazione | Differenza: cure gratuite | Differenza: piani alternativi aggregati |
|---|---|---|---|---|---|
| Quota femminile | 0.560 | −0.023 (0.016) | −0.025 (0.015) | −0.038 (0.015) | −0.030 (0.013) |
| Quota di persone non bianche | 0.172 | −0.019 (0.027) | −0.027 (0.025) | −0.028 (0.025) | −0.025 (0.022) |
| Età, anni | 32.4 [12.9] | 0.56 (0.68) | 0.97 (0.65) | 0.43 (0.61) | 0.64 (0.54) |
| Istruzione, anni | 12.1 [2.9] | −0.16 (0.19) | −0.06 (0.19) | −0.26 (0.18) | −0.17 (0.16) |
| Reddito familiare, dollari statunitensi | 31,603 [18,148] | −2,104 (1,384) | 970 (1,389) | −976 (1,345) | −654 (1,181) |
| Quota di ricoverati nell'anno precedente | 0.115 | 0.004 (0.016) | −0.002 (0.015) | 0.001 (0.015) | 0.001 (0.013) |
| Indice di salute generale | 70.9 [14.9] | −1.44 (0.95) | 0.21 (0.92) | −1.31 (0.87) | −0.93 (0.77) |
| Colesterolo, mg/dl | 207 [40] | −1.42 (2.99) | −1.93 (2.76) | −5.25 (2.70) | −3.19 (2.29) |
| Pressione arteriosa sistolica, mm Hg | 122 [17] | 2.32 (1.15) | 0.91 (1.08) | 1.12 (1.01) | 1.39 (0.90) |
| Indice di salute mentale | 73.8 [14.3] | −0.12 (0.82) | 1.19 (0.81) | 0.89 (0.77) | 0.71 (0.68) |
Le deviazioni standard, dove riportate per il gruppo con copertura catastrofica, compaiono tra parentesi quadre; gli errori standard delle differenze compaiono tra parentesi tonde. I partecipanti erano 759 nella copertura catastrofica, 881 nel piano con franchigia, 1,022 nel piano con compartecipazione e 1,295 nel piano con cure gratuite. L'ultima colonna aggrega i 3,198 partecipanti ai tre piani alternativi. La copertura catastrofica è essa stessa un'assicurazione: si tratta quindi di un confronto della generosità assicurativa, non di un confronto con la completa assenza di copertura.
Per esempio, la quota femminile del gruppo con cure gratuite è approssimativamente . Il suo indice iniziale di salute generale è approssimativamente . La tabella non mostra l'effetto delle cure gratuite sulla salute: si tratta di caratteristiche iniziali, misurate prima che il trattamento potesse produrre i successivi risultati di interesse.
Alcune differenze iniziali possono risultare statisticamente significative per caso, soprattutto quando si esaminano molte caratteristiche. La differenza nella quota femminile per il gruppo con cure gratuite dista da zero circa 2.53 errori standard. Questa osservazione dovrebbe essere interpretata insieme alla procedura di assegnazione e al quadro complessivo del bilanciamento, anziché essere considerata una prova automatica del fallimento della randomizzazione. Viceversa, differenze non significative non dimostrano che le caratteristiche inosservate siano bilanciate o che in un campione piccolo non esistano squilibri importanti.
Il modello di popolazione e la soluzione dei minimi quadrati
Quando l'assegnazione casuale non è disponibile, una regressione può descrivere come un risultato vari al variare di una variabile esplicativa. Il modello lineare semplice è:
Qui è il risultato, la variabile esplicativa, l'intercetta e la pendenza. Il termine di errore raccoglie le restanti determinanti del risultato e gli scostamenti dalla relazione specificata. I coefficienti sono grandezze della popolazione; le loro stime variano da un campione all'altro. Il termine di errore è una variabile casuale non osservata, non un parametro fisso della popolazione.
Il metodo dei minimi quadrati ordinari, o OLS, sceglie l'intercetta e la pendenza che minimizzano la somma dei quadrati degli scostamenti verticali tra i risultati osservati e la retta stimata:
L'elevamento al quadrato impedisce che gli scostamenti positivi e negativi si annullino e attribuisce un peso maggiore alle discrepanze ampie. Derivando rispetto ai due coefficienti si ottengono le equazioni normali e . Risolvendole, quando varia nel campione, si ottiene:
Il denominatore è una somma di scostamenti al quadrato. Senza il quadrato, gli scostamenti dalla media campionaria hanno somma pari a zero. La pendenza può essere scritta in modo equivalente come rapporto tra covarianza campionaria e varianza campionaria, purché entrambe utilizzino la stessa normalizzazione. Sotto l'appropriata condizione di ortogonalità nella popolazione, la corrispondente pendenza di popolazione è .
Valori stimati, residui e geometria della regressione
Il valore stimato è . Il residuo è il risultato osservato meno questa previsione, . È una distanza verticale perché il criterio prevede condizionatamente a ; OLS non minimizza le distanze perpendicolari alla retta.
In un esempio numerico, la retta stimata è e la somma dei quadrati dei residui è 384. Per , la retta prevede 23.07. Un'osservazione superiore a tale valore ha un residuo positivo, mentre una inferiore ha un residuo negativo. Il valore 384 descrive la somma complessiva degli scostamenti al quadrato nel campione e dipende dalla scala del risultato e dal numero di osservazioni; non è di per sé una misura della credibilità causale.
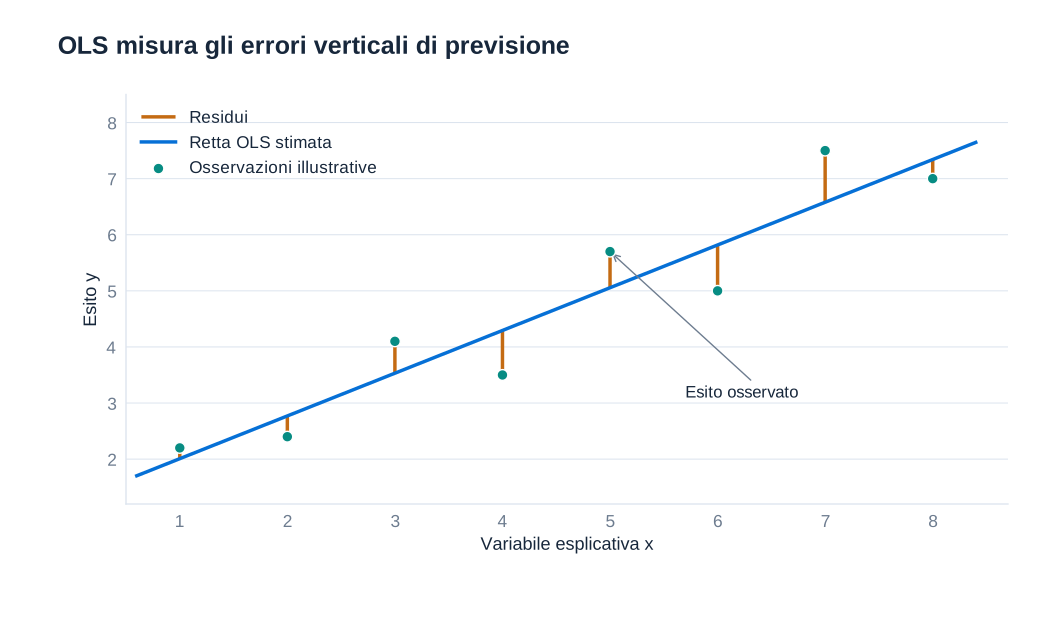
In presenza di un'intercetta, le equazioni normali implicano identità campionarie esatte:
La retta passa quindi per e i residui sono ortogonali al regressore incluso e ai valori stimati nel campione. Si tratta di proprietà algebriche del calcolo OLS. Non dimostrano che il termine di errore della popolazione non sia associato a . Una determinante omessa correlata con può distorcere il coefficiente anche se i residui stimati soddisfano tutte queste identità.
Mantenere distinti e evita un errore comune. Il primo appartiene al modello di popolazione e non è osservato direttamente; il secondo è calcolato dopo aver stimato il modello. Esaminare i residui può rivelare andamenti sistematici, osservazioni insolite o forme funzionali inappropriate, ma la covarianza campionaria nulla tra un regressore incluso e i suoi residui OLS è garantita per costruzione.
I punteggi dei test e il significato di una pendenza
Un dataset di 420 distretti scolastici della California mette in relazione i punteggi medi dei test con il rapporto studenti-insegnanti. La relazione stimata, utilizzando le stime dei coefficienti riportate e arrotondate a due cifre decimali, è:
La pendenza associa uno studente aggiuntivo per insegnante a un punteggio previsto inferiore di 2.28 punti. Una riduzione del rapporto di due studenti per insegnante corrisponde a un aumento di 4.56 punti del risultato stimato. Per un rapporto pari a 20, la previsione è ; per un rapporto pari a 18 è 657.86. Si tratta di previsioni ricavate dalla retta stimata, non del risultato osservato in ogni distretto con quei rapporti.
Rispetto a un punteggio medio del test di circa 654, una variazione di 2.28 punti equivale a circa . Questo calcolo permette di valutare l'ordine di grandezza del coefficiente. Non rende 0.35% il coefficiente di regressione e non indica una variazione di 0.35 punti percentuali. In un modello lineare-lineare, il coefficiente diretto misura sempre unità del risultato per unità della variabile esplicativa.
L'intercetta è il risultato previsto quando il rapporto studenti-insegnanti è zero, valore esterno all'intervallo rilevante dei dati. Contribuisce a posizionare la retta stimata, ma ha scarso valore sostanziale come previsione letterale. Estrapolare molto oltre l'intervallo osservato è rischioso, perché un andamento lineare all'interno di quell'intervallo non deve necessariamente proseguire altrove.
Soprattutto, la sola pendenza negativa non dimostra che assumere insegnanti causi il miglioramento previsto. Il reddito del distretto, la composizione linguistica e altre risorse possono essere associati sia alla numerosità delle classi sia ai punteggi dei test. L'aggiustamento mediante regressione può confrontare distretti con caratteristiche misurate simili, ma controllare per le caratteristiche osservabili non elimina automaticamente le differenze inosservate. Un'interpretazione causale richiede un'argomentazione sulle determinanti che rimangono nel termine di errore.
Assenza di distorsione, consistenza e compromesso tra distorsione e varianza
Uno stimatore è una regola applicata a un campione; una stima è il suo risultato numerico effettivamente ottenuto. Ripetere il processo di campionamento produce una distribuzione campionaria. L'assenza di distorsione significa che la media di questa distribuzione coincide con il parametro della popolazione: . Non significa che ogni stima coincida con il parametro. Uno stimatore non distorto può essere impreciso e produrre singole stime lontane dal valore vero.
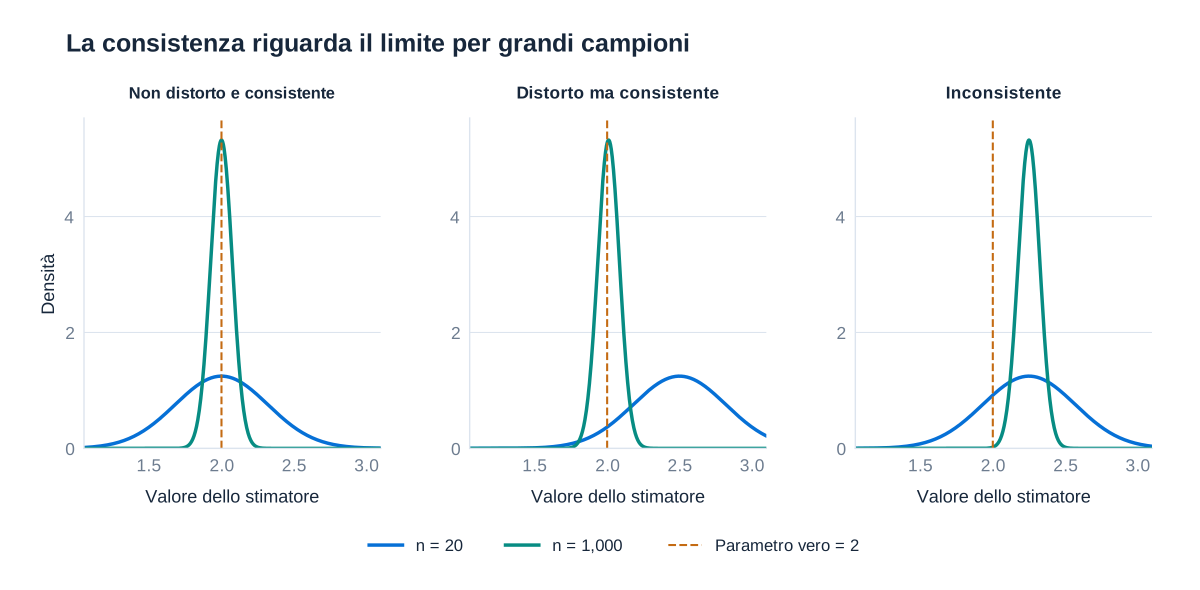
La consistenza riguarda una successione di stimatori al crescere della dimensione campionaria. Formalmente, . La probabilità di un errore di stima di entità fissata tende quindi a zero. A differenza dell'assenza di distorsione, la consistenza è una proprietà asintotica. Un maggior numero di osservazioni non rende consistente una procedura intrinsecamente inconsistente; può invece concentrare le sue stime intorno al valore sbagliato.
Tre esempi distinguono questi concetti. Primo, supponiamo che soddisfi le condizioni per cui OLS è non distorto e consistente. La distribuzione della pendenza è centrata su 2 e diventa più concentrata al crescere del campione. Secondo, definiamo uno stimatore modificato . Ha una distorsione in campioni finiti pari a , ma è consistente quando OLS è consistente: il termine aggiunto è 0.5 per , 0.01 per e tende a zero.
Terzo, supponiamo che il termine di errore nella stessa equazione strutturale sia , con . Sostituendo si ottiene . Una regressione di su converge a 2.25, non al coefficiente strutturale 2. Aumentare la dimensione campionaria rende più precisa la pendenza descrittiva, lasciando però invariato lo scostamento di 0.25 nell'interpretazione strutturale.
Precisione e distorsione sono dimensioni distinte delle prestazioni. Per uno stimatore scalare, l'errore quadratico medio si scompone come segue:
Uno stimatore con una piccola distorsione può avere un errore quadratico medio inferiore a quello di uno stimatore non distorto molto disperso. Questo compromesso è rilevante nella valutazione degli stimatori, ma non giustifica ignorare una distorsione causale sistematica soltanto perché gli errori standard sono piccoli.
Le ipotesi alla base delle proprietà OLS
Per il consueto risultato di assenza di distorsione in campioni finiti, una condizione centrale è la media condizionata nulla, , insieme a una media condizionata lineare correttamente specificata, condizioni di campionamento appropriate e variabilità di . La media non condizionata nulla, , è una condizione più debole: errori positivi e negativi possono avere media zero pur variando sistematicamente con il regressore. Una covarianza nulla tra e può sostenere la consistenza di una proiezione lineare sotto opportune condizioni di regolarità, ma non dovrebbe essere presentata come equivalente alla media condizionata nulla.
Nella regressione multipla, i regressori non devono essere perfettamente collineari. Nel modello semplice ciò significa che non può essere costante. Senza variabilità di , i dati non possono distinguere l'intercetta dalla pendenza. Il campionamento casuale e le condizioni di esistenza di momenti finiti sostengono le leggi dei grandi numeri e le approssimazioni campionarie. Le osservazioni molto influenti richiedono un esame; il requisito formale non è che non possa esistere alcuna osservazione insolita.
Il risultato di Gauss–Markov aggiunge l'omoschedasticità e l'assenza di correlazione tra i termini di errore di osservazioni diverse, condizionatamente ai regressori. Sotto le ipotesi pertinenti, OLS è il miglior stimatore lineare non distorto, o BLUE. «Migliore» significa con la varianza minima nella classe degli stimatori lineari non distorti. «Lineare» si riferisce al fatto che lo stimatore è una funzione lineare dei risultati osservati, condizionatamente ai regressori. Non significa che si possano modellare soltanto relazioni rappresentate da rette, né che OLS domini ogni possibile stimatore non lineare o distorto.
Per Gauss–Markov non è richiesta la normalità dei termini di errore. In presenza di esogeneità, l'eteroschedasticità può lasciare OLS non distorto e consistente, invalidando però la consueta formula della varianza omoschedastica e la proprietà BLUE. Infine, anche una stima corretta di un'associazione condizionata non dimostra automaticamente un meccanismo causale: l'interpretazione economica dipende dal disegno di ricerca e dal significato del termine di errore.
Che cosa determina la precisione?
In presenza di omoschedasticità e di termini di errore non correlati, la varianza condizionata della pendenza nella regressione semplice è:
L'espressione esatta è condizionata ai valori effettivamente osservati del regressore; l'approssimazione sostituisce la loro somma degli scostamenti al quadrato con la corrispondente grandezza per campioni grandi. Una maggiore varianza del termine di errore rende più difficile stimare la retta. Una maggiore variabilità di fornisce più informazioni sulla sua pendenza. Un maggior numero di osservazioni migliora generalmente la precisione quando aggiunge informazione indipendente. L'errore standard, essendo la radice quadrata della varianza, diminuisce tipicamente a un tasso proporzionale a : quadruplicare la dimensione campionaria lo dimezza quindi approssimativamente, a parità delle altre condizioni.
Nella pratica, la varianza ignota del termine di errore deve essere stimata. Con un'intercetta e una pendenza, uno stimatore omoschedastico convenzionale è , da cui si ottiene . La sottrazione di due riflette i due coefficienti stimati. L'eteroschedasticità o la dipendenza richiedono uno stimatore della varianza adeguato a quel contesto.
Leggere un risultato di regressione comporta quindi tre domande distinte. Quale confronto e quali unità di misura rappresenta il coefficiente? Quali ipotesi giustificano la sua interpretazione come relazione di interesse? Quanta incertezza campionaria rimane? Rispondere soltanto alla prima o alla terza può produrre una conclusione apparentemente precisa che il disegno di ricerca non sostiene.