
6. Variabili dummy ed esiti binari
Indicatori, categorie e confronti che rappresentano
Una variabile binaria o dummy assume il valore 1 quando si verifica una condizione definita e 0 altrimenti. Lo stato occupazionale, la vista sull’oceano di un appartamento e la presenza di ipertensione sono alcuni esempi. Le variabili binarie sono un caso particolare di variabili categoriali, che classificano le osservazioni in un insieme limitato di gruppi. La codifica deve essere dichiarata esplicitamente: invertire 0 e 1 inverte l’interpretazione del confronto associato.
Un codice numerico di categoria non è necessariamente una misurazione quantitativa. Codificare i gruppi sanguigni A, B, AB e O come 1, 2, 3 e 4 non rende il gruppo O “quattro volte” il gruppo A, né stabilisce differenze biologiche equidistanti. Trattare questi codici come un unico regressore continuo imporrebbe un ordinamento arbitrario e variazioni costanti. Indicatori separati consentono a ciascun gruppo di avere una propria media condizionata rispetto a una categoria di riferimento scelta.
Le variabili binarie possono essere utilizzate in regressione in due modi distinti. Un indicatore nel membro di destra rappresenta un confronto tra gruppi, lasciando invariata la natura dell’esito. Un indicatore nel membro di sinistra rende la media condizionata una probabilità, introducendo restrizioni che una comune retta può non rispettare. I principi di stima restano collegati, ma l’interpretazione e gli opportuni controlli diagnostici differiscono.
Una variabile dummy come variabile esplicativa
Si supponga di modellare il canone mensile di un appartamento, in unità monetarie, utilizzando il numero di stanze e un indicatore della vista sull’oceano:
Per un numero di stanze fissato, il canone stimato è senza vista sull’oceano e con la vista. Quindi è la differenza condizionata nel canone mensile, misurata nelle stesse unità monetarie del canone. Il modello assume che questa differenza non vari con il numero di stanze. Aggiungere allenterebbe tale restrizione, consentendo al sovrapprezzo per la vista di variare con le dimensioni dell’appartamento.
“Mantenere costante il numero di stanze” non significa che tutte le altre caratteristiche degli appartamenti siano identiche. Se gli immobili con vista sull’oceano hanno anche una posizione migliore o una qualità costruttiva superiore e queste variabili vengono omesse, il coefficiente può riflettere tali differenze. L’indicatore di gruppo non produce un’assegnazione casuale. Il suo coefficiente è un’associazione condizionata, a meno che le ipotesi di identificazione non giustifichino un’interpretazione ulteriore.
Se la variabile dipendente è il logaritmo del canone, il coefficiente cambia significato: la differenza proporzionale stimata esatta tra appartamenti con e senza vista è %, ferme restando le precisazioni sugli esiti in logaritmi del Capitolo 5. Se un indicatore interagisce con un altro regressore, il suo coefficiente considerato isolatamente si applica quando quell’altro regressore è zero e il confronto completo tra gruppi deve includere l’interazione.
Categorie multiple e trappola delle variabili dummy
Si consideri un esempio relativo ai distretti scolastici che suddivide la disponibilità di computer nelle categorie bassa, media e alta utilizzando il 25° e il 75° percentile. Per definire una classificazione completa, si assegnano alla categoria bassa i valori inferiori al 25° percentile, alla categoria media quelli dal 25° al 75° percentile inclusi e alla categoria alta quelli superiori al 75° percentile. I valori coincidenti richiedono una regola coerente per i confini; i gruppi non devono necessariamente contenere esattamente il 25%, il 50% e il 25% delle osservazioni.
Siano e gli indicatori di disponibilità media e alta. Utilizzando la disponibilità bassa come riferimento, si stima:
L’intercetta è la media del gruppo con disponibilità bassa e i due coefficienti di pendenza sono differenze rispetto a essa. Includere tutti e tre gli indicatori di gruppo insieme a un’intercetta produce multicollinearità perfetta, perché la loro somma è esattamente 1. È la trappola delle variabili dummy. Omettere una categoria mantenendo l’intercetta risolve il problema; in alternativa, omettere l’intercetta e mantenere tutte le categorie consente di stimare separatamente le medie dei gruppi. Nessuna delle due opzioni elimina le osservazioni del gruppo di riferimento.
| Termine | Coefficiente | Errore standard | Statistica t | p-value | Intervallo di confidenza al 95% |
|---|---|---|---|---|---|
| Media rispetto a bassa | 0.8566319 | 2.275697 | 0.38 | 0.707 | [−3.616636, 5.3299] |
| Alta rispetto a bassa | −0.9260766 | 2.627719 | −0.35 | 0.725 | [−6.091303, 4.23915] |
| Intercetta: categoria bassa | 653.9618 | 1.85367 | 352.79 | <0.001 | [650.3181, 657.6055] |
Le medie stimate sono circa 653.96 punti per la disponibilità bassa, 654.82 per quella media e 653.04 per quella alta. Entrambi gli intervalli delle differenze includono zero. Il test congiunto dei due coefficienti di categoria restituisce , con ; , corretto e una radice dell’errore quadratico medio pari a 19.085 punti del test. Questi risultati forniscono scarsa evidenza di differenze in questa semplice suddivisione. Non dimostrano che l’accesso ai computer sia privo di un effetto causale: la specificazione è un confronto tra gruppi senza aggiustamenti e la misura riguarda la disponibilità di computer, anziché un intervento assegnato casualmente.
Esiti binari e modello di probabilità lineare
Per un esito binario , il suo valore atteso condizionato è uguale alla sua probabilità di essere pari a 1: . Applicare l’OLS a un esito binario produce quindi un modello di probabilità lineare, o LPM. In , un aumento di un’unità di modifica la probabilità stimata di , ossia di punti percentuali. La scala è fondamentale: un coefficiente di 0.05 significa cinque punti percentuali, non automaticamente un aumento relativo del 5%.
Per i distretti scolastici, si definisce quando il punteggio medio del distretto nei test supera la media complessiva scelta e 0 altrimenti. Una regressione sul reddito medio del distretto produce i seguenti risultati. Il reddito viene mantenuto nelle unità registrate nel dataset, quindi la pendenza si applica a un’unità su quella scala; qualsiasi conversione monetaria deve essere applicata prima di interpretare una variazione espressa in unità diverse.
| Termine | Coefficiente | Errore standard robusto | Statistica t | p-value | Intervallo di confidenza al 95% |
|---|---|---|---|---|---|
| Reddito medio del distretto | 0.0328825 | 0.0029316 | 11.22 | <0.001 | [0.0271201, 0.038645] |
| Intercetta | 0.0034945 | 0.0504409 | 0.07 | 0.945 | [−0.095655, 0.102644] |
Le osservazioni sono 420; , la radice dell’errore quadratico medio è 0.44108 e il test complessivo robusto è , con . Un aumento del reddito di un’unità è associato a una probabilità superiore di circa 3.288 punti percentuali di ottenere un punteggio sopra la media. Questo confronto riguarda il superamento di una soglia binaria, non il numero di punti guadagnati nel test.
Limiti delle probabilità, eteroschedasticità e punti percentuali
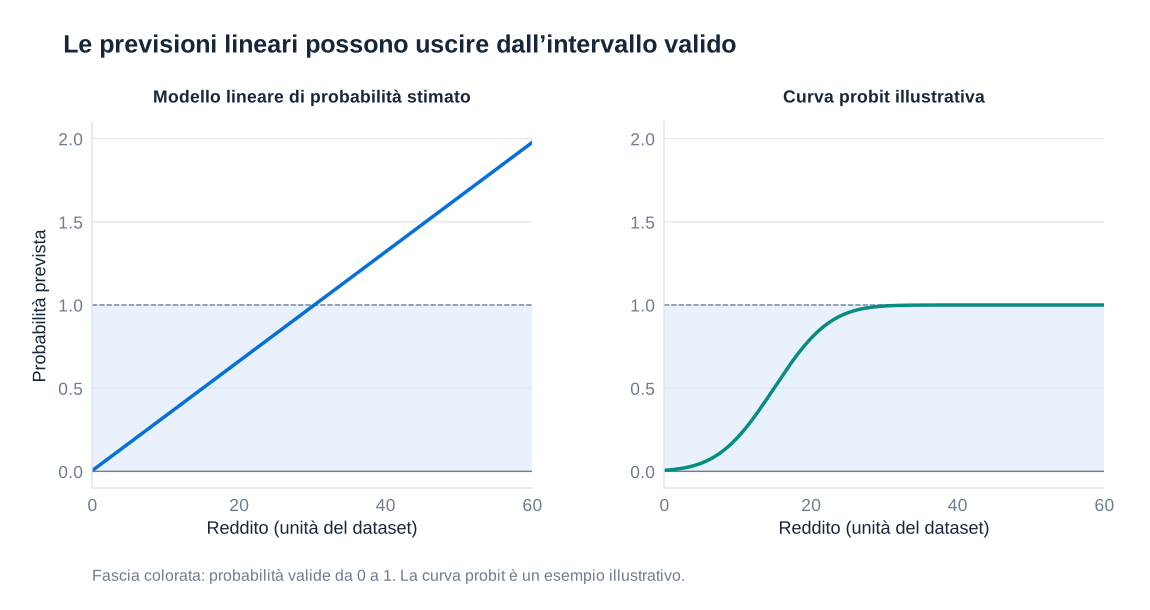
Una retta non rimane necessariamente tra 0 e 1. Il modello scolastico stimato è , che supera 1 quando il reddito registrato supera circa 30.31. Per , prevede circa 1.319, una probabilità impossibile. Queste previsioni rivelano un limite della forma funzionale; limitarsi a troncarle a 1 non modifica il modello stimato e non fornisce un calcolo dell’effetto marginale fondato sul modello.
L’LPM impone anche una pendenza costante della probabilità. Un aumento del reddito ha lo stesso effetto stimato in prossimità di una probabilità di 0.05 e di 0.95, sebbene lo spazio per ulteriori diminuzioni o aumenti sia molto diverso. L’importanza di questa restrizione dipende dall’intervallo delle covariate e dallo scopo dell’analisi. Un’approssimazione lineare può essere utile in un intervallo centrale anche se si comporta male nelle code.
Con una probabilità condizionata specificata correttamente, la varianza dell’errore binario è . Essa varia quindi generalmente con i regressori, rendendo opportuni errori standard robusti all’eteroschedasticità. L’inferenza robusta affronta questo problema di varianza; non corregge probabilità impossibili, variabili omesse o una media condizionata errata. Se le osservazioni sono dipendenti all’interno dei gruppi, anche il calcolo degli errori standard deve tenere conto di tale dipendenza.
I punti percentuali e le variazioni percentuali rispondono a domande diverse. Una probabilità che passa dal 40% al 50% aumenta di 10 punti percentuali e del 25% rispetto al valore iniziale, perché . In un gruppo di dimensione fissa pari a 100, passare da 40 a 50 membri con una caratteristica illustra entrambe le affermazioni. Senza una probabilità di riferimento, un coefficiente dell’LPM non può essere convertito in un’unica variazione percentuale relativa.
Probit, logit e massima verosimiglianza
Probit e logit sostituiscono la retta di probabilità senza vincoli con una funzione di ripartizione regolare. Con un indice , il modello probit utilizza la funzione di ripartizione della normale standard :
La funzione è l’area sotto la densità normale standard a sinistra di . Trasforma ogni indice a valori reali in una probabilità strettamente compresa tra 0 e 1 per valori finiti. Il modello logit utilizza invece la funzione logistica:
Entrambe le curve si appiattiscono vicino ai rispettivi limiti inferiore e superiore. I coefficienti non trasformati descrivono variazioni di un indice, non variazioni della probabilità in punti percentuali. Per un regressore continuo senza interazioni, l’effetto marginale nel probit è , dove è la densità normale standard; l’effetto marginale nel logit è . La loro entità dipende da tutte le covariate attraverso l’indice. Un effetto marginale medio è la media di queste derivate specifiche delle singole osservazioni, mentre un effetto valutato alle covariate medie è una quantità diversa.
Per un regressore binario, calcolare la differenza discreta tra le probabilità previste quando il suo valore viene posto a 1 e a 0, mantenendo fisse le altre covariate. Le interazioni richiedono ancora maggiore attenzione: il segno del coefficiente di un termine di prodotto non coincide necessariamente, da solo, con il segno di ogni effetto di interazione sulla scala delle probabilità. Presentare probabilità stimate o confronti calcolati esplicitamente è spesso più chiaro.
Questi modelli vengono solitamente stimati mediante massima verosimiglianza anziché OLS. Per osservazioni indipendenti con probabilità , la log-verosimiglianza binaria è:
La massimizzazione seleziona i valori dei parametri che attribuiscono agli esiti osservati la massima verosimiglianza all’interno del modello specificato. Le previsioni di probit, logit e LPM possono essere simili in un intervallo centrale, ma non è garantito, soprattutto nelle code. La scelta tra questi modelli deve considerare il confronto di interesse, l’intervallo delle probabilità previste, la specificazione e l’interpretabilità. Un modello di probabilità non lineare fornisce limiti sensati, non un disegno di ricerca causale.
Leggere un risultato completo di regressione
Una tabella dei coefficienti contiene informazioni di natura diversa. Il coefficiente fornisce una relazione condizionata stimata nelle unità del modello. Il suo errore standard misura l’incertezza campionaria secondo lo stimatore della varianza scelto. Una statistica test confronta la stima con un valore ipotizzato, solitamente zero; il p-value descrive la compatibilità con tale ipotesi nulla date le assunzioni del test. Un intervallo di confidenza al 95% sintetizza un intervallo generato da una procedura con una copertura del 95% nel lungo periodo. Né il p-value né l’intervallo misurano la probabilità che una particolare spiegazione causale sia vera.
Il numero di osservazioni indica il campione effettivamente utilizzato. è la quota della variabilità campionaria dell’esito spiegata dalla regressione stimata; corretto penalizza l’aggiunta di regressori e può essere negativo. La radice dell’errore quadratico medio esprime la dispersione dei residui nelle unità della variabile dipendente. Il test F complessivo valuta una restrizione congiunta sui coefficienti di pendenza. Nessuna di queste statistiche sostituisce la valutazione della rilevanza sostanziale degli effetti, un disegno di ricerca valido o un’attenta descrizione del campione.
| Relazione condizionata | Confronto | Interpretazione della variazione stimata |
|---|---|---|
| Un’unità in più di | unità di | |
| Un’unità in più di | Circa il %; confronto stimato esatto sulla scala logaritmica % | |
| 1% in più di | Circa unità dell’esito; esattamente | |
| 1% in più di | Circa il %; è l’elasticità | |
| binaria, modello di probabilità lineare | Un’unità in più di | punti percentuali |
I confronti con esiti in logaritmi si riferiscono direttamente ai valori logaritmici stimati e alle medie geometriche che essi implicano; i confronti tra medie aritmetiche richiedono le condizioni di ritrasformazione discusse nel Capitolo 5. Ogni interpretazione mantiene inoltre fissi gli altri regressori inclusi e rimane associativa, a meno che ipotesi aggiuntive non stabiliscano la causalità.
Esempio svolto: spesa sanitaria annua in livelli
Tre modelli utilizzano 2,970 osservazioni e le stesse variabili esplicative: l’età in anni, il logaritmo naturale del reddito personale e un indicatore di obesità pari a 1 per gli individui obesi e a 0 altrimenti. Il primo esito è la spesa sanitaria totale annua misurata in dollari statunitensi del 2005. I suoi coefficienti combinano quindi tre regole interpretative: un effetto livello–livello dell’età, un effetto livello–log del reddito e una differenza discreta tra gruppi.
| Termine | Coefficiente | Errore standard | Statistica t | p-value | Intervallo di confidenza al 95% |
|---|---|---|---|---|---|
| Età, anni | 202.1078 | 43.41592 | 4.66 | <0.001 | [116.9794, 287.2362] |
| ln(reddito personale) | −260.2222 | 772.2026 | −0.34 | 0.736 | [−1774.329, 1253.885] |
| Indicatore di obesità | 1251.303 | 588.4134 | 2.13 | 0.034 | [97.56308, 2405.043] |
| Intercetta | −4462.544 | 7241.433 | −0.62 | 0.538 | [−18661.29, 9736.197] |
Mantenendo fissi il reddito e la condizione di obesità, un anno aggiuntivo di età è associato a una spesa annua superiore di circa USD 202.11. Un aumento del reddito dell’1% corrisponde a una spesa inferiore di circa USD 2.60, perché il coefficiente moltiplica la variazione del logaritmo del reddito; la variazione stimata esatta è . La stima relativa al reddito è molto imprecisa e il suo intervallo include valori positivi e negativi rilevanti, quindi la stima puntuale negativa non dovrebbe essere presentata come prova acquisita che il reddito riduca la spesa.
A parità di età e reddito, il gruppo degli individui obesi presenta una spesa annua stimata superiore di USD 1,251.30. Il suo intervallo va da circa USD 97.56 a USD 2,405.04. L’intercetta descrive un individuo non obeso con età pari a zero e logaritmo del reddito pari a zero, ossia un reddito uguale a uno nell’unità monetaria registrata. Questa combinazione non è generalmente rappresentativa sul piano sostanziale; un’intercetta negativa non implica una spesa negativa per una persona tipica.
La regressione presenta , corretto e una radice dell’errore quadratico medio pari a 14,058 USD. Il test congiunto restituisce , con . L’evidenza statistica di una qualche associazione può coesistere con una bassa capacità esplicativa e ampi errori di previsione individuali. Le stime non isolano effetti causali dell’invecchiamento, del reddito o dell’obesità senza ulteriori ipotesi sulle condizioni di salute omesse, sulla selezione e su altre determinanti della spesa.
Esempio svolto: spesa sanitaria in logaritmi
Il secondo modello utilizza il logaritmo naturale della spesa annua. Riguarda quindi differenze proporzionali nella spesa e richiede osservazioni con spesa positiva affinché il logaritmo sia definito. Sebbene la numerosità campionaria riportata rimanga 2,970, non si dovrebbe mai presumere che un qualsiasi dataset non contenga spese nulle soltanto perché una specificazione logaritmica è comoda.
| Termine | Coefficiente | Errore standard | Statistica t | p-value | Intervallo di confidenza al 95% |
|---|---|---|---|---|---|
| Età, anni | 0.0419183 | 0.0058171 | 7.21 | <0.001 | [0.0305124, 0.0533243] |
| ln(reddito personale) | −0.1696737 | 0.1034636 | −1.64 | 0.101 | [−0.3725414, 0.0331939] |
| Indicatore di obesità | 0.420106 | 0.0788386 | 5.33 | <0.001 | [0.2655222, 0.5746899] |
| Intercetta | 6.448543 | 0.9702434 | 6.65 | <0.001 | [4.546125, 8.350962] |
Il coefficiente dell’età corrisponde a una spesa superiore di circa il 4.19% per ogni anno aggiuntivo, oppure a una differenza stimata esatta tra medie geometriche pari a %. Il coefficiente del reddito è un’elasticità: un aumento del reddito dell’1% è associato a una spesa inferiore di circa lo 0.170%, mantenendo fisse l’età e la condizione di obesità. Il valore esatto per la variazione finita è circa −0.169%. Il suo intervallo di confidenza include zero e il p-value è 0.101, quindi i dati non dimostrano un’associazione del reddito diversa da zero al livello convenzionale del 5%.
Il coefficiente dell’obesità è abbastanza elevato da rendere fuorviante la comune approssimazione per coefficienti piccoli. La differenza stimata esatta è %, anziché il 42%. Questo confronto riguarda medie geometriche condizionate. Descriverlo come una differenza del 52.21% nella spesa media aritmetica richiederebbe anche un’ipotesi o un calcolo di ritrasformazione appropriati. L’intercetta è il logaritmo stimato della spesa per la combinazione di covariate di riferimento, non la spesa in dollari.
Il modello riporta , corretto, una radice dell’errore quadratico medio pari a 1.8836 unità logaritmiche e , con . Il suo non può essere confrontato direttamente con quello del Modello 1 per decidere quale preveda meglio la spesa in dollari, perché sono cambiate la variabile dipendente e la scala dei residui.
Esempio svolto: la probabilità di ipertensione
Il terzo esito è pari a 1 se un individuo presenta ipertensione e a 0 altrimenti. L’OLS stima quindi un LPM. I coefficienti dell’età e dell’obesità descrivono differenze di probabilità; il coefficiente del reddito combina un esito di probabilità con un regressore in logaritmi.
| Termine | Coefficiente | Errore standard | Statistica t | p-value | Intervallo di confidenza al 95% |
|---|---|---|---|---|---|
| Età, anni | 0.0053784 | 0.001421 | 3.79 | <0.001 | [0.0025922, 0.0081646] |
| ln(reddito personale) | 0.0914678 | 0.0252735 | 3.62 | <0.001 | [0.0419125, 0.1410232] |
| Indicatore di obesità | 0.1987462 | 0.0192582 | 10.32 | <0.001 | [0.1609854, 0.2365071] |
| Intercetta | −0.6557299 | 0.2370055 | −2.77 | 0.006 | [−1.120442, −0.191018] |
Un anno aggiuntivo di età è associato a una probabilità superiore di punti percentuali. Un aumento del reddito dell’1% modifica la probabilità stimata di circa , ossia di 0.0914678 punti percentuali. Utilizzando la variazione logaritmica esatta si ottengono circa 0.0910135 punti percentuali. Moltiplicare per 100 senza tenere conto anche della variazione logaritmica di 0.01 sovrastimerebbe questo confronto di un fattore pari a 100.
Il gruppo degli individui obesi presenta una probabilità stimata superiore di 19.87462 punti percentuali, condizionatamente a età e reddito. Non si tratta di un aumento relativo del 19.87%: il valore relativo richiederebbe una probabilità di riferimento specificata. L’intercetta negativa illustra nuovamente perché una situazione di riferimento esterna all’intervallo utile dei dati non costituisca, da sola, una probabilità plausibile. Le previsioni dovrebbero essere esaminate in corrispondenza dei valori effettivi delle covariate.
I risultati riportano , corretto, una radice dell’errore quadratico medio pari a 0.46012 e , con . Gli errori standard mostrati sono errori standard OLS convenzionali, a differenza di quelli esplicitamente robusti dell’esempio sui distretti scolastici. Dato l’esito binario, un’analisi empirica corretta dovrebbe ricalcolare l’incertezza in modo robusto all’eteroschedasticità o comunque appropriato prima di affidarsi a questi test. Le interpretazioni dei coefficienti restano quelle indicate, ma la loro precisione statistica deve essere valutata utilizzando uno stimatore della varianza adeguato.