
7. Dati panel ed effetti fissi
Un panel segue le stesse unità nel tempo. Il suo contributo distintivo è la possibilità di confrontare una persona, un'impresa, una città o un'altra unità con le proprie osservazioni precedenti. Questo modifica la fonte di informazione utilizzata da una regressione: le differenze persistenti tra unità possono essere separate dai cambiamenti al loro interno. La distinzione è utile ogni volta che una variabile esplicativa è correlata con caratteristiche stabili difficili da misurare. Da sola, tuttavia, non rende causale una relazione osservazionale.
Che cosa registra un panel
Indichiamo con le unità e con i periodi. Un'osservazione rappresenta il risultato dell'unità nel periodo ; è una variabile esplicativa che varia nel tempo. Un panel di città potrebbe registrare la popolazione, lo status di capitale e la presenza di centri di istruzione superiore in date successive. La longitudine è una caratteristica invariante nel tempo, indicata con , perché il suo valore non cambia all'interno della stessa città. Lo status di capitale può cambiare, quindi rientra tra le variabili indicizzate sia da sia da .
Un panel bilanciato osserva ogni unità in ogni periodo e contiene osservazioni. Un panel non bilanciato presenta numeri di osservazioni diversi tra le unità. Questo può dipendere da entrate, uscite, misurazioni mancanti o dalla disponibilità storica dei dati. I dati non bilanciati non sono automaticamente invalidi: i metodi a effetti fissi possono utilizzare le osservazioni disponibili. Tuttavia, la scomparsa selettiva di osservazioni è rilevante. Se un'impresa smette di comunicare dati proprio quando si verifica uno shock negativo non osservato, analizzare soltanto i periodi in cui è osservata può introdurre una distorsione da selezione. Anche l'identificativo dell'unità deve rimanere coerente nel tempo; la modifica di un confine amministrativo può creare un cambiamento apparente che riflette, in parte, un cambiamento dell'oggetto misurato.
Le sezioni trasversali ripetute sono diverse. Osservare ogni anno un nuovo campione di lavoratori consente di confrontare gruppi nel tempo, ma non permette una trasformazione within a livello di lavoratore, a meno che sia possibile collegare le osservazioni degli stessi lavoratori. Le osservazioni ripetute di un panel forniscono informazioni aggiuntive, ma creano anche dipendenza: dieci misurazioni della stessa persona non equivalgono a dieci persone campionate indipendentemente.
Perché il pooled OLS può essere fuorviante
Consideriamo il modello additivo
La componente raccoglie tutte le caratteristiche stabili dell'unità che influenzano il risultato, comprese quelle non osservate. Il disturbo idiosincratico contiene le influenze che variano nel tempo. Una regressione pooled OLS che omette unisce le due componenti in un unico errore. Anche se il disturbo che varia nel tempo è esogeno, una correlazione tra e genera una distorsione da variabile omessa. Per esempio, una città con un porto naturalmente favorevole potrebbe presentare sia una maggiore attività commerciale sia una popolazione più numerosa in ogni periodo. Confrontare città ad alta e bassa attività commerciale mescola l'associazione tra attività e popolazione con il vantaggio persistente del porto.
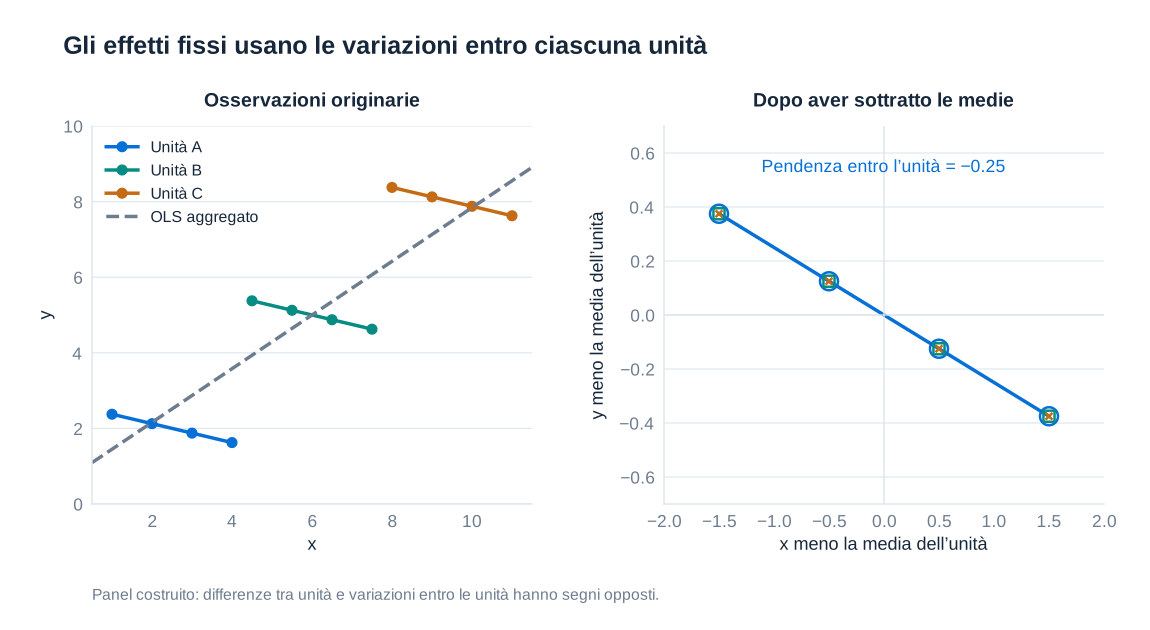
La distinzione fondamentale è tra variazione tra unità, rappresentata dalle differenze nelle medie delle unità, e variazione all'interno delle unità, rappresentata dagli scostamenti dalla media di ciascuna unità. Una relazione pooled positiva può coesistere con una relazione interna alle unità piatta o negativa. Nessuna delle due stime dovrebbe essere interpretata senza precisare il confronto utilizzato. Gli effetti fissi escludono deliberatamente le differenze persistenti di livello come fonte di identificazione di .
La trasformazione within
Per un panel bilanciato, calcoliamo la media temporale di ciascuna unità. Definiamo e definiamo e nello stesso modo. La media di è semplicemente . Sottraendo l'equazione delle medie dall'equazione originale si ottiene
Scompaiono sia l'intercetta comune sia quella specifica dell'unità. L'OLS applicato a queste variabili centrate rispetto alla propria media stima quindi la pendenza senza richiedere che sia incorrelata con . Con una sola variabile esplicativa, lo stimatore within è
Il denominatore evidenzia un requisito fondamentale: la variabile esplicativa deve cambiare all'interno di almeno alcune unità. Una variabile costante all'interno di ogni unità ha valore zero dopo la sottrazione della media e non può avere un coefficiente identificato separatamente. Per questo una regressione con effetti fissi di città non può stimare un effetto principale separato della longitudine. Il suo contributo è assorbito dall'intercetta della città. Anche una quantità ridotta di variazione interna alle unità può produrre stime imprecise, persino quando il dataset completo contiene molte osservazioni.
Per un panel non bilanciato, la media di ciascuna unità viene calcolata sui periodi in cui essa è osservata, utilizzando il proprio numero di osservazioni . Il procedimento algebrico rimane valido per un effetto additivo invariante nel tempo. Per formulare inferenze sulla popolazione di interesse restano necessarie ipotesi appropriate sul processo di osservazione.
Gli effetti fissi come indicatori di unità
La stessa pendenza può essere stimata assegnando a ciascuna unità una propria intercetta. In presenza di un'intercetta comune, si includono indicatori di unità; l'unità omessa fornisce l'intercetta di riferimento. In alternativa, si includono tutti gli indicatori e si omette l'intercetta comune. Includere sia un'intercetta comune sia tutti gli indicatori di unità genera multicollinearità perfetta, perché gli indicatori sommano a uno per ogni osservazione.
La regressione ai minimi quadrati con variabili dummy e la regressione within producono la stessa pendenza stimata quando sono applicate alle stesse osservazioni e agli stessi regressori. Il software deve inoltre tenere correttamente conto degli effetti fissi stimati nel calcolo degli aggiustamenti dei gradi di libertà. Scegliere un'unità di riferimento diversa modifica l'interpretazione dell'intercetta e dei coefficienti degli indicatori, ma non modifica i valori stimati né la pendenza del regressore che varia nel tempo. Le procedure di stima moderne assorbono grandi insiemi di effetti fissi, anziché costruire esplicitamente migliaia di colonne di indicatori.
Differenze prime
Un altro modo per eliminare consiste nel sottrarre l'osservazione precedente della stessa unità:
L'effetto fisso si annulla perché . Una regressione in differenze prime verifica se a un cambiamento della variabile esplicativa si accompagna un cambiamento del risultato. La costruzione delle differenze comporta la perdita dell'osservazione iniziale di ciascuna unità. Se mancano alcune date, righe registrate consecutive non devono essere automaticamente trattate come periodi consecutivi: un cambiamento nell'arco di due anni non è la stessa grandezza di un cambiamento annuale.
Con esattamente due periodi e lo stesso campione, le differenze prime e lo stimatore within producono la stessa pendenza. Con più di due periodi, entrambi eliminano un effetto additivo fisso, ma le loro stime non devono necessariamente coincidere. La loro efficienza relativa dipende dalla struttura seriale del disturbo idiosincratico. Il passaggio alle differenze può anche amplificare l'importanza dell'errore di misurazione quando la variabile vera cambia poco nel tempo. La scelta dovrebbe quindi riflettere il modello economico, la qualità dei dati e il processo degli errori.
Effetti di unità ed effetti di periodo
Un modello a effetti fissi a due vie comprende sia intercette di unità sia intercette di periodo:
Gli effetti di unità assorbono le differenze stabili tra unità: la localizzazione, vantaggi infrastrutturali persistenti o caratteristiche durevoli di un individuo. Gli effetti di periodo assorbono gli shock comuni a tutte le unità in una determinata data, come una recessione nazionale o un cambiamento tecnologico generale. Per le popolazioni urbane, un'ondata epidemica comune potrebbe essere rappresentata da un effetto di periodo soltanto nella misura in cui il suo effetto additivo sia condiviso dalle diverse città. Uno shock che colpisce i porti più intensamente delle città dell'entroterra non viene eliminato completamente da un'unica intercetta temporale comune.
In un panel bilanciato, sottrarre le medie di unità e le medie temporali e aggiungere la media complessiva elimina entrambi gli insiemi di intercette. Con osservazioni non bilanciate, questa semplice formula di doppia sottrazione delle medie in un solo passaggio è generalmente insufficiente; occorre uno stimatore che assorba correttamente entrambi gli effetti. Le variabili che si muovono in modo identico per ogni unità in ciascuna data sono collineari con gli effetti temporali. L'identificazione richiede quindi una variazione che rimanga dopo l'eliminazione di entrambi gli insiemi di effetti.
Esogeneità, dipendenza seriale e inferenza
Una condizione sufficiente standard per lo stimatore statico a effetti fissi è l'esogeneità stretta del disturbo idiosincratico:
Questa condizione ammette la correlazione tra i regressori e l'effetto stabile , ma esclude la correlazione tra un disturbo in un periodo e i regressori di qualsiasi periodo. È più forte dell'esogeneità contemporanea. Se un calo inatteso della popolazione urbana induce il governo a introdurre una politica nel periodo successivo, lo shock corrente è collegato a un regressore futuro. Sottrarre la media della città non elimina questa retroazione. Fattori omessi che variano nel tempo, determinazione simultanea e misurazione endogena restano possibili fonti di distorsione. Le variabili dipendenti ritardate richiedono particolare cautela nei panel brevi, perché la trasformazione within le rende generalmente correlate con il disturbo trasformato.
Le osservazioni ripetute creano anche un problema di inferenza. Dopo l'eliminazione degli effetti fissi, gli shock idiosincratici possono ancora essere persistenti all'interno delle unità. Gli errori standard robusti per cluster consentono eteroschedasticità e correlazione seriale all'interno di un cluster specificato, facendo affidamento su un'adeguata indipendenza tra cluster. Se la politica varia a livello di Stato, costruire i cluster soltanto a livello individuale può sottostimare notevolmente l'incertezza: molti individui condividono lo stesso shock di politica. Il livello dei cluster dovrebbe seguire il meccanismo di assegnazione e i disturbi comuni plausibili, e il numero di cluster indipendenti conta più del semplice numero di righe. Gli errori standard corretti per cluster affrontano il problema dell'incertezza; non correggono un regressore endogeno.
Effetti casuali e fonte della variazione identificante
Anche un modello a effetti casuali separa da , ma utilizza sia l'informazione interna alle unità sia quella tra unità. Nella sua forma convenzionale richiede che l'effetto di unità sia incorrelato con i regressori in tutte le date, condizionatamente ai controlli inclusi. Questa ipotesi è impegnativa quando, per esempio, la qualità non osservata della gestione influenza sia gli investimenti sia la produzione di un'impresa. Se l'ipotesi è credibile, gli effetti casuali possono migliorare l'efficienza e stimare i coefficienti di regressori invarianti nel tempo che gli effetti fissi assorbono.
Gli effetti casuali sono quindi una scelta sostanziale di modellizzazione, non un metodo obsoleto. Gli approcci a effetti casuali correlati possono allentare l'ipotesi convenzionale includendo esplicitamente funzioni della storia dei regressori di un'unità, come le medie temporali. Un confronto tra stime a effetti fissi e a effetti casuali può essere informativo, ma un test automatizzato non può stabilire la credibilità economica di tutte le ipotesi identificanti. Soprattutto, una tabella contenente coefficienti per caratteristiche geografiche invarianti nel tempo non può essere descritta come una regressione standard a effetti fissi di città che stima anche gli effetti principali di tali caratteristiche geografiche.
Sviluppo urbano di lungo periodo: leggere una tabella empirica
Lo studio di Bosker, Buringh e van Zanden sullo sviluppo urbano tra l'800 e il 1800 raccoglie informazioni su 793 città in Europa, Medio Oriente e Nord Africa. Il contesto distingue la geografia stabile dalle istituzioni che cambiano. L'accesso al mare e le reti di trasporto possono influenzare il commercio, mentre lo status politico e religioso può modificare il ruolo amministrativo o economico di una città. La copertura storica e la disponibilità delle variabili fanno sì che i campioni delle singole regressioni non debbano necessariamente contenere ogni città in ogni data.
La seguente tabella di base presenta una specificazione a effetti casuali con ulteriori effetti fissi di ecozona, Paese e secolo. Non è la specificazione a effetti fissi di città sviluppata sopra. La variabile dipendente è il logaritmo naturale della popolazione urbana. Ogni cella riporta un coefficiente seguito, tra parentesi quadre, dal relativo p-value calcolato con cluster a livello di città. Un p-value visualizzato come 0.00 è un valore piccolo arrotondato, non una probabilità di cui si sappia che è esattamente zero. “Non inclusa” identifica una variabile non stimata in quella specificazione, anziché un risultato mancante.
| Caratteristica | Tutte le città | Città musulmane | Città cristiane | Medio Oriente / Nord Africa | Europa | Città musulmane: Medio Oriente / Nord Africa | Città cristiane: Europa |
|---|---|---|---|---|---|---|---|
| Accesso al mare | 0.25*** [0.00] | 0.24 [0.11] | 0.25*** [0.00] | 0.42*** [0.01] | 0.26*** [0.00] | 0.38** [0.04] | 0.25*** [0.00] |
| Accesso a un fiume | 0.09** [0.04] | 0.12 [0.23] | 0.05 [0.31] | 0.21* [0.07] | 0.06 [0.25] | 0.11 [0.42] | 0.05 [0.3] |
| Strada romana | 0.03 [0.59] | −0.09 [0.55] | 0.06 [0.22] | 0.08 [0.71] | 0.03 [0.61] | 0.05 [0.84] | 0.05 [0.28] |
| Nodo di strade romane | 0.09* [0.10] | 0.08 [0.54] | 0.10** [0.04] | 0.12 [0.55] | 0.08 [0.13] | 0.12 [0.57] | 0.10** [0.05] |
| Via carovaniera | 0.08 [0.46] | 0.31* [0.05] | −0.34*** [0.00] | 0.06 [0.66] | Non inclusa | 0.25 [0.15] | Non inclusa |
| Nodo carovaniero | 0.5*** [0.00] | 0.78*** [0.00] | 0.09 [0.61] | 0.55*** [0.00] | Non inclusa | 0.70*** [0.00] | Non inclusa |
| Sede vescovile | 0.18*** [0.00] | 0.22** [0.04] | 0.19*** [0.00] | 0.37*** [0.00] | 0.17*** [0.00] | 0.27* [0.06] | 0.19*** [0.00] |
| Sede arcivescovile | 0.34*** [0.00] | 0.12 [0.45] | 0.41*** [0.00] | 0.35 [0.16] | 0.39*** [0.00] | 0.22 [0.36] | 0.41*** [0.00] |
| Città santa cristiana | 0.26 [0.26] | Non inclusa | 0.47 [0.12] | 0.29 [0.57] | 0.22 [0.54] | Non inclusa | 0.34 [0.34] |
| Città santa musulmana | 0.19 [0.24] | −0.08 [0.79] | Non inclusa | 0.02 [0.93] | Non inclusa | −0.18 [0.62] | Non inclusa |
| Capitale | 0.87*** [0.00] | 0.67*** [0.00] | 0.93*** [0.00] | 0.73*** [0.00] | 0.91*** [0.00] | 0.72*** [0.00] | 0.95*** [0.00] |
| Centro di istruzione superiore | 0.32*** [0.00] | 0.09 [0.83] | 0.30*** [0.00] | 0.11 [0.75] | 0.29*** [0.00] | 0.16 [0.74] | 0.30*** [0.00] |
| Madrasa | 0.25** [0.01] | 0.12 [0.25] | Non inclusa | 0.19 [0.11] | 0.12 [0.48] | 0.16 [0.19] | Non inclusa |
| Saccheggiata | 0.03 [0.56] | 0.02 [0.57] | −0.09 [0.14] | 0.07 [0.103] | −0.16*** [0.01] | 0.03 [0.41] | −0.14** [0.03] |
| Log del potenziale urbano musulmano | 0.08 [0.31] | 0.30** [0.04] | 0.03 [0.72] | 0.24 [0.12] | 0.19** [0.04] | 0.29* [0.10] | 0.07 [0.47] |
| Log del potenziale urbano cristiano | 0.23*** [0.00] | 0.29 [0.12] | 0.25*** [0.00] | −0.02 [0.9] | 0.21*** [0.00] | 0.18 [0.43] | 0.25*** [0.00] |
| R² | 0.46 | 0.52 | 0.43 | 0.60 | 0.40 | 0.56 | 0.41 |
| Osservazioni | 2,596 | 656 | 1,940 | 570 | 2,026 | 499 | 1,869 |
Variabile dipendente: logaritmo naturale della popolazione urbana. Le parentesi quadre contengono p-value basati su errori standard corretti per cluster a livello di città. Gli indicatori di significatività sono riprodotti con la precisione riportata: * 10%, ** 5%, *** 1%. Tutte le specificazioni ammettono effetti casuali di città e includono effetti fissi di ecozona, Paese e secolo. I controlli aggiuntivi riguardano la religione, dove applicabile, le pertinenti distanze logaritmiche da La Mecca, Bisanzio e Roma, il logaritmo dell'altitudine, il logaritmo dell'asperità del territorio circostante e il potenziale di coltivazione. L'indicatore di centro di istruzione superiore e quello di madrasa distinguono le due categorie istituzionali utilizzate nello studio.
I modelli di trasporto differiscono tra sottocampioni: l'accesso al mare presenta un'associazione positiva nella maggior parte delle specificazioni, mentre le reti carovaniere mostrano associazioni particolarmente forti nei campioni di città musulmane. Le misure di potenziale urbano distinguono l'accesso alle reti di città musulmane e cristiane; i loro coefficienti logaritmici sono elasticità condizionate al modello. Lo status di capitale è positivamente associato alla popolazione in tutta la tabella. Anche lo status amministrativo religioso e i centri di istruzione mostrano associazioni positive in diversi campioni. Questi risultati descrivono relazioni condizionate, non una prova automatica di effetti causali delle istituzioni. Una città in crescita può acquisire un'istituzione politica o educativa proprio perché è già in espansione.
L'interpretazione dipende dalla forma funzionale. Un coefficiente dello status di capitale pari a 0.87 corrisponde a un rapporto stimato tra popolazioni di , ossia a circa il 139% in più nella specificazione logaritmica esponenziata, anziché esattamente all'87%. Per una variabile di potenziale urbano in logaritmi, un coefficiente di 0.23 significa invece che una variazione dell'1% del potenziale urbano è associata approssimativamente a una variazione dello 0.23% della popolazione. L'esponenziazione descrive rapporti stimati sulla scala logaritmica; tradurli in medie aritmetiche condizionate della popolazione può richiedere anche un aggiustamento di ritrasformazione quando la distribuzione del disturbo cambia tra le osservazioni.
Interpretare correttamente gli indicatori temporali
Omettendo l'anno 800, il coefficiente di un secolo confronta un periodo con quel periodo di riferimento, condizionatamente agli altri regressori. La tabella seguente è un esempio di interpretazione dei coefficienti. Il campione dichiarato contiene 8,723 osservazioni, quindi non va confuso con la specificazione di base precedente, che ne contiene 2,596. Sono elencati soltanto i secoli riportati; non sono fornite stime per le voci omesse nell'esempio.
| Secolo | Coefficiente logaritmico | Statistica t |
|---|---|---|
| 800 | Periodo di riferimento | Non stimato |
| 900 | 0.299 | 1.89 |
| 1000 | 0.845*** | 5.35 |
| 1100 | 0.963*** | 6.10 |
| 1200 | 1.553*** | 9.83 |
| 1300 | 3.006*** | 19.03 |
| 1400 | 2.224*** | 14.08 |
| 1700 | 4.955*** | 31.37 |
| 1800 | 8.036*** | 50.87 |
L'anno 800 è la categoria omessa. L'esempio non riporta coefficienti per il 1500 o il 1600. Tre asterischi indicano significatività al livello dell'1%.
In un modello con risultato in logaritmi, è un'approssimazione della differenza percentuale valida per coefficienti piccoli. Il confronto esatto ottenuto mediante esponenziazione è . Pertanto 0.299 implica circa il 34.9%, mentre 0.845 implica circa il 132.8%. Per 8.036, l'approssimazione è del tutto inappropriata: il corrispondente rapporto stimato è circa 3,090.2, non una differenza di popolazione dell'803.6%. Il valore eccezionalmente elevato mostra perché occorre verificare la scala e la provenienza di un risultato prima di attribuirgli un'interpretazione storica sostanziale.
Effetti mutevoli della geografia e delle istituzioni
Sebbene l'effetto principale di una caratteristica invariante nel tempo sia assorbito dagli effetti di unità, la sua interazione con il tempo può essere identificata. Supponiamo che registri l'accesso costiero. In un modello con effetti fissi di città e temporali, si include in interazione con ciascun indicatore di periodo, tranne quello dell'anno di riferimento. Un coefficiente misura quindi come la differenza tra città costiere e dell'entroterra sia cambiata rispetto a quell'anno di riferimento, anziché la differenza complessiva in quell'anno.
| Secolo | Coefficiente dell'interazione |
|---|---|
| 800 | Periodo di riferimento |
| 900 | 0.14 |
| 1000 | 0.09 |
| 1100 | 0.02 |
| 1200 | −0.03 |
| 1300 | 0.12 |
| 1400 | 0.02 |
| 1500 | 0.11 |
| 1600 | 0.27 |
| 1700 | 0.38** |
| 1800 | 0.45** |
Sono inclusi effetti fissi di città e di periodo. Due asterischi indicano significatività al livello del 5%. In questo esempio non sono forniti errori standard né statistiche t.
Il coefficiente 0.45 per il 1800 rappresenta un incremento di 0.45 punti logaritmici nel divario tra città costiere e dell'entroterra rispetto all'800. L'esponenziazione fornisce un rapporto di rapporti pari a , ossia un aumento di circa il 56.8% di quel rapporto relativo. Non si tratta automaticamente di una differenza di 45 punti percentuali nei normali tassi di crescita della popolazione. Un'affermazione di questo tipo in punti percentuali richiederebbe ulteriori informazioni sulla situazione di partenza e sui tassi di crescita confrontati.
Una caratteristica che varia nel tempo può essere posta in interazione con tutti gli indicatori di periodo quando si omette il suo effetto principale complessivo separato e la matrice dei regressori ha rango sufficiente. Per lo status di capitale, questa parametrizzazione stima direttamente un coefficiente specifico per periodo. Se invece si include un coefficiente complessivo dello status di capitale insieme alle interazioni per tutti i periodi tranne quello di riferimento, le interazioni diventano scostamenti da quel coefficiente di riferimento. Si tratta di parametrizzazioni alternative delle stesse relazioni stimate, non di teorie economiche in concorrenza.
| Secolo | Coefficiente dello status di capitale |
|---|---|
| 800 | 0.19 |
| 900 | 0.50 |
| 1000 | 0.41 |
| 1100 | 0.40*** |
| 1200 | 0.48*** |
| 1300 | 0.47*** |
| 1400 | 0.45*** |
| 1500 | 0.61*** |
| 1600 | 0.63** |
| 1700 | 0.82** |
| 1800 | 0.64* |
Sono inclusi effetti fissi di città e di periodo. Significatività: * 10%, ** 5%, *** 1%. In questo esempio non sono forniti errori standard né statistiche t.
Per esempio, un coefficiente dello status di capitale specifico per periodo pari a 0.64 corrisponde a una differenza condizionata esponenziata di circa l'89.6%. Che ciò meriti un'interpretazione causale dipende ancora dal motivo per cui lo status di capitale è cambiato e dal controllo dei pertinenti fattori confondenti che variano nel tempo. Le interazioni ampliano la flessibilità del modello, ma non creano variazione esogena.
Valutare un risultato ottenuto con dati panel
Una valutazione utile inizia identificando l'unità, il periodo e il campione effettivamente utilizzato nella stima. Si chiede poi quali variabili cambino all'interno delle unità, quali effetti siano assorbiti e quale variazione residua identifichi il coefficiente. La spiegazione economica deve chiarire perché tale variazione non sia collegata al disturbo idiosincratico. Infine, il calcolo dell'incertezza deve rispettare la dipendenza generata dalle osservazioni ripetute e dagli shock condivisi. I dati panel aiutano a eliminare una specifica classe di variabili omesse, ossia le caratteristiche additive stabili delle unità, ma un disegno causale credibile deve affrontare anche i fattori confondenti che rimangono.