
5. Relazioni non lineari e forme funzionali
Perché una retta può essere troppo restrittiva
Una regressione lineare assegna una pendenza costante a un regressore: in , un aumento di di un’unità modifica il valore stimato dell’esito di , qualunque sia il punto di partenza. Può essere un’utile approssimazione locale, ma non è una descrizione universale del comportamento economico. Un’ora aggiuntiva di studio può migliorare il rendimento più quando uno studente ha studiato poco che dopo una preparazione prolungata. Un aumento degli agenti di polizia può avere associazioni diverse con la criminalità nelle città con organici insufficienti e in quelle con organici consistenti. Anche la relazione tra reddito familiare e rendimento scolastico può appiattirsi all’aumentare del reddito. Ciascun esempio suggerisce di esaminare la forma della relazione anziché imporre automaticamente una pendenza costante.
Un diagramma di dispersione del reddito medio dei distretti e dei punteggi medi nei test può aiutare a evidenziare questo problema. Se la retta stimata non coglie sistematicamente la curvatura della nuvola di punti, i suoi residui possono essere positivi in alcune fasce di reddito e negativi in altre. Una specificazione non lineare può rappresentare questo andamento con maggiore precisione. Si tratta di un’affermazione sulle medie condizionate, non di una garanzia di causalità: il reddito può essere correlato con le risorse familiari, l’istruzione dei genitori, le condizioni del quartiere e altre determinanti dei risultati. Modificare la curva non elimina la distorsione da variabili omesse.
Il termine “non lineare” può riferirsi ad aspetti diversi. Una regressione quadratica è non lineare nel regressore, ma lineare nei suoi coefficienti incogniti. I minimi quadrati ordinari possono quindi stimarla dopo aver costruito il quadrato del regressore. Un modello come rimane un modello di regressione lineare in questo senso statistico. Al contrario, un modello di probabilità con una funzione di ripartizione normale è non lineare nei coefficienti e richiede generalmente un metodo di stima diverso.
Specificazioni quadratiche ed effetti marginali variabili
Una specificazione quadratica estende la retta aggiungendo un termine al quadrato. Indicando con il reddito del distretto e con il punteggio medio nei test, si scrive:
Il coefficiente di non rappresenta più la pendenza in ogni punto. Derivando la media condizionata si ottiene l’effetto marginale, misurato in punti del test per unità di reddito:
Se , la pendenza diminuisce all’aumentare del reddito, producendo una curva concava; se , la pendenza aumenta. La curva cambia direzione in , purché . Un punto di inversione esterno all’intervallo osservato non dovrebbe essere presentato come una scoperta empirica. Una curva concava stimata su un intervallo moderato può finire per implicare punteggi decrescenti per redditi implausibilmente elevati semplicemente perché si sta estrapolando un polinomio oltre i dati.
La derivata descrive una variazione infinitesima. Per una variazione finita , la differenza stimata esatta è . Con un aumento di un’unità, essa è pari a , non alla sola derivata nel punto iniziale. Distinguere le derivate dalle differenze finite è importante quando l’intervallo è ampio o la curvatura è marcata. Lo è anche quando si cambiano le unità: misurare il reddito in migliaia anziché in singole unità monetarie modifica entrambi i coefficienti, anche se le previsioni calcolate correttamente rimangono invariate.
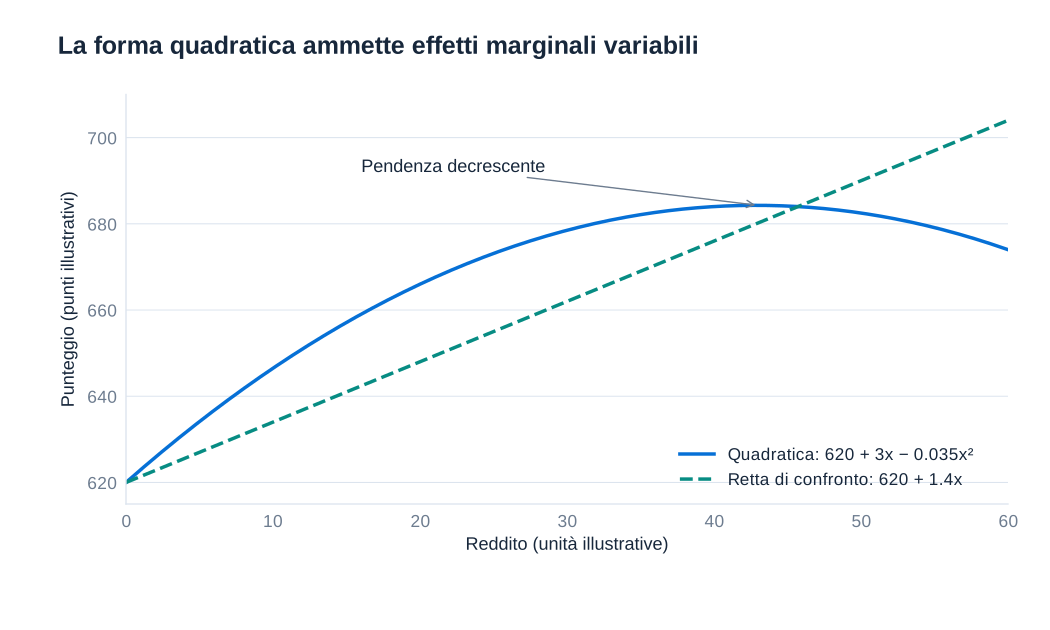
Una specificazione quadratica dovrebbe normalmente includere sia il termine lineare sia quello al quadrato. Eliminare il termine lineare impone una pendenza nulla in , un’ipotesi che richiede una giustificazione economica. Centrare il reddito attorno a un valore significativo può rendere più semplice interpretare l’intercetta e il coefficiente lineare senza modificare i valori stimati, purché il corrispondente modello trasformato includa tutti i termini necessari.
Logaritmi, variazioni proporzionali e asimmetria
Il logaritmo naturale trasforma le differenze moltiplicative in differenze additive. Il confronto che lo caratterizza è . Raddoppiare una variabile positiva aumenta sempre il suo logaritmo di , sia che la variazione originaria vada da 1 a 2 sia che vada da 100 a 200. Questo rende i logaritmi utili quando le differenze proporzionali sono più informative di quelle assolute. Salvo esplicita indicazione di un’altra base, e indicano qui il logaritmo naturale, di base .
Per una piccola variazione proporzionale , . Aumentare il reddito da 100 a 101 significa un incremento dell’1% e modifica il logaritmo del reddito di circa 0.01. Aumentarlo da 1 a 2 significa un incremento del 100% e modifica il logaritmo del reddito di circa 0.693; trattare questa differenza logaritmica come pari a 1 sarebbe un’approssimazione imprecisa. Una scala logaritmica non sostituisce letteralmente ogni differenza con la relativa variazione percentuale. Esprime rapporti in unità logaritmiche, che approssimano bene le variazioni proporzionali soltanto quando queste sono piccole.
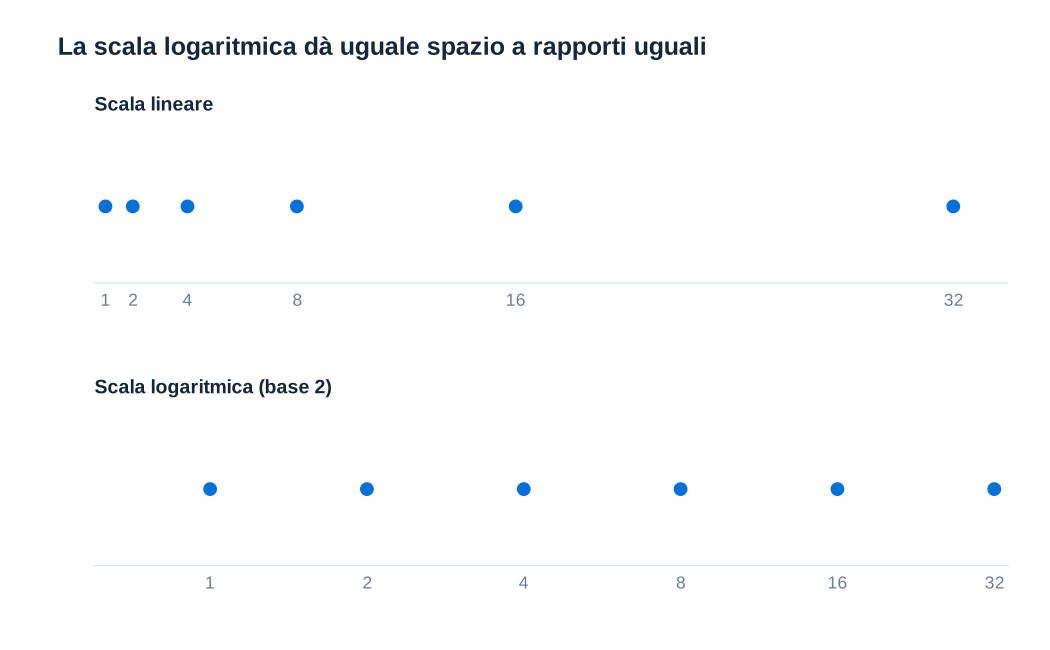
Applicare il logaritmo a una variabile positiva comprime anche i valori elevati. Il reddito presenta spesso una lunga coda destra e un istogramma del logaritmo del reddito può risultare più equilibrato di un istogramma del reddito. Tuttavia, la trasformazione logaritmica non garantisce la normalità e la distribuzione normale dei regressori non è un requisito dell’OLS. La trasformazione dovrebbe riflettere la relazione modellata e l’interpretazione desiderata. Cambia anche il trattamento dei dati: il logaritmo a valori reali non è definito per zero e per osservazioni negative. Aggiungere una costante arbitraria prima di applicare il logaritmo modifica il modello e non deve essere considerato un rimedio innocuo.
Il modello lineare–log: unità dell’esito per variazioni proporzionali dell’input
Quando l’esito rimane espresso in livelli ma al regressore viene applicato il logaritmo, il modello è:
L’effetto marginale nelle unità originarie è , quindi uno stesso aumento assoluto di ha un effetto stimato minore per valori iniziali più elevati. Un aumento dell’1% di modifica il valore stimato dell’esito esattamente di , ossia di circa unità di . Se è il punteggio di un test e , un aumento del reddito dell’1% corrisponde a circa 0.2 punti del test, non a un aumento del 20% dei punteggi. Il coefficiente resta legato alle unità dell’esito.
Per qualsiasi confronto finito da a , la differenza stimata è . Raddoppiare il regressore modifica il valore stimato dell’esito di , non di . Quest’ultima variazione corrisponderebbe a moltiplicare il regressore per . Cambiare l’unità monetaria di un regressore di reddito positivo sposta il suo logaritmo di una costante e modifica l’intercetta, lasciando invece invariate la pendenza e le differenze stimate.
Questa forma è particolarmente utile quando la relazione nei dati originari presenta una curvatura, ma la relazione tra l’esito e il logaritmo dell’input appare più vicina a una retta. Implica una forma specifica: con un coefficiente positivo, l’esito aumenta a un tasso decrescente al crescere dell’input. Senza termini aggiuntivi non può rappresentare ogni possibile andamento, come una relazione effettivamente a forma di U.
Esiti in logaritmi: semielasticità ed elasticità
In un modello log–lineare, , un aumento di un’unità di modifica il logaritmo stimato dell’esito di . L’interpretazione abituale, una variazione di circa il % di , è precisa soltanto per coefficienti piccoli. Il confronto proporzionale esatto implicato dai valori logaritmici stimati è:
per una variazione di unità di . Pertanto, un coefficiente di 0.04 corrisponde a circa il 4.08% per un aumento di un’unità, mentre un coefficiente di 0.42 corrisponde a circa il 52.20%, rendendo l’approssimazione lineare molto meno soddisfacente. Un coefficiente negativo di −0.50 implica un valore inferiore di circa il 39.35%, non del 50%.
In senso rigoroso, applicare l’esponenziale a una media condizionata dei logaritmi degli esiti descrive una media geometrica condizionata, non automaticamente la media aritmetica condizionata dell’esito originario. Da , quest’ultima è . Se il secondo fattore differisce tra le osservazioni confrontate, applicare l’esponenziale alla sola differenza logaritmica stimata non restituisce il rapporto tra le medie aritmetiche. Questa distinzione è importante quando si prevedono spese totali o retribuzioni medie in unità monetarie.
Quando entrambe le variabili sono in logaritmi, , la pendenza è un’elasticità: . Un piccolo aumento dell’1% di corrisponde a una variazione di circa il % di . Per un aumento proporzionale finito , la variazione proporzionale stimata esatta è %. La specificazione log–log assume un’elasticità costante, mentre quella log–lineare assume una semielasticità costante. Sono restrizioni sostanziali, non modi intercambiabili di presentare la stessa regressione.
Scegliere una forma funzionale
La scelta del modello parte dalla domanda economica, dalle unità di misura e dall’intervallo delle osservazioni. I diagrammi di dispersione aiutano a individuare la curvatura e le osservazioni influenti; i grafici dei residui aiutano a rilevare andamenti sistematici lasciati senza spiegazione da un modello stimato. Un regressore asimmetrico può suggerire di considerare una trasformazione logaritmica, ma l’asimmetria, da sola, non dimostra che la media condizionata sia lineare nel suo logaritmo. La stessa distinzione vale per un esito asimmetrico: applicargli il logaritmo cambia il parametro oggetto di stima e il peso attribuito agli errori proporzionali rispetto a quelli assoluti.
Quando possibile, confrontare i modelli candidati utilizzando le stesse osservazioni, verificare se le loro implicazioni siano plausibili nell’intervallo dei dati e considerare la capacità predittiva su osservazioni non utilizzate per la stima. I valori ordinari di di una regressione con esito in livelli e di una con esito in logaritmi non sono misure direttamente confrontabili dell’adattamento alla stessa variabile dipendente. Un valore più elevato dopo aver cambiato la scala dell’esito non dimostra, da solo, che il modello sia migliore.
Anche l’interpretabilità ha valore. Una specificazione parsimoniosa che risponde a una domanda chiara può essere più utile di una curva elaborata dal comportamento instabile. Riportare gli effetti marginali o i confronti stimati effettivamente rilevanti per l’applicazione. In un modello quadratico, indicare il livello di reddito al quale viene valutata la pendenza; in un modello logaritmico, distinguere una variazione di un’unità da una variazione dell’1%. Una forma funzionale convincente richiede comunque una strategia di identificazione credibile prima che ai suoi coefficienti possa essere attribuita un’interpretazione causale.
Interazioni e relazioni eterogenee
Un modello additivo, , rende la pendenza rispetto a un regressore indipendente dall’altro. Questo può essere troppo restrittivo. Le precipitazioni possono avere un’associazione diversa con gli incidenti stradali quando la guida in condizioni di alterazione è più diffusa. Le condizioni economiche locali possono modificare la relazione tra le preferenze di politica economica del partito al governo e la spesa pubblica. Un’interazione consente alla pendenza di variare sistematicamente:
Il coefficiente principale è ora la pendenza di quando , mentre è la pendenza di quando . Il coefficiente dell’interazione misura come cambia una pendenza all’aumentare dell’altro regressore. Non dovrebbe essere interpretato isolatamente come l’intero effetto di una delle due variabili. Mantenere entrambi gli effetti principali evita generalmente di imporre restrizioni arbitrarie di annullamento.
Se è un indicatore binario, confrontare le previsioni per e anziché immaginare una variazione infinitesima dell’appartenenza a un gruppo. In , la differenza tra i gruppi è . La sua incertezza dipende sia dalle varianze dei coefficienti sia dalla loro covarianza:
Di conseguenza, una banda di confidenza per l’effetto combinato non può essere ricostruita a partire dai soli due errori standard riportati. Le interazioni rivelano eterogeneità in una relazione stimata; non stabiliscono, da sole, perché tale eterogeneità si manifesti.
Esempio svolto: istruzione, esperienza e divario retributivo di genere
Si consideri un campione di 1,084 individui della Current Population Survey statunitense. L’esito è il logaritmo naturale della retribuzione oraria; istruzione ed esperienza sono misurate in anni; è pari a 1 per le donne e a 0 per gli uomini. Quattro regressioni annidate mostrano come cambia l’interpretazione quando si aggiungono variabili di controllo e un’interazione. I numeri tra parentesi sono errori standard. “Non incluso” significa che il regressore è assente da quella specificazione, non che il suo coefficiente sia stato stimato pari a zero.
| Regressore | Modello 1 | Modello 2 | Modello 3 | Modello 4 |
|---|---|---|---|---|
| Istruzione, anni | 0.0692 (0.00556) | 0.0712 (0.00538) | 0.0874 (0.00562) | 0.0793 (0.00630) |
| Indicatore donna | Non incluso | −0.272 (0.0302) | −0.269 (0.0284) | −0.594 (0.147) |
| Esperienza, anni | Non incluso | Non incluso | 0.0339 (0.00392) | 0.0347 (0.00391) |
| Esperienza al quadrato | Non incluso | Non incluso | −0.000473 (0.0000847) | −0.000492 (0.0000843) |
| Donna × istruzione | Non incluso | Non incluso | Non incluso | 0.0253 (0.0116) |
| Osservazioni | 1,084 | 1,084 | 1,084 | 1,084 |
Il Modello 1 associa un anno aggiuntivo di istruzione a retribuzioni orarie superiori di circa il 6.92%. L’aggiunta dell’indicatore donna nel Modello 2 modifica tale pendenza e introduce un confronto condizionato tra gruppi. Il Modello 3 aggiunge l’esperienza e il suo quadrato. Il coefficiente positivo dell’esperienza e quello negativo del termine al quadrato descrivono un profilo concavo: l’esperienza aggiuntiva iniziale ha un’associazione stimata maggiore di quella aggiuntiva successiva. Questi cambiamenti illustrano perché un coefficiente sia condizionato al resto della specificazione; non identificano quale regressione abbia risolto tutti i problemi di selezione.
Il Modello 4 consente alla pendenza dell’istruzione di differire per genere. Per gli uomini, la pendenza del logaritmo della retribuzione è 0.0793; per le donne è . Le variazioni proporzionali stimate esatte per un anno aggiuntivo sono rispettivamente di circa l’8.25% e l’11.03%, secondo l’interpretazione degli esiti in logaritmi descritta sopra. La pendenza dell’esperienza è . Il suo punto di inversione stimato è circa 35.26 anni, la cui rilevanza sostanziale dipende dall’intervallo dei valori osservati e dall’adeguatezza della specificazione quadratica.
Interpretare e rappresentare il confronto completo tra generi
Nel Modello 4, il coefficiente dell’indicatore donna non rappresenta il divario retributivo a ogni livello di istruzione. Mantenendo costante l’esperienza, la differenza stimata donne meno uomini nei logaritmi delle retribuzioni al livello di istruzione è:
A zero anni di istruzione, ciò implica un rapporto stimato tra le medie geometriche delle retribuzioni pari a , ossia un valore inferiore di circa il 44.79%, anziché del 59.4%. Anche un’istruzione pari a zero può essere lontana dalla maggior parte delle osservazioni, rendendo il confronto tra intercette poco adatto come sintesi principale. A 12 anni il divario stimato è circa −25.20%; a 16 anni è −17.24%; e a 18 anni è −12.94%. Queste percentuali utilizzano , non l’approssimazione applicata a coefficienti elevati.
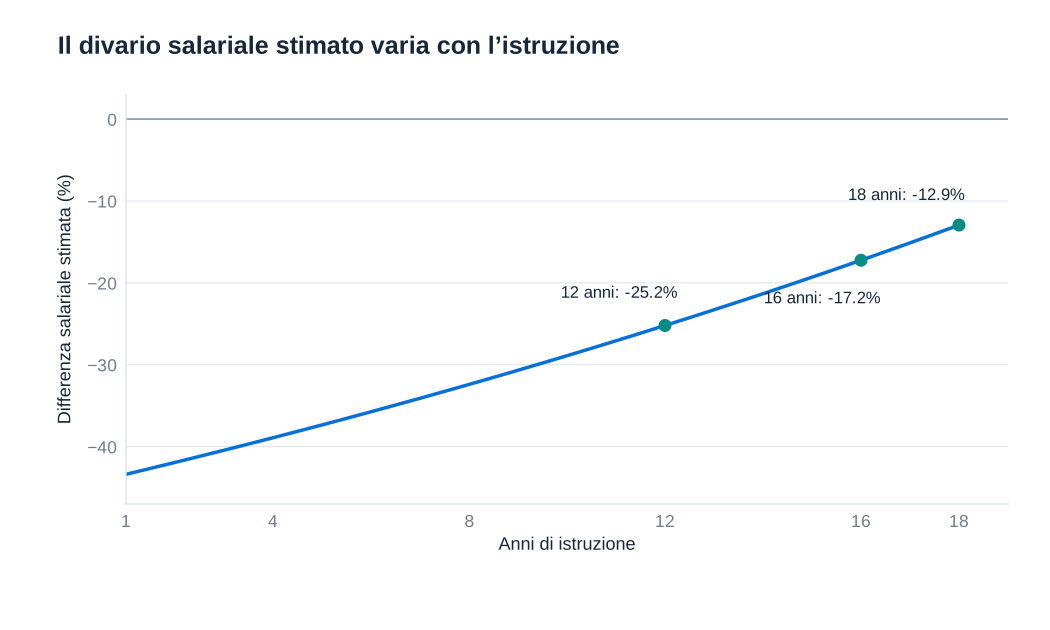
Ogni anno aggiuntivo di istruzione aumenta di 0.0253 la differenza donne meno uomini nei logaritmi delle retribuzioni. Non riduce il divario retributivo percentuale esatto di un valore costante di 2.53 punti percentuali, perché l’esponenziale è non lineare. Ponendo uguale a zero la differenza logaritmica stimata si ottengono circa 23.48 anni di istruzione. Questo punto di intersezione algebrico si trova oltre l’intervallo di 1–18 anni illustrato qui e non dovrebbe essere interpretato come prova che un determinato numero di anni di istruzione elimini la disuguaglianza retributiva.
La regressione documenta associazioni condizionate. Differenze nell’occupazione, nelle ore lavorate, nell’anzianità presso il datore di lavoro, nella selezione nell’occupazione e in altre caratteristiche non osservate possono ancora influenzare le stime. Inoltre, controllare per queste variabili non risolve automaticamente una questione di discriminazione, poiché alcuni controlli possono riflettere a loro volta disparità di opportunità. Una conclusione empirica utile precisa quale misura della retribuzione, quale campione, quali controlli e quale livello di istruzione vengono confrontati, separando tale confronto da qualsiasi affermazione causale più ampia.