
3. Distorsione da variabile omessa ed errore di misurazione
Un coefficiente di regressione è utile soltanto quando la sua interpretazione corrisponde al processo che ha generato i dati. Un campione ampio può rendere una stima molto precisa, lasciandola però sistematicamente errata rispetto alla relazione di interesse. Due minacce particolarmente importanti sono le variabili omesse, che fanno confluire determinanti rilevanti del risultato nell'errore di regressione, e l'errore di misurazione, che separa le variabili registrate in un dataset dalle grandezze economiche che dovrebbero rappresentare. Per comprendere questi problemi occorre distinguere l'incertezza intorno a una stima dalla distorsione rispetto al suo obiettivo.
Consistenza, esogeneità e obiettivo della stima
Consideriamo la relazione nella popolazione . Il parametro descrive la relazione che intendiamo stimare; l'errore raccoglie i determinanti del risultato che restano al di fuori del modello. In una regressione semplice con intercetta, il coefficiente angolare OLS può essere espresso come una covarianza campionaria divisa per una varianza campionaria. In presenza di una legge dei grandi numeri e di una varianza di positiva e finita, il suo limite in probabilità è
L'equazione individua il requisito centrale della consistenza: il regressore deve essere incorrelato con l'errore affinché OLS converga a questo coefficiente strutturale. La condizione più forte giustifica anche la consueta interpretazione condizionata e, con opportune ipotesi sul campionamento, la non distorsione in campioni finiti. La consistenza significa che lo stimatore si avvicina all'obiettivo al crescere del campione; la non distorsione riguarda il valore atteso dello stimatore per una determinata numerosità campionaria. Nessuna delle due proprietà è dimostrata semplicemente ottenendo un errore standard piccolo.
L'affermazione secondo cui OLS è il miglior stimatore lineare non distorto richiede inoltre le ipotesi del teorema di Gauss–Markov, compresa un'appropriata struttura degli errori omoschedastici e incorrelati. Queste ipotesi di efficienza non devono essere confuse con le condizioni di esogeneità necessarie per recuperare il coefficiente di interesse. Una regressione può avere errori eteroschedastici e stimare comunque il coefficiente angolare in modo consistente, mentre un fattore di confondimento omesso può rendere il coefficiente inconsistente anche con errori perfettamente omoschedastici. Se l'obiettivo è soltanto la migliore previsione lineare, OLS può stimare tale proiezione predittiva senza identificare un effetto causale.
Derivazione della distorsione da variabile omessa
Supponiamo che il modello rilevante nella popolazione contenga un'ulteriore variabile :
dove è incorrelato con e . Se viene omessa, l'errore nella regressione ridotta diventa . L'omissione influisce sul coefficiente di quando valgono congiuntamente due condizioni: contribuisce a determinare , per cui , e è correlata con . La sola correlazione con non è sufficiente se la variabile omessa non ha alcun effetto sul risultato nella relazione rilevante nella popolazione.
Scriviamo la proiezione lineare nella popolazione della variabile omessa sul regressore incluso come
Questa proiezione è una descrizione algebrica dell'associazione; non richiede che causi . Sostituendo si ottiene
Il coefficiente angolare della regressione ridotta converge quindi a una combinazione del coefficiente diretto e dell'associazione che opera attraverso la variabile omessa:
Questa affermazione riguarda il limite in probabilità, non una scomposizione esatta di ogni stima effettivamente ottenuta: un singolo campione contiene anche variabilità campionaria. Nella regressione multipla, la corrispondente relazione con la variabile omessa è condizionata alle variabili di controllo già incluse. Ciò che conta è se la variabile omessa rimane associata al regressore dopo aver tenuto conto di tali controlli.
Determinare la direzione della distorsione
Il segno della distorsione è il prodotto di due segni. Per prima cosa occorre chiedersi se un aumento della variabile omessa accresca o riduca il risultato, mantenendo fisso il regressore incluso. Poi bisogna chiedersi se le osservazioni con valori maggiori del regressore incluso tendano ad avere valori maggiori o minori della variabile omessa. Tenere separate queste due domande evita di sostituire un ragionamento intuitivo al calcolo effettivo del segno.
| Effetto della variabile omessa sul risultato | Associazione con il regressore incluso | Distorsione del coefficiente angolare nella regressione ridotta |
|---|---|---|
| Positivo: | Positiva: | Positiva: il coefficiente si sposta verso l'alto |
| Positivo: | Negativa: | Negativa: il coefficiente si sposta verso il basso |
| Negativo: | Positiva: | Negativa: il coefficiente si sposta verso il basso |
| Negativo: | Negativa: | Positiva: il coefficiente si sposta verso l'alto |
“Verso l'alto” significa numericamente maggiore, mentre “verso il basso” significa numericamente minore. Nessuna delle due espressioni è sinonimo di “più vicino a zero”. Una distorsione negativa riduce un coefficiente positivo, ma rende più negativo un coefficiente negativo; un confondimento sufficientemente forte può persino invertirne il segno. Quando si omettono più variabili rilevanti, i loro contributi possono rafforzarsi oppure compensarsi, per cui individuare un possibile fattore di confondimento non permette necessariamente di stabilire il segno della distorsione complessiva.
Risultati nei test, dimensione delle classi e reddito familiare
Un esempio relativo ai distretti scolastici mette in relazione i punteggi medi nei test con il rapporto studenti/insegnanti. Un rapporto maggiore significa più studenti per insegnante, quindi il coefficiente è misurato in punti del test per ogni studente aggiuntivo per insegnante. La regressione non corretta per altre variabili fornisce un'intercetta di circa e un coefficiente angolare di circa . Essa prevede che distretti che differiscono di uno studente per insegnante presentino, in media, una differenza di circa 2.28 punti nei test. Si tratta inizialmente di un'associazione tra distretti, non di un effetto identificato dell'assunzione di insegnanti.
Il reddito familiare offre una spiegazione plausibile per una parte di questa associazione. Supponiamo che un reddito familiare più elevato migliori i risultati attraverso risorse e opportunità, per cui , e che i distretti più ricchi tendano ad avere rapporti studenti/insegnanti inferiori, per cui . Il loro prodotto è negativo. La regressione ridotta attribuisce allora al rapporto più basso una parte del vantaggio nei risultati associato al reddito, rendendo il coefficiente stimato del rapporto più negativo di quello ottenuto con un opportuno controllo per il reddito.
Nel confronto illustrato, il coefficiente del rapporto riportato passa da circa senza il reddito a con il reddito. Un aumento del rapporto di cinque unità è quindi associato a circa punti usando il primo coefficiente riportato e a punti usando quello corretto per il reddito. Si tratta di calcoli basati sui coefficienti di regressione riportati, non di effetti di politiche identificati sperimentalmente. Lo spostamento verso l'alto del coefficiente è coerente con la direzione prevista della distorsione dovuta all'omissione del reddito, ma non dimostra che ogni forma di confondimento sia scomparsa.
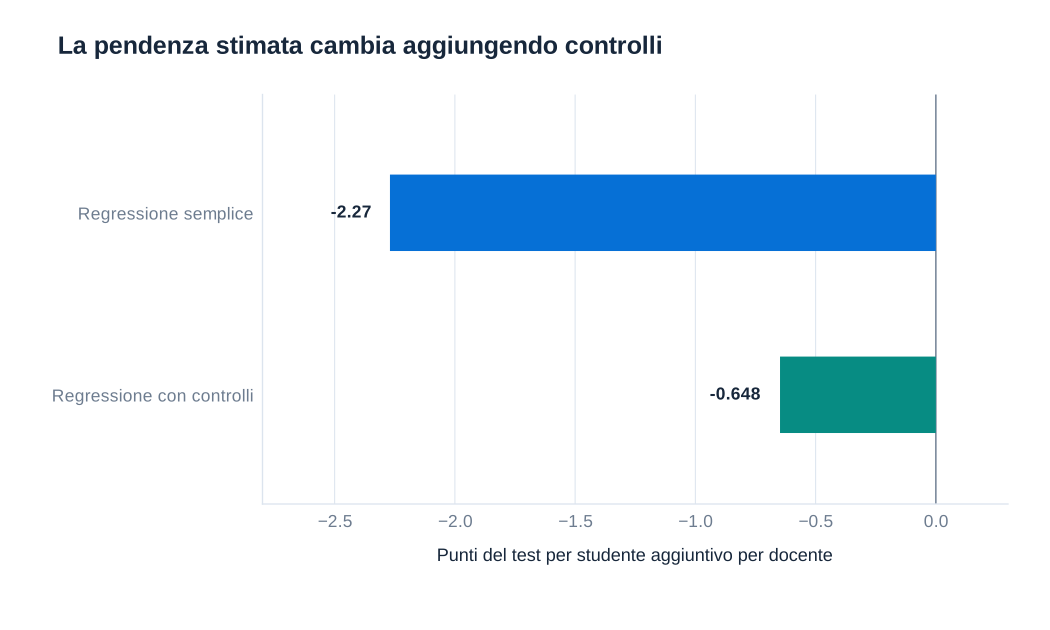
La correzione va intesa come un confronto tra distretti dopo aver tenuto conto della relazione con il reddito specificata nel modello. Altri determinanti, tra cui il contesto familiare, la composizione scolastica e le modalità di allocazione delle risorse, possono rimanere rilevanti. Anche un'intercetta stimata vicina a 699 rappresenta un'estrapolazione a un rapporto pari a zero, al di fuori dell'intervallo utile per il confronto; non va interpretata come il punteggio che un distretto reale otterrebbe in assenza di studenti per insegnante.
Affrontare le variabili omesse senza aggiungere controlli inappropriati
La risposta più diretta consiste nel raccogliere e includere un fattore di confondimento misurato bene. Questo funziona soltanto se il modello ampliato rappresenta adeguatamente la relazione condizionata rilevante e rimane una variazione sufficiente per stimare l'effetto. Controllare per una variabile non elimina automaticamente ogni dimensione della selezione a essa associata. Per esempio, una misura del reddito può lasciare inspiegate differenze rilevanti nelle risorse familiari, e una correzione puramente lineare può essere inadeguata per una relazione fortemente non lineare.
Una variabile proxy può essere utile quando il fattore di confondimento non è direttamente disponibile, ma una proxy imperfetta lascia generalmente un confondimento residuo. Le variabili strumentali possono affrontare alcuni problemi di endogeneità quando uno strumento è rilevante per il regressore endogeno e soddisfa una restrizione di esclusione e una condizione di esogeneità credibili. I metodi per dati panel possono eliminare caratteristiche non osservate che rimangono costanti nel tempo all'interno di un'unità. Ogni approccio sostituisce una difficoltà di identificazione con ipotesi esplicite che devono essere giustificate; nessuno garantisce automaticamente un coefficiente causale.
La scelta delle variabili di controllo dovrebbe seguire la domanda causale. Una variabile causata dal trattamento può essere un mediatore anziché un fattore di confondimento preesistente. Controllare per essa può eliminare una parte dell'effetto totale che il ricercatore intende stimare. Anche condizionare su una conseguenza comune del trattamento e di determinanti non osservati del risultato può generare distorsione. Una specificazione ragionata parte quindi dalla descrizione del processo economico e della sequenza temporale delle variabili, anziché dalla ricerca del maggior numero possibile di controlli.
Errore di misurazione in una variabile esplicativa
Le variabili economiche sono spesso misurate in modo imperfetto. La produzione nazionale si basa su registrazioni incomplete e stime; le indagini sull'uso del tempo dipendono dalla memoria degli intervistati; l'immigrazione irregolare è difficile da quantificare; reddito e felicità autodichiarati possono essere registrati in modo inesatto. L'errore di misurazione può riflettere rumore casuale, comportamenti sistematici nelle dichiarazioni oppure una mancata corrispondenza tra un indicatore registrato e il concetto sottostante.
Indichiamo con il vero regressore e poniamo il valore osservato pari a . Supponiamo che il modello nella popolazione sia . Nel caso additivo classico, assumiamo , , e . Sostituendo nel modello si ottiene
Il segno meno è essenziale. Il regressore osservato contiene l'errore di misurazione con segno positivo, mentre il nuovo disturbo di regressione lo contiene moltiplicato per . Di conseguenza,
Quindi anche un errore non associato al vero regressore crea correlazione tra il regressore osservato e il disturbo composito di regressione. Definire “casuale” l'errore di misurazione non rende esogena la regressione risultante.
Attenuazione, affidabilità ed errore non classico
Le ipotesi classiche implicano e . Il limite in probabilità del coefficiente del regressore osservato è quindi
Il rapporto di affidabilità è compreso tra zero e uno quando la variazione vera è positiva e la varianza dell'errore di misurazione è finita. È uguale a uno quando non vi è errore di misurazione. Man mano che il rumore diventa più importante rispetto alla variazione vera, il coefficiente viene spinto ulteriormente verso zero. Un coefficiente vero positivo viene attenuato verso il basso; un coefficiente vero negativo viene attenuato verso l'alto. L'attenuazione è quindi una riduzione del valore assoluto, non una distorsione numerica invariabilmente verso il basso.
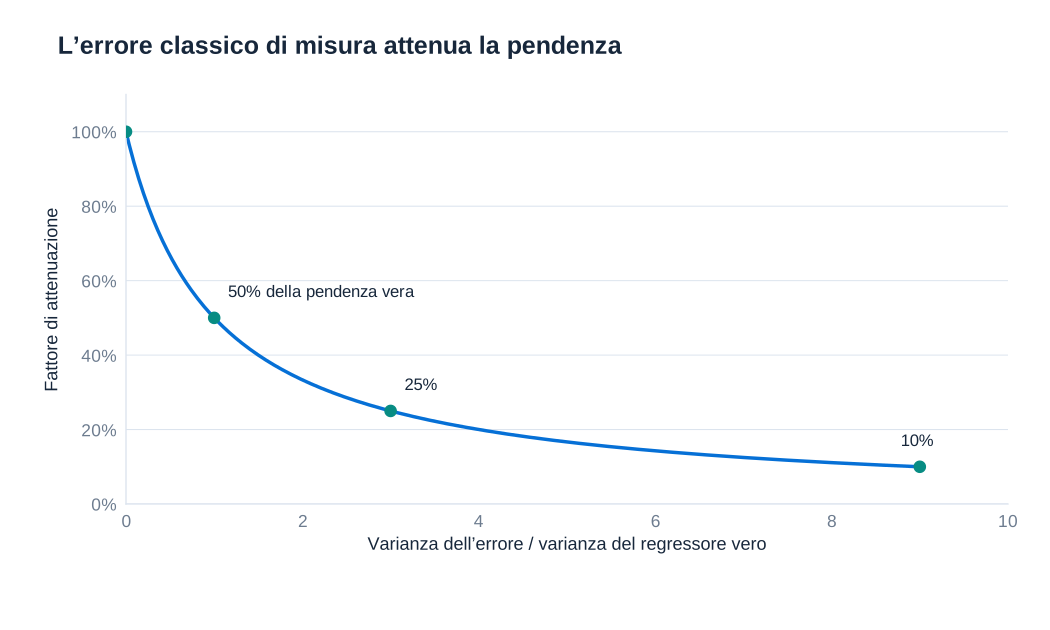
Come esempio ipotetico, se la variazione vera e quella dell'errore di misurazione sono uguali, allora : un coefficiente vero di 4 viene stimato vicino a 2 in un campione sufficientemente ampio, mentre un coefficiente vero di viene stimato vicino a . Un maggior numero di osservazioni concentra lo stimatore intorno a questo obiettivo attenuato; non elimina la distorsione. Una misurazione migliore, informazioni di validazione oppure uno strumento opportunamente valido possono aiutare a identificare il coefficiente desiderato.
L'errore non classico viola una o più delle restrizioni classiche. Gli intervistati con redditi elevati potrebbero sottodichiarare maggiormente il reddito, oppure la qualità delle dichiarazioni potrebbe dipendere dal risultato. La distorsione può allora avere qualunque segno. Persino l'errore classico in una variabile di una regressione multipla non deve necessariamente spostare ogni coefficiente stimato verso zero: le correlazioni tra regressori possono trasmettere il problema ad altri coefficienti. La semplice formula dell'affidabilità dovrebbe quindi essere usata soltanto per il modello e le ipotesi sotto cui è stata derivata.
Errore di misurazione nel risultato e interpretazione pratica
Supponiamo ora che il vero risultato soddisfi , ma che il risultato osservato sia . La relazione stimata diventa
Se l'errore originario è esogeno e l'errore di misurazione del risultato ha media condizionata nulla dato , l'errore composito rimane esogeno. Il coefficiente angolare può quindi rimanere consistente. Se è anche incorrelato con , la sua varianza si aggiunge a quella del disturbo originario, riducendo generalmente la precisione. Sotto queste restrizioni, il rumore classico nel risultato aumenta l'incertezza senza produrre l'attenuazione del regressore descritta sopra.
Questa conclusione è condizionata alle ipotesi, non universale. Se le persone con valori più elevati di sovradichiarano sistematicamente il risultato, allora varia con e il coefficiente può essere distorto. Anche la correlazione tra errore di misurazione e disturbo originario modifica il semplice risultato di additività delle varianze. Un'analisi empirica accurata individua ciò che viene misurato, come viene registrato e perché le ipotesi proposte sull'errore sono plausibili. La distinzione centrale è se il problema modifichi l'obiettivo del coefficiente, la sua precisione oppure entrambi.