
2. I metodi della psicologia
Apertura. Una spiegazione convincente non è necessariamente una spiegazione vera
Due insegnanti osservano che gli studenti che prendono appunti a mano ottengono spesso risultati migliori di quelli che digitano su un computer. Il primo attribuisce la differenza alla maggiore elaborazione cognitiva richiesta dalla scrittura manuale; il secondo ricorda che chi sceglie carta e penna potrebbe essere già più motivato e seguire le lezioni con maggiore attenzione. Un terzo osservatore sospetta che il risultato cambi con la materia, il tipo di esame e l'uso concreto del dispositivo. Tutti e tre formulano ipotesi plausibili. Nessuno, per il solo fatto di proporre una spiegazione ragionevole, ha ancora dimostrato che essa sia corretta.
La psicologia scientifica si distingue dalle interpretazioni spontanee non perché rinunci alle domande quotidiane, ma perché sottopone le spiegazioni a controlli che potrebbero smentirle. Per valutare l'efficacia di una strategia di studio occorre definire che cosa si intenda per «efficacia», selezionare persone in modo appropriato, controllare le condizioni rilevanti e misurare risultati confrontabili. Bisogna inoltre stabilire prima di analizzare i dati che cosa costituirebbe una prova favorevole o contraria all'ipotesi, e interrogarsi sulla possibilità di ottenere risultati simili con studenti e compiti diversi.
La parola metodo indica precisamente questo insieme di decisioni coordinate. Non esiste un unico metodo valido per qualunque domanda: osservare una classe, confrontare gruppi, intervistare persone o assegnarle casualmente a condizioni sperimentali può essere appropriato in circostanze differenti. La qualità della ricerca non dipende dal prestigio dell'etichetta metodologica, ma dalla corrispondenza fra quesito, disegno, misurazione e inferenza. Nel corso del capitolo impareremo a distinguere un dato da un'interpretazione, una correlazione da un effetto causale e un risultato statisticamente insolito da una scoperta importante.
Obiettivi formativi. Al termine del capitolo il lettore saprà formulare domande empiriche e ipotesi controllabili, definire operativamente variabili psicologiche, scegliere tra disegni osservativi e sperimentali, interpretare distribuzioni e correlazioni, ragionare sui fattori confondenti, leggere test statistici e intervalli di confidenza, valutare attendibilità e validità, riconoscere le principali pratiche di ricerca aperta e applicare principi etici alla progettazione degli studi.
2.1 Conoscenza scientifica e costruzione di teorie
Dall'intuizione al problema di ricerca
Nella vita quotidiana impariamo continuamente dalle esperienze. Se una conversazione finisce male dopo una battuta infelice, tendiamo a evitare battute simili; se un metodo di ripasso coincide con un buon voto, siamo portati a riutilizzarlo. Queste inferenze sono spesso pratiche, ma possono essere sistematicamente fallibili. Ricordiamo con più facilità gli episodi coerenti con le nostre convinzioni, trascuriamo le occasioni in cui un evento non si è verificato e attribuiamo alle nostre azioni conseguenze che sarebbero probabilmente accadute comunque. È il motivo per cui un'esperienza personale, anche intensa e sincera, non costituisce da sola una prova generale.
La conoscenza scientifica comincia con un problema formulato in termini interrogabili. Chiedere «Perché gli esseri umani sono irrazionali?» è troppo ampio: richiederebbe prima di tutto una definizione di razionalità e l'individuazione delle decisioni da osservare. È più utile domandare se, a parità di informazioni, presentare un esito come guadagno anziché come perdita modifichi la scelta fra un'opzione certa e una rischiosa. Questa formulazione individua un'esposizione modificabile — il modo di presentare la scelta — e una risposta osservabile — la preferenza espressa. Consente dunque di costruire uno studio che avrebbe potuto dare un risultato diverso da quello atteso.
Una teoria scientifica è un sistema organizzato di concetti e proposizioni che collega fenomeni e produce spiegazioni e previsioni. In linguaggio comune si sente dire che qualcosa «è solo una teoria», come se una teoria fosse necessariamente una congettura debole. In scienza, il termine non indica il grado di certezza: una teoria può ricevere un forte sostegno empirico oppure rimanere preliminare. La sua qualità dipende da coerenza logica, precisione, capacità esplicativa, confronto con alternative e compatibilità con evidenze raccolte mediante metodi affidabili. Una teoria troppo elastica, capace di adattarsi a ogni risultato, rischia di non permettere alcuna verifica incisiva.
Dalla teoria si possono derivare ipotesi, ossia affermazioni specifiche su relazioni o differenze fra variabili. L'ipotesi «un ripasso distribuito in più giornate migliora il ricordo a distanza di una settimana rispetto a un ripasso concentrato di pari durata» è più controllabile della frase «studiare bene rende intelligenti». Specifica la manipolazione, il confronto e un risultato misurabile nel tempo. Un'ipotesi non ha necessariamente la forma «A causa B»: talvolta prevede semplicemente che due grandezze varieranno insieme; talvolta descrive la distribuzione di un fenomeno ancora poco conosciuto.
Deduzione, induzione e revisione delle spiegazioni
Nel ragionamento deduttivo si procede da premesse generali a conseguenze specifiche: se un modello prevede che la difficoltà del recupero faciliti la stabilizzazione dei ricordi, ci si aspetta una determinata differenza di prestazione in condizioni definite. La deduzione è valida quando la conclusione segue logicamente dalle premesse, ma una deduzione impeccabile non garantisce che le premesse siano vere. Il ragionamento induttivo percorre il tragitto opposto: osserviamo risultati particolari e formuliamo regolarità più generali. La sua difficoltà è che un numero finito di osservazioni non esclude tutti i casi futuri o le popolazioni non ancora studiate.
Nella pratica, la ricerca combina i due movimenti. Le osservazioni suggeriscono una spiegazione; la spiegazione genera ipotesi; gli studi sottopongono le ipotesi a verifica; i risultati richiedono chiarimenti, revisioni o nuove misure. Talvolta uno studio fornisce dati precisi ma poco informativi per la teoria: conoscere che un compito richiede in media trecento millisecondi non indica, di per sé, quali processi lo producano. Una misura diventa teoricamente rilevante quando viene inserita in un confronto che separa previsioni concorrenti.
Un principio essenziale è la falsificabilità, ossia la possibilità di specificare quali osservazioni entrerebbero in conflitto con una proposta. Non significa che una sola osservazione inattesa debba far scartare immediatamente una teoria: uno strumento può essere difettoso, un campione anomalo, una procedura diversa da quella prevista. Significa però che non si deve proteggere una spiegazione riformulandola ogni volta senza rendere pubblici i nuovi criteri. La ricerca è particolarmente convincente quando mette a confronto ipotesi alternative che prevedono esiti distinguibili.
Esplorazione e conferma non sono la stessa attività
La ricerca esplorativa serve a scoprire strutture o relazioni non previste: per esempio, si possono analizzare numerose risposte a un questionario per osservare se certe domande tendano a raggrupparsi. La ricerca confermativa valuta invece ipotesi fissate prima di osservare i risultati rilevanti. Entrambe sono legittime. L'errore nasce quando una relazione scoperta per caso fra decine di possibilità viene raccontata come se fosse stata prevista dall'inizio: la probabilità di trovare qualche associazione insolita cresce con il numero di confronti effettuati.
Pensiamo a un ricercatore che misuri qualità del sonno, attività fisica, ore di studio, alimentazione, uso del telefono e venti indici di benessere. Se prova un'enorme quantità di combinazioni e pubblica solo quelle con valori statistici favorevoli, il lettore vede una selezione parziale dei risultati. Una relazione individuata così può essere interessante, ma richiede cautela e spesso una verifica su nuovi dati. Dichiarare che un'analisi è esplorativa non la rende meno utile; permette semplicemente di assegnarle il peso probatorio corretto.
2.2 Ipotesi, variabili e definizioni operative
Costrutti psicologici e indicatori osservabili
Molti oggetti della psicologia non sono grandezze immediatamente leggibili su un apparecchio. Non possediamo un termometro universale per misurare la fiducia, la memoria episodica o il senso di appartenenza. Li trattiamo come costrutti, concetti teorici che aiutano a organizzare una famiglia di manifestazioni osservabili. Una persona può esprimere alta fiducia in un questionario, affidare un compito importante a un collaboratore o dimostrare disponibilità a esporsi a un rischio interpersonale. Questi indizi non coincidono necessariamente: possono riflettere aspetti diversi del medesimo costrutto, oppure processi differenti.
La definizione operativa specifica le procedure mediante le quali un concetto viene rappresentato nello studio. Se intendiamo indagare la memoria a breve termine, potremmo chiedere di ricordare una sequenza di cifre immediatamente dopo la presentazione; il numero di cifre riprodotte correttamente costituisce una variabile osservata. Il compito non «è» la memoria nella sua interezza: ne fornisce un indicatore, sensibile anche a familiarità con i numeri, strategie di raggruppamento, attenzione e modalità di presentazione. La qualità dell'operazionalizzazione dipende quindi non solo dalla precisione della misura, ma dalla sua relazione con la teoria.
Una variabile è una caratteristica che può assumere valori differenti tra persone, situazioni o momenti. Alcune sono quantitative, come il tempo di reazione espresso in millisecondi; altre categoriali, come il tipo di istruzione ricevuta; altre ancora ordinali, come risposte da «per niente» a «moltissimo», che possono avere un ordine naturale senza garantire intervalli psicologicamente uguali. Nei disegni sperimentali si distingue la variabile indipendente, il fattore manipolato dal ricercatore, dalla variabile dipendente, l'esito registrato. La distinzione descrive il ruolo nello specifico studio e non una proprietà immutabile: l'attenzione può essere esito in un esperimento e variabile manipolata in un altro.
Se esaminiamo la relazione tra durata del sonno e prestazione, le ore dormite possono essere misurate, senza intervenire sui partecipanti: in questo caso il fatto di chiamarle «indipendenti» non le rende causalmente indipendenti. La scelta delle parole non sostituisce il disegno di ricerca. Analogamente, se si confronta una modalità di insegnamento con un'altra, la variabile indipendente non è necessariamente «l'istruzione» nel suo complesso, ma la specifica differenza creata tra condizioni: per esempio presenza o assenza di domande di recupero durante la lezione.
Livelli di misura e conseguenze per i calcoli
Nelle misure nominali i valori distinguono categorie senza un ordine quantitativo, come i codici delle condizioni A e B. Nelle misure ordinali possiamo dire che una risposta è più alta di un'altra, ma non assumere automaticamente che la distanza tra 1 e 2 equivalga alla distanza tra 4 e 5. Una scala a intervalli consente di interpretare differenze numeriche costanti pur senza possedere uno zero assoluto; una scala a rapporti ha anche uno zero con significato quantitativo, come una durata non negativa in secondi. Questa classificazione orienta la scelta delle rappresentazioni e dei modelli, ma non è una legge meccanica: molte tecniche statistiche moderne impiegano assunzioni che devono essere valutate in relazione al processo generatore dei dati.
Un errore frequente consiste nel sommare numeri che rappresentano semplicemente etichette: se assegniamo il codice 1 al gruppo che usa carta e il codice 2 al gruppo che usa computer, la media di tali numeri non quantifica il «grado di computer». Diverso è calcolare il punteggio complessivo di un questionario validato, costruito come combinazione di molti item. Anche in quest'ultimo caso l'interpretazione richiede evidenze sulla struttura del questionario, sulle differenze fra gruppi e sull'attendibilità nel contesto d'uso.
Variabili manifeste, latenti, mediatrici e moderatrici
Una variabile manifesta è registrata direttamente, per esempio il numero di risposte corrette; una variabile latente è inferita attraverso un modello da più indicatori. La latenza non implica mistero metafisico: significa che il valore di interesse non coincide con una singola osservazione. I modelli di fattori comuni e altre tecniche psicometriche possono stimare dimensioni non osservate, ma lo fanno sotto assunzioni che non devono essere confuse con prove definitive dell'esistenza di entità separate nel cervello.
Una variabile mediatrice riguarda un possibile percorso attraverso cui un fattore influenza un esito. Se una strategia di studio migliora la prestazione perché induce più tentativi di recupero dalla memoria, il numero di recuperi riusciti potrebbe essere un mediatore. Un moderatore specifica invece quando o per chi la relazione cambia: lo stesso metodo potrebbe avere effetti differenti per materiale semplice e complesso. Identificare statisticamente una mediazione con dati osservativi non prova automaticamente il meccanismo causale; servono assunzioni aggiuntive e, quando possibile, disegni più informativi.
Tabella 2.1. Dalla domanda psicologica alla misura
Domanda | Costrutto | Indicatore possibile | Limite da dichiarare |
|---|---|---|---|
L'attenzione cala durante lo studio? | Attenzione sostenuta | Errori e tempi in un compito ripetitivo | Influiscono fatica, motivazione e familiarità |
Le persone si fidano del partner? | Fiducia interpersonale | Scelte in compiti cooperativi e autovalutazione | Una scelta economica non esaurisce la fiducia |
Il sonno favorisce il ricordo? | Consolidamento mnestico | Ricordo dopo un intervallo controllato | Tempo trascorso e opportunità di interferenza variano |
Una lezione induce stress? | Risposta soggettiva e fisiologica allo stress | Scala validata e indici fisiologici | Indici diversi riflettono componenti differenti |
La tabella propone indicatori a fini didattici: nessun indicatore è automaticamente valido in ogni popolazione.
2.3 Osservare e misurare: procedure, strumenti e distorsioni
L'osservazione sistematica non coincide con guardare
Osservare è una competenza quotidiana; l'osservazione scientifica richiede però criteri condivisi per scegliere, registrare e interpretare gli eventi. Se vogliamo studiare le interruzioni in classe, non basta affermare che un gruppo «sembra disattento». Occorre definire cosa conti come interruzione: parlare senza essere interpellati, lasciare il posto, guardare un dispositivo per più di un intervallo stabilito o interrompere un compagno? A seconda della definizione, la frequenza misurata può cambiare notevolmente. Un protocollo efficace rende ripetibile la classificazione e segnala i casi ambigui.
Nell'osservazione naturalistica il comportamento viene registrato in un ambiente relativamente ordinario, con interferenze ridotte. Il vantaggio è la maggiore vicinanza alle situazioni reali; il limite è la difficoltà di separare le molte cause che agiscono contemporaneamente. In un laboratorio possiamo controllare rumore, istruzioni e tempi, ma potremmo introdurre una situazione poco rappresentativa delle abitudini quotidiane. Questa tensione non ha una soluzione universale: il contesto desiderabile dipende dalla domanda scientifica, dalla possibilità di misurare e dai vincoli etici.
L'osservazione può essere partecipante, quando chi ricerca prende parte al contesto, oppure non partecipante; può essere esplicita o, in condizioni regolate e giustificate, non immediatamente evidente alle persone osservate. La classificazione degli eventi può avvenire per frequenza, durata, intervalli temporali oppure campionamento di episodi. Registrare ogni volta in cui una persona parla fornisce informazioni diverse dal misurare la durata complessiva degli interventi. Nessuna di queste misure è superiore in astratto: bisogna sapere quale proprietà interessa.
Interviste, autovalutazioni e campionamento dell'esperienza
Le interviste strutturate usano domande e criteri comparabili; quelle semistrutturate consentono approfondimenti e domande successive; le interviste aperte privilegiano l'esplorazione dell'esperienza. Le risposte offrono accesso a interpretazioni e resoconti che non emergerebbero dalla sola osservazione. Tuttavia la memoria è ricostruttiva, la desiderabilità sociale può orientare ciò che viene dichiarato e le parole dell'intervistatore possono suggerire involontariamente risposte. Una buona intervista non elimina la soggettività: rende più trasparenti la procedura e il processo interpretativo.
I questionari permettono di raccogliere molte risposte con costi relativamente contenuti, ma la facilità di somministrazione non garantisce una buona misura. Si devono valutare la comprensibilità degli item, la loro pertinenza culturale, il riferimento temporale, le opzioni di risposta e l'eventuale tendenza a rispondere sempre nello stesso modo. L'affermazione «spesso mi sento stanco» può essere interpretata in modi diversi da un turno di lavoro notturno, da uno studente vicino all'esame o da una persona che vive un problema medico. Per confrontare gruppi serve attenzione alla comparabilità del significato delle domande.
Nei diari e nell'experience sampling, o campionamento dell'esperienza, si raccolgono risposte ripetute durante la vita quotidiana, talvolta tramite notifiche a orari programmati o casuali. La procedura può ridurre alcuni errori di ricostruzione retrospettiva e mostrare variazioni entro la stessa persona. Può però modificare il comportamento perché ricorda continuamente ai partecipanti il fenomeno studiato, e non tutti rispondono a ogni rilevazione. La mancanza di risposte può essere informativa: proprio durante giornate più stressanti, per esempio, una persona potrebbe saltare più rilevazioni.
Effetto delle aspettative, dell'osservatore e della situazione
Le caratteristiche della domanda sperimentale (demand characteristics) sono indizi che inducono i partecipanti a intuire ciò che ritengono desiderato dal ricercatore. Una persona che pensa che lo studio valuti la propria generosità potrebbe offrire più aiuto di quanto farebbe normalmente. Anche chi osserva può produrre un bias dell'osservatore, classificando con maggiore facilità i comportamenti coerenti con le proprie ipotesi. Questi effetti non sono inevitabili né sempre grandi, ma vanno considerati già in fase di progettazione.
Procedure utili comprendono istruzioni standardizzate, sistemi di codifica preparati in anticipo, valutatori che non conoscano la condizione dei partecipanti e controlli dell'accordo tra osservatori. Il cieco indica che una o più persone coinvolte non conoscono una certa informazione potenzialmente influente: per esempio il valutatore di un compito scritto può non sapere quale metodo didattico abbia ricevuto lo studente. Nel doppio cieco, usato soprattutto in studi clinici, né chi partecipa né determinate persone che somministrano o valutano conoscono l'assegnazione. Le esatte modalità dipendono dallo studio e non sempre è possibile impedire a tutti di conoscere la condizione.
L'attendibilità inter-valutatore descrive il grado di concordanza tra osservatori indipendenti. Una percentuale di accordo grezza può essere ingannevole: se un comportamento è rarissimo, due osservatori possono concordare quasi sempre limitandosi a segnare «assenza». Indici come il coefficiente kappa cercano di tener conto dell'accordo atteso per caso in condizioni definite. L'importante non è utilizzare il nome di un indice come garanzia, ma documentare in quali condizioni le osservazioni coincidano e dove emergano divergenze.
Ricerca qualitativa e integrazione dei metodi
Non tutte le domande della psicologia richiedono di ridurre subito l'esperienza a un numero. Interviste approfondite, analisi tematica e osservazioni etnografiche possono chiarire il modo in cui persone e comunità attribuiscono significato a eventi complessi. La qualità della ricerca qualitativa dipende da trasparenza del campionamento, descrizione del contesto, tracciabilità delle interpretazioni e considerazione attiva delle letture alternative. Non è corretto giudicarla esclusivamente con gli stessi indicatori di un esperimento randomizzato; non è corretto neppure esentarla da ogni verifica.
Nei metodi misti, risultati numerici e materiali qualitativi vengono integrati con un progetto esplicito. Per esempio, una sperimentazione può mostrare che un intervento di studio produce un miglioramento medio modesto; interviste successive possono aiutare a capire perché alcune persone lo trovino difficile da applicare. L'intervista non dimostra da sola la causa del miglioramento, così come una media statistica non racconta automaticamente come sia vissuta un'esperienza. Il valore deriva da domande complementari, non dalla semplice accumulazione di strumenti.
2.4 Popolazioni, campioni e disegni temporali
Chi abbiamo osservato e di chi vogliamo parlare?
La popolazione di riferimento è l'insieme di unità sul quale vorremmo trarre conclusioni. Può coincidere con tutti gli studenti iscritti a un corso in un anno, con gli adulti residenti in un territorio o con persone che presentano caratteristiche definite. Il campione è il sottoinsieme da cui raccogliamo effettivamente i dati. Ogni risultato va interpretato anche alla luce della distanza tra questi due insiemi. Uno studio accurato su cinquanta volontari non autorizza automaticamente affermazioni su tutta la popolazione mondiale.
Il campionamento probabilistico prevede una procedura in cui le probabilità di inclusione delle unità sono note o stimabili secondo il disegno. Nel campionamento casuale semplice tutte le unità della lista hanno uguale probabilità di selezione; nel campionamento stratificato si suddivide prima la popolazione in gruppi rilevanti e si seleziona all'interno degli strati; in quello a grappoli si selezionano gruppi di unità, come scuole o classi. Ogni disegno modifica precisione, costi e necessità di pesi statistici. Se il campione nasce invece da chi è facilmente raggiungibile o sceglie spontaneamente di partecipare, parliamo spesso di campione di convenienza, utile per molte fasi della ricerca ma vulnerabile a distorsioni di selezione.
Anche dopo una selezione ben progettata può intervenire la non risposta. Se chi è particolarmente impegnato risponde meno ai questionari sullo stress lavorativo, la stima media può risultare distorta. Una grande dimensione campionaria non elimina automaticamente questa difficoltà: diecimila risposte provenienti da un gruppo sistematicamente diverso dalla popolazione possono essere meno rappresentative di un campione più piccolo e meglio selezionato. È necessario distinguere l'errore di campionamento, legato alla variabilità dovuta alla selezione, dal bias di selezione, che produce una deviazione sistematica.
Una domanda sulla generalizzazione richiede poi di considerare età, contesto storico, lingua, risorse economiche e ambiente culturale. Gran parte della ricerca classica è stata svolta con campioni molto circoscritti, spesso studenti universitari di paesi industrializzati. Questo non rende automaticamente falsi i risultati: impone di verificare se i meccanismi osservati siano stabili o dipendano da contesti specifici. La diversità dei campioni è un problema scientifico oltre che di equità nella partecipazione alla ricerca.
Studi trasversali, longitudinali e ripetuti
Uno studio trasversale osserva persone o gruppi in un determinato momento. Può confrontare, per esempio, le prestazioni di studenti di diversa età, ma non separa automaticamente l'effetto dell'età da quello della generazione o da differenze nel contesto formativo. Uno studio longitudinale segue le stesse persone in più momenti: consente di osservare traiettorie di cambiamento e ordinamento temporale, ma richiede risorse, presenta perdite al follow-up e non equivale da solo a un esperimento. I partecipanti che interrompono la ricerca potrebbero differire in modo rilevante da quelli che rimangono.
Nei disegni a misure ripetute ogni partecipante è osservato più volte o in più condizioni. Ciò riduce alcune differenze individuali e può rendere più precise le comparazioni; introduce però effetti di pratica, stanchezza e ordine. Il controbilanciamento varia l'ordine delle condizioni tra partecipanti per ridurre i confondimenti con la sequenza. Se tutti completano prima la prova facile e poi quella difficile, un peggioramento può dipendere dalla difficoltà oppure dall'affaticamento; se gli ordini sono distribuiti, il problema diventa più gestibile.
Negli studi di coorte si segue un gruppo accomunato da un'esperienza o da una finestra temporale; negli studi caso-controllo si confrontano persone con e senza un esito per cercare differenze nelle esposizioni precedenti. Questi disegni sono utili soprattutto quando randomizzare sarebbe impraticabile o eticamente inaccettabile, ma richiedono speciale attenzione a selezione, ricordi retrospettivi e variabili confondenti. La scelta temporale non è un dettaglio amministrativo: determina quali inferenze possiamo sostenere.
La dimensione del campione non è una gara a chi raccoglie più dati
Prima di raccogliere dati bisogna giustificare quante osservazioni siano necessarie in rapporto allo scopo. Una analisi di potenza valuta, sotto assunzioni esplicite, la probabilità che una procedura di test rilevi un effetto di una certa dimensione. La potenza aumenta spesso con il numero di osservazioni e con la precisione della misura, ma dipende anche dal disegno, dalla variabilità e dalla soglia decisionale. Se l'effetto minimo importante per una decisione è piccolo, occorre di regola maggiore informazione per distinguerlo dal rumore.
Non esiste un numero magico di partecipanti valido per ogni ricerca. Una valutazione può basarsi su una precisione richiesta per l'intervallo di confidenza, su una potenza prefissata, sul censimento della popolazione accessibile o su limiti documentati di fattibilità. È scorretto giustificare a posteriori ogni campione solo perché il risultato ottenuto appare statisticamente significativo. È invece utile descrivere prima il ragionamento sulla dimensione, indicare i parametri assunti e discutere quanto le conclusioni dipendano dalla loro plausibilità.
2.5 Studi correlazionali: descrivere relazioni senza inventare cause
Che cosa ci dice una correlazione?
Molte domande psicologiche riguardano fenomeni che non possiamo o non vogliamo manipolare: la relazione tra qualità del sonno e sintomi ansiosi, tra sostegno sociale e benessere, tra ore di studio e risultati degli esami. In uno studio correlazionale si misura il valore di due o più variabili e si valuta come varino insieme. Se gli individui con più ore di studio tendono ad avere punteggi più alti, descriviamo un'associazione positiva. Se maggiore affaticamento coincide con minore accuratezza, parliamo di associazione negativa. Un'assenza di correlazione lineare non prova che le variabili siano indipendenti in ogni senso: potrebbero essere associate in modo curvilineo o differire solo in determinati sottogruppi.
Il coefficiente di correlazione di Pearson, indicato con r, quantifica la forza e la direzione della relazione lineare fra due grandezze quantitative. Il suo valore è compreso fra −1 e +1. Un valore vicino a +1 indica che, nei dati osservati, valori sopra la media di una variabile tendono a coincidere proporzionalmente con valori sopra la media dell'altra. Un valore vicino a −1 indica una relazione lineare inversa. Un coefficiente pari a zero significa che non è stata rilevata una relazione lineare nel campione; non significa che tutte le forme possibili di dipendenza siano assenti.
La formula campionaria può essere scritta come r = Σ[(xᵢ − x̄)(yᵢ − ȳ)] / √{Σ(xᵢ − x̄)² · Σ(yᵢ − ȳ)²}. Il numeratore combina gli scarti dalla media: quando le due variabili tendono a crescere insieme, i prodotti sono prevalentemente positivi; quando una sale mentre l'altra scende, sono prevalentemente negativi. Il denominatore normalizza la covariazione rispetto alla dispersione delle singole variabili. Per questo il coefficiente non dipende dalle unità impiegate, per esempio secondi anziché minuti, purché la trasformazione sia lineare con fattore positivo.
La correlazione di Pearson è sensibile ai valori estremi e si presta poco, senza accorgimenti, a relazioni fortemente non lineari. In altri contesti si usa il coefficiente di Spearman, costruito sui ranghi e utile a descrivere associazioni monotone. La scelta non dovrebbe dipendere dal risultato più favorevole dopo avere provato numerosi indici: deve riflettere scala di misura, distribuzione e ipotesi formulata. Prima del numero, è spesso più istruttivo osservare un diagramma di dispersione, nel quale ogni punto rappresenta una coppia di osservazioni.
Un dataset interamente didattico
Immaginiamo dodici studenti che abbiano registrato le ore di ripasso nell'ultima settimana e il punteggio ottenuto in una verifica su cento punti. I valori della Tabella 2.2 sono stati inventati esclusivamente a scopo didattico: non derivano da studenti reali, e non vogliono stimare alcun effetto della durata di studio nella popolazione. Sono utili per eseguire calcoli trasparenti e mostrare come un'associazione venga rappresentata graficamente.
Tabella 2.2. Ore di ripasso e punteggi: dodici osservazioni fittizie
Studente | Ore di ripasso | Punteggio / 100 |
|---|---|---|
A | 2 | 53 |
B | 3 | 61 |
C | 4 | 55 |
D | 4 | 67 |
E | 5 | 62 |
F | 6 | 70 |
G | 6 | 64 |
H | 7 | 73 |
I | 8 | 75 |
L | 9 | 72 |
M | 10 | 84 |
N | 11 | 78 |
La figura 2.1 visualizza le dodici coppie e la retta di regressione calcolata sui numeri fittizi. Il grafico permette di vedere una tendenza crescente, ma anche punti lontani dalla retta: due studenti con lo stesso numero di ore hanno ottenuto punteggi diversi. Le ore non spiegano dunque tutta la variabilità delle prestazioni. Le persone potrebbero differire per preparazione iniziale, capacità di concentrazione, complessità dei contenuti affrontati e strategie di studio. Il fatto che tali variabili non siano nella tabella non significa che non esistano: significa che questo dataset non le ha misurate.
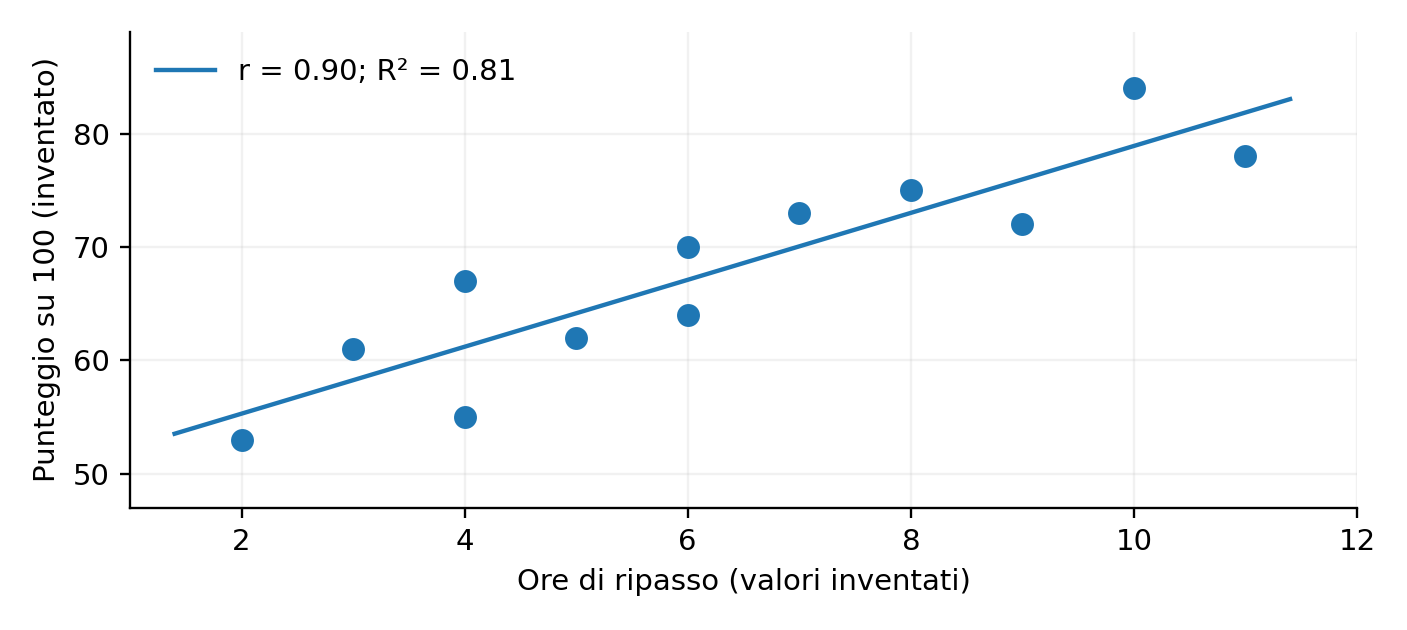
Una retta di regressione lineare semplice produce la previsione ŷ = a + bx, dove a è l'intercetta e b la pendenza stimata dai dati. Nell'esempio, la pendenza rappresenta quanti punti in più sono previsti dalla retta per un'ora aggiuntiva di ripasso. Non è corretto tradurla automaticamente nella frase «un'ora di ripasso causa un aumento di b punti»: lo studio è osservativo, e la regressione non elimina con una formula i fattori non misurati. Il coefficiente di determinazione R², pari al quadrato di r nel caso di regressione semplice con intercetta, quantifica la quota della variabilità campionaria dei punteggi rappresentata dalla retta secondo quella specifica misura; non identifica una quota di causalità.
Perché una correlazione può ingannare anche quando è corretta
Una relazione può comparire perché X influenza Y, perché Y influenza X, perché entrambe sono influenzate da una terza variabile oppure perché intervengono combinazioni di queste possibilità. Anche l'assenza di un'associazione nell'insieme del campione può nascondere relazioni differenti all'interno di sottogruppi. Il paradosso di Simpson indica situazioni in cui una tendenza osservata in gruppi separati si attenua o inverte quando le osservazioni vengono aggregate, in relazione alla distribuzione delle variabili che determinano i gruppi. Non è un gioco statistico: segnala che la struttura dei dati e la scelta dei confronti contano per l'interpretazione.
La restrizione dell'intervallo è un ulteriore problema. Se valutiamo il rapporto tra capacità linguistiche e prestazione selezionando soltanto studenti che hanno già superato un esame d'ingresso molto difficile, riduciamo la variabilità osservabile delle capacità. La correlazione nel campione selezionato può risultare diversa da quella nella popolazione più ampia, perfino quando la misura è eseguita correttamente. Anche errori di misura possono attenuare le correlazioni. Un coefficiente piccolo non equivale pertanto a una prova che il costrutto non sia rilevante, così come un coefficiente grande non è necessariamente una scoperta di grande interesse pratico.
2.6 Causalità: confondimento, selezione e diagrammi causali
Tre criteri non bastano senza un disegno plausibile
Un'affermazione causale sostiene che cambiare un fattore produrrebbe una differenza nell'esito, almeno per persone e condizioni pertinenti. È concettualmente diversa da dire che due variabili sono associate. Immaginiamo di voler sapere se l'introduzione di brevi verifiche durante il corso migliori la prestazione finale. La domanda causale confronta, per quanto possibile, due situazioni alternative per la stessa unità: che cosa sarebbe accaduto con le verifiche e che cosa sarebbe accaduto senza di esse? Questo secondo risultato, detto controfattuale, non è direttamente osservabile nello stesso momento sulla medesima persona. I disegni di ricerca cercano di costruire confronti informativi tra unità o periodi differenti.
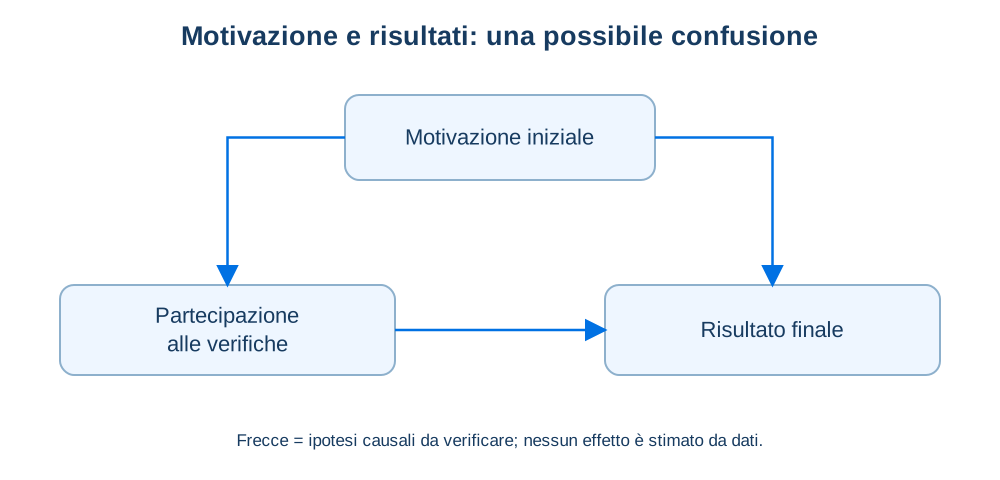
Che X preceda temporalmente Y è spesso necessario per sostenere che X ne sia una causa, ma la successione temporale non è sufficiente. Che si osservi un'associazione statistica è anch'esso un indizio, non una dimostrazione autonoma. L'elemento cruciale è l'esclusione ragionata di spiegazioni alternative. Una variabile confondente è un fattore associato all'esposizione e all'esito in modo tale da creare o alterare l'associazione stimata. Per esempio, la motivazione iniziale potrebbe influenzare sia la probabilità di scegliere verifiche volontarie sia i risultati finali.
Nella figura 2.2, disegnata appositamente, le frecce rappresentano ipotesi causali e non risultati empirici. La freccia dalla motivazione alle verifiche significa che chi è più motivato potrebbe scegliere più frequentemente di partecipare; quella dalla motivazione al voto significa che lo stesso fattore potrebbe contribuire alla prestazione. Osservare un'associazione tra partecipazione e voto non permette allora di isolare il contributo delle verifiche senza ulteriori informazioni o interventi. Il disegno grafico è un diagramma causale aciclico diretto (DAG): è uno strumento per esplicitare assunzioni, non una macchina che trasforma correlazioni in prove causali.
Controllare una variabile può essere necessario, inutile o dannoso
Spesso si propone di «controllare per tutte le variabili disponibili» attraverso una regressione multipla. Questa strategia è più fragile di quanto sembri. È opportuno considerare fattori che aprono percorsi di confondimento, ma includere indiscriminatamente variabili misurate dopo l'esposizione può cancellare parte dell'effetto che si desidera stimare. Se le verifiche favoriscono il voto anche perché aumentano il tempo dedicato al recupero attivo, controllare il numero di recuperi potrebbe eliminare dal modello una parte del processo attraverso il quale agisce l'intervento.
Un'altra difficoltà riguarda il collider, una variabile influenzata da due cause distinte. Condizionare su un collider — per esempio selezionare soltanto persone ammesse a un programma in base a due caratteristiche — può introdurre un'associazione artificiale fra cause che in precedenza erano indipendenti. Questi problemi mostrano perché l'inferenza causale richieda un modello sostantivo di come i dati siano stati generati, e non solo una selezione automatica dei predittori che producono il valore statistico più favorevole.
Altre tecniche, come il confronto tra gruppi abbinati su caratteristiche osservate, i disegni a differenze nelle differenze, le discontinuità di regressione e gli esperimenti naturali, possono rafforzare l'interpretazione causale di dati non randomizzati. Ciascuna, però, poggia su assunzioni proprie. Nel confronto tra periodi prima e dopo un cambiamento normativo, per esempio, il fatto che un indicatore sia migliorato non dimostra da solo l'effetto della nuova norma: potrebbe esserci stata una tendenza precedente, oppure un cambiamento simultaneo di altro genere. Le assunzioni devono essere dichiarate, discusse e, quando possibile, messe alla prova.
La causalità è una domanda circoscritta
Un singolo studio ben progettato può stimare l'effetto di una specifica manipolazione in una specifica popolazione senza identificare il meccanismo biologico completo e senza garantire che l'effetto si riproduca in ogni contesto. Distinguere efficacia locale e generalizzazione evita conclusioni eccessive. Se un metodo didattico migliora il risultato di una prova immediata, resta da verificare se favorisca anche il ricordo dopo mesi, la comprensione concettuale o il trasferimento a problemi nuovi. La precisione della domanda è quindi un vantaggio, non un limite da nascondere.
2.7 L'esperimento: manipolazione, randomizzazione e confronto
Che cosa rende sperimentale uno studio?
In un esperimento controllato chi ricerca modifica deliberatamente uno o più fattori e confronta gli esiti in condizioni definite. Se si vuole valutare il contributo delle domande di recupero durante lo studio, si possono assegnare partecipanti alla lettura ripetuta oppure a una procedura con tentativi di richiamo; il tempo totale impiegato, il contenuto e le istruzioni vengono mantenuti per quanto possibile comparabili. La variabile manipolata è la strategia didattica, mentre l'esito può essere il numero di risposte corrette in una verifica successiva. Qualunque differenza osservata rimane una stima con incertezza, non una misura perfetta dell'effetto per ogni persona.
L'assegnazione casuale (random assignment) attribuisce le persone alle condizioni mediante un meccanismo probabilistico. A differenza del campionamento casuale, che riguarda chi entra nello studio, l'assegnazione casuale riguarda quale trattamento riceve chi vi è già entrato. In media e sotto appropriate condizioni, la randomizzazione rende le differenze sistematiche tra condizioni meno plausibili come spiegazione alternativa, perché caratteristiche note e ignote non determinano la scelta della condizione. Non garantisce che due gruppi di poche persone risultino identici in ogni variabile: differenze accidentali sono possibili e contribuiscono all'incertezza dei risultati.
Si possono usare randomizzazioni semplici, a blocchi o stratificate. Se il campione è piccolo, una procedura a blocchi può contribuire a mantenere numerosità simili nelle condizioni; una stratificazione prima dell'assegnazione può essere ragionevole quando una caratteristica è fortemente prognostica. È importante che la sequenza di assegnazione non possa essere manipolata dagli operatori. Negli studi con scuole, reparti o famiglie, l'unità randomizzata può essere il gruppo anziché la persona: in questo caso le risposte dei membri dello stesso gruppo tendono a essere correlate e l'analisi deve tenerne conto.
Controllo, placebo e confronto attivo
La condizione di controllo serve a chiarire che cosa si stia confrontando. In alcuni casi è l'assenza dell'intervento; in altri un trattamento abituale, una procedura alternativa oppure un intervento attivo che controlla tempo, attenzione e aspettative. Nella ricerca clinica si usa talvolta un placebo, una condizione progettata per somigliare al trattamento senza includere la sua componente specifica investigata. Gli effetti osservati possono riflettere aspettative, contesto di cura, decorso naturale e altri elementi. Nessun placebo è eticamente accettabile in ogni contesto: non si deve negare un trattamento efficace quando ciò crea rischi ingiustificati.
Il cieco del valutatore limita la possibilità che sapere chi ha ricevuto un trattamento modifichi l'attribuzione dei punteggi. La standardizzazione mantiene costanti istruzioni, tempi, ambiente e modalità di raccolta. Il controllo della manipolazione verifica se l'intervento abbia prodotto il cambiamento previsto sul processo prossimale, quando tale controllo è teoricamente e metodologicamente appropriato. Non deve però diventare un criterio opportunistico per eliminare dal campione solo chi non produce l'effetto desiderato. Le decisioni di esclusione vanno specificate prima, motivate e descritte nei risultati.
Disegni tra soggetti, entro soggetti e fattoriali
Nel disegno tra soggetti persone differenti ricevono condizioni differenti; nel disegno entro soggetti ciascuna persona affronta più condizioni. Quest'ultimo disegno può essere molto preciso quando le differenze individuali sono grandi, ma bisogna gestire effetti di ordine, apprendimento e trasferimento. Un disegno fattoriale manipola più fattori, per esempio strategia di studio (lettura o recupero) e difficoltà del materiale (bassa o alta). Permette di valutare gli effetti dei singoli fattori e la loro interazione, cioè il fatto che l'effetto di un fattore cambi in funzione del livello dell'altro. Un'interazione non è una semplice addizione di due risultati: richiede un confronto delle differenze.
I quasi-esperimenti includono interventi o cambiamenti osservabili senza una completa randomizzazione delle unità. Possono essere fondamentali quando l'assegnazione casuale non è praticabile, per esempio nella valutazione di modifiche scolastiche già decise. Richiedono tuttavia argomenti espliciti sulla comparabilità dei gruppi e sulle tendenze temporali. Chiamare «esperimento» qualunque confronto prima-dopo rischia di attribuire al trattamento eventi esterni o cambiamenti spontanei.
Un piccolo esperimento immaginario con calcolo verificabile
Consideriamo un esercizio del tutto ipotetico: sedici studenti vengono suddivisi casualmente in due gruppi di otto. Tutti studiano lo stesso contenuto per venti minuti; il gruppo A rilegge il materiale, mentre il gruppo B alterna lettura e domande di recupero. Dopo una settimana, il gruppo A registra i punteggi 54, 59, 61, 60, 65, 58, 63, 64; il gruppo B 61, 66, 69, 64, 70, 65, 72, 67. Questi dati sono inventati, non derivano da un vero esperimento, e sono deliberatamente piccoli per rendere leggibile la procedura.
Le medie dei due gruppi sono differenze descrittive. Per ragionare sull'effetto occorre inoltre considerare variabilità e incertezza: la stessa differenza media ottenuta in gruppi molto variabili risulta meno precisa di quella osservata con punteggi concentrati. Il confronto verrà ripreso nella sezione sulla statistica inferenziale attraverso un intervallo di confidenza e una dimensione dell'effetto, calcolati con formule dichiarate. Il valore didattico del caso sta nel metodo, non nell'affermazione che il recupero attivo produca universalmente quel numero di punti.
2.8 Minacce alla validità: domanda, osservatore, abbandoni e decisioni analitiche
Quando il confronto tra condizioni non è credibile
La validità interna riguarda quanto sia giustificato interpretare una differenza osservata come effetto della manipolazione studiata. Una minaccia nasce quando le condizioni differiscono sistematicamente anche per altri aspetti pertinenti. Se la classe che utilizza un nuovo metodo didattico ha anche un insegnante con maggiore esperienza, non possiamo attribuire tutta la differenza al metodo. Se una sola classe riceve l'intervento e una sola funge da confronto, il problema è ancora più grave: classe, insegnante e intervento sono sostanzialmente confusi fra loro.
Le principali minacce nei disegni prima-dopo comprendono la storia — eventi intervenuti nel frattempo —, la maturazione — cambiamenti spontanei delle persone —, gli effetti di test — miglioramenti prodotti dall'aver già affrontato la misura —, modifiche dello strumento e regressione verso la media. Quest'ultima si osserva quando persone selezionate per risultati estremi tendono, in una nuova misurazione imperfetta, a mostrare valori meno estremi anche in assenza di un intervento efficace. Se scegliamo per un programma gli studenti che hanno ottenuto i voti peggiori in una giornata particolarmente difficile, un miglioramento successivo potrebbe avvenire in parte per questo motivo statistico.
La perdita selettiva dei partecipanti è un altro rischio. Se chi incontra maggiori difficoltà interrompe più spesso l'intervento, l'analisi dei soli partecipanti rimasti può sovrastimare il successo. Nei trial randomizzati l'analisi secondo l'intenzione di trattare conserva idealmente le persone nel gruppo di assegnazione originario, nei limiti dei dati disponibili e con procedure trasparenti per i dati mancanti. Non risolve automaticamente la perdita di informazioni, ma riduce il rischio di confondere il risultato dell'assegnazione con la scelta successiva di aderire o meno.
Analizzare dati non significa scegliere il risultato più gradevole
Nella ricerca reale occorre decidere come trattare valori mancanti, quali casi escludere, quali covariate includere, come trasformare variabili e quali modelli stimare. Quando molte decisioni vengono prese dopo avere esaminato i risultati e solo la combinazione più favorevole viene resa visibile, si parla spesso di flessibilità analitica non dichiarata. Il problema non è che esista un'unica analisi corretta: è che il lettore non può distinguere un test previsto da uno selezionato dopo tentativi ripetuti. Questa pratica può aumentare i falsi positivi e peggiorare la replicabilità.
L'espressione p-hacking indica un insieme di pratiche che sfruttano decisioni analitiche per ottenere o evidenziare significatività statistica. Non ogni analisi esplorativa è p-hacking, e non ogni scelta successiva all'osservazione dei dati è illegittima; il criterio decisivo è la trasparenza. Se una strategia inizialmente prevista non funziona perché una variabile presenta errori gravi, è legittimo adottare un'analisi alternativa spiegandone ragioni e natura. È scorretto presentare come pianificazione originaria una scelta effettuata perché produceva l'esito desiderato.
Le analisi di sensibilità verificano come cambiano le stime sotto decisioni ragionevoli differenti. Per esempio, una relazione può essere stimata con e senza alcuni valori estremi chiaramente identificati, oppure con modelli che trattano diversamente la distribuzione dell'esito. Se la conclusione cambia drasticamente, ciò è un'informazione sostanziale da raccontare, non un difetto da occultare. La stabilità fra metodi diversi può rafforzare la fiducia, pur senza rimuovere bias condivisi da tutte le analisi.
Validità statistica, interna, di costrutto ed esterna
L'espressione «uno studio valido» è troppo generica. La validità statistica riguarda il rapporto fra dati, modello, incertezza e conclusione numerica. La validità interna concerne l'attribuzione causale entro le condizioni studiate. La validità di costrutto chiede se manipolazioni e strumenti rappresentino davvero i concetti teorici. La validità esterna riguarda la trasferibilità a persone, contesti, tempi e procedure diversi. Uno studio può essere molto convincente su un livello e più debole su un altro.
Tabella 2.3. Quattro domande per valutare la validità
Forma di validità | Domanda centrale | Problema esemplificativo | Verifica utile |
|---|---|---|---|
Statistica | Le stime e l'incertezza sono interpretate correttamente? | Numerosi confronti non dichiarati | Piano d'analisi e verifiche robuste |
Interna | La differenza può essere attribuita all'intervento? | Insegnanti diversi nelle condizioni | Randomizzazione e controllo delle condizioni |
Di costrutto | Lo strumento rappresenta davvero il concetto? | «Empatia» misurata da un solo gesto ambiguo | Più indicatori, teoria e validazione |
Esterna | Il risultato può essere esteso oltre lo studio? | Solo volontari di un corso universitario | Repliche con popolazioni e compiti diversi |
Le validità non sono quattro timbri indipendenti da apporre dopo lo studio. Costituiscono criteri collegati: se il costrutto è mal rappresentato, la precisione numerica non salva l'interpretazione psicologica.
2.9 Descrivere i dati: distribuzioni, medie, dispersione e grafici
Dal dato individuale alla distribuzione
Una misurazione isolata è spesso poco informativa. Sapere che una persona ha impiegato settecento millisecondi per rispondere a uno stimolo non indica se la risposta sia rapida, lenta o ordinaria rispetto al compito. Occorre conoscere una distribuzione, ossia il modo in cui i valori si distribuiscono tra le osservazioni. Possiamo organizzarli in una tabella di frequenze, rappresentarli in un istogramma o sintetizzarli con indici numerici. Queste operazioni appartengono alla statistica descrittiva: presentano ciò che abbiamo osservato senza attribuire automaticamente i risultati all'intera popolazione o a un processo causale.
In un istogramma l'asse orizzontale rappresenta intervalli di valori numerici e le barre mostrano quante osservazioni ricadono in ciascuno; la larghezza degli intervalli modifica l'impressione visiva e deve essere scelta con criterio. Un grafico a barre è invece particolarmente adatto a categorie distinte, come i diversi tipi di risposta. Un diagramma di dispersione mostra coppie di variabili quantitative; un grafico a linee può descrivere cambiamenti nel tempo, purché l'ordine delle osservazioni sia rilevante. Grafici tridimensionali, assi troncati senza giustificazione o scale incoerenti possono accentuare artificialmente differenze modeste.
Per riassumere il centro di una distribuzione si usano spesso media, mediana e moda. La media aritmetica di n osservazioni è x̄ = Σxᵢ/n: si sommano i valori e si divide per il loro numero. La mediana è il valore che divide in due parti ordinate la distribuzione; con un numero pari di osservazioni è convenzionalmente la media dei due valori centrali. La moda è il valore più frequente. Le tre misure possono coincidere in una distribuzione simmetrica, ma differire molto quando sono presenti asimmetrie o valori estremi.
Immaginiamo cinque tempi di completamento di un compito, in minuti: 8, 9, 10, 11 e 42. La media è 16 minuti, mentre la mediana è 10. Entrambi i numeri sono matematicamente corretti, ma raccontano aspetti diversi: un singolo completamento molto lungo sposta la media senza modificare altrettanto la posizione centrale. Se si progetta un servizio in cui interessa il tempo medio complessivo richiesto dalle persone, la media può essere essenziale; se si descrive il tempo «tipico» dell'utente, la mediana può risultare più rappresentativa. Nascondere il valore 42 perché «disturba» il grafico sarebbe però sbagliato senza un motivo verificabile, per esempio un errore di registrazione documentato.
La variabilità conta quanto il valore medio
La dispersione descrive quanto i valori differiscano fra loro. L'intervallo di variazione (range) è la differenza tra massimo e minimo; l'intervallo interquartile è la distanza tra il terzo e il primo quartile e riassume la metà centrale della distribuzione. La varianza campionaria può essere scritta s² = Σ(xᵢ − x̄)²/(n − 1); la deviazione standard campionaria s è la sua radice quadrata ed è espressa nelle stesse unità della variabile. Il denominatore n − 1 compare in questa stima convenzionale della varianza della popolazione da osservazioni indipendenti e identicamente distribuite; non è una correzione universale appropriata in ogni disegno.
Due classi potrebbero avere entrambe una media di 70 punti ma distribuzioni molto diverse. Nella prima quasi tutti gli studenti ottengono un risultato compreso tra 67 e 73; nella seconda molti ottengono 40 o 100. Il valore medio è identico, mentre il significato formativo è molto differente: nella prima classe la prestazione è relativamente omogenea, nella seconda sembra esserci una forte eterogeneità. Per descrivere gruppi reali è quindi utile mostrare sia tendenza centrale sia dispersione, e possibilmente il grafico della distribuzione.
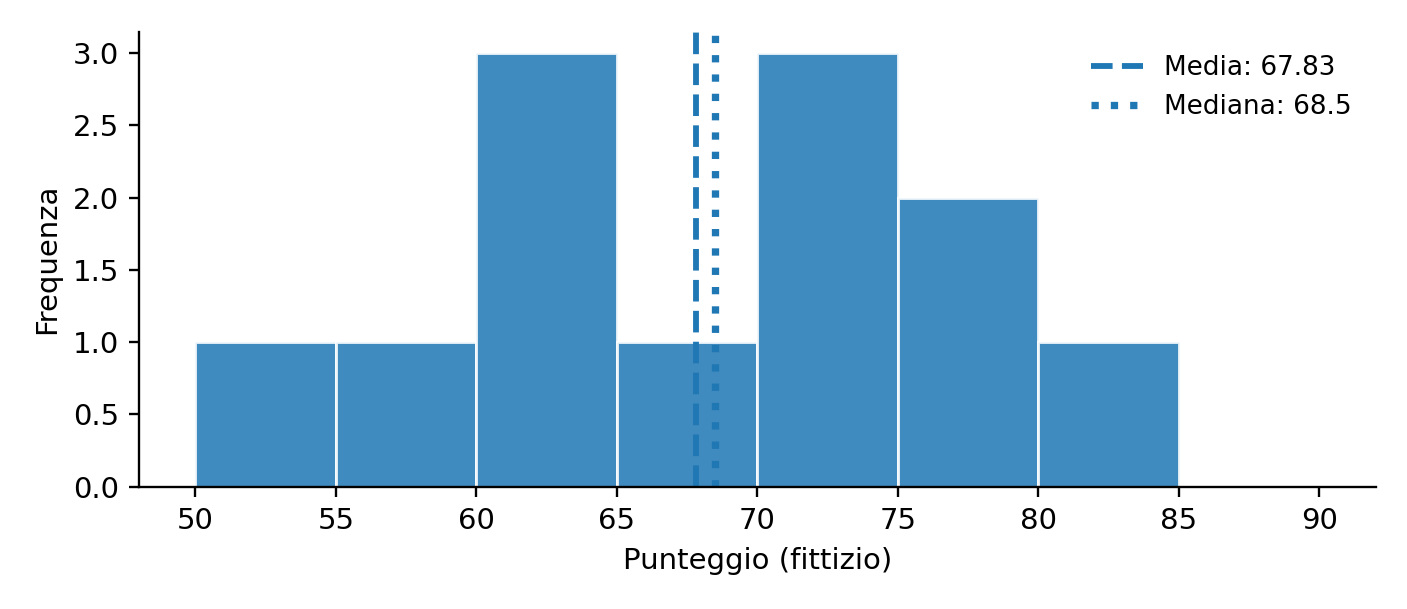
Nell'esempio didattico della Tabella 2.2 la media dei punteggi è 67,83 e la mediana 68,5; la deviazione standard campionaria è circa 9,27 punti. La figura 2.3 mostra la distribuzione fittizia e, accanto, mette in evidenza la differenza tra una rappresentazione degli individui e un riassunto statistico. Il risultato non consente di parlare di «voti medi universitari»: la tabella è costruita a scopo di esercizio e contiene soltanto dodici osservazioni inventate.
Valori anomali, percentili e standardizzazione
Un outlier è un'osservazione che appare distante dalle altre secondo criteri descrittivi o modellistici. Può essere un errore, un evento raro autentico oppure il segnale che la popolazione contiene sottogruppi. Eliminarlo automaticamente può essere tanto problematico quanto ignorarlo: entrambe le scelte vanno giustificate e, se influenzano il risultato, documentate. Un percentile indica una posizione nella distribuzione ordinata, non la percentuale di domande corrette: trovarsi al novantesimo percentile di un test significa collocarsi, secondo la definizione e i criteri normativi usati, al livello o al di sopra di circa il novanta per cento dei valori del gruppo di riferimento.
Per confrontare valori espressi in unità diverse si può calcolare un punteggio standardizzato, o z-score: z = (x − μ)/σ quando sono note media e deviazione standard della popolazione, oppure una versione campionaria con x̄ e s. Un punteggio z = 1 si colloca una deviazione standard sopra la media di riferimento. Questo non significa che la persona abbia raggiunto un «livello psicologico ottimo»: lo z-score descrive una posizione relativa rispetto a un gruppo. Se la distribuzione è molto asimmetrica, gli z-score restano calcolabili ma non permettono automaticamente di attribuire probabilità secondo la curva normale.
2.10 Dalla descrizione all'inferenza: stime, intervalli e test
Perché stimare significa accettare l'incertezza
La statistica inferenziale affronta una domanda diversa da quella descrittiva: che cosa possiamo dire, con quale incertezza, riguardo a una popolazione o a un processo a partire da osservazioni limitate? Una media campionaria può variare da un campione all'altro anche quando ogni misurazione è corretta. Questa variabilità campionaria non è un errore da nascondere: costituisce una caratteristica fondamentale dell'inferenza. La precisione dipende dalla numerosità effettiva, dalla variabilità delle osservazioni, dalla dipendenza tra dati e dalle assunzioni del modello.
La distribuzione campionaria di una statistica descrive come quella statistica varierebbe ripetendo idealmente il campionamento secondo uno stesso meccanismo. Se estraiamo ripetutamente campioni casuali di una certa ampiezza dalla medesima popolazione, le loro medie non saranno identiche; tenderanno però a concentrarsi attorno al valore della popolazione quando gli assunti sono soddisfatti. L'errore standard quantifica proprio la dispersione di una statistica stimata secondo un modello di campionamento. Non va confuso con la deviazione standard, che descrive la variabilità delle singole osservazioni: nella situazione elementare di dati indipendenti e comparabili l'errore standard della media viene stimato come s/√n.
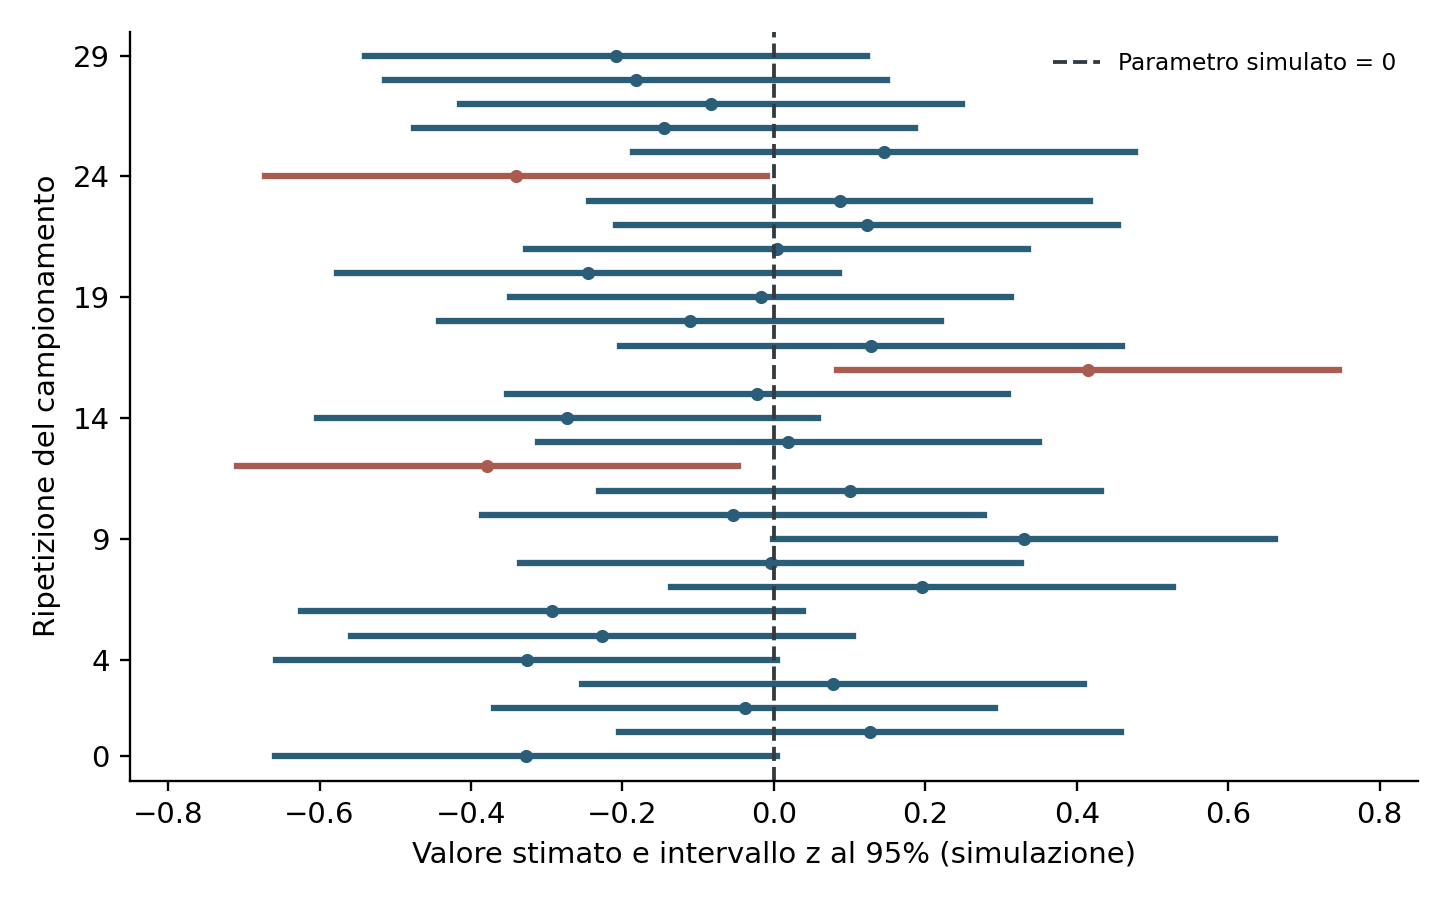
Un intervallo di confidenza al 95% è ottenuto da una procedura che, ripetuta in molte nuove raccolte di dati sotto le assunzioni previste, produce intervalli contenenti il parametro vero nel 95% dei casi. Dopo che uno specifico intervallo frequentista è stato calcolato, il parametro non «ha una probabilità del 95% di trovarsi lì» nel significato tecnico del metodo: il parametro è trattato come fisso, mentre a variare casualmente sono gli intervalli. La formulazione intuitiva «intervallo plausibile» può essere utile come prima approssimazione, ma non deve sostituire la definizione della procedura.
Leggere un intervallo senza ridurlo al suo segno
Riprendiamo l'esperimento fittizio sui sedici studenti. Le medie sono 60,50 nel gruppo di sola lettura e 66,75 nel gruppo con recupero; la differenza media campionaria, definita come B meno A, è 6,25 punti. Usando un intervallo di confidenza al 95% basato sul t di Welch, che non impone varianze uguali nei due gruppi e assume osservazioni indipendenti entro e tra gruppi, si ottiene approssimativamente un intervallo da 2,43 a 10,07 punti. Si tratta di un calcolo verificato esclusivamente sui numeri inventati. La sua interpretazione presuppone che il procedimento di raccolta e il modello statistico siano adeguati: il calcolo corretto non rende reali i dati fittizi.
L'intervallo non dice che ogni studente migliorerebbe tra 2,43 e 10,07 punti. Si riferisce all'incertezza nella stima di una differenza media, non alla previsione della risposta individuale. Inoltre non dimostra da solo che il risultato possa essere generalizzato a ogni materia e a tutte le durate di studio. Un intervallo stretto può riguardare un indicatore poco valido; un intervallo ampio può accompagnare una ricerca preziosa che studia un fenomeno difficile da osservare. La quantità di informazione e la qualità dell'interpretazione devono essere valutate insieme.
La figura 2.4 illustra l'idea di ripetizione del campionamento con un modello simulato, non con dati osservati in studi psicologici. Mostra alcune stime e i relativi intervalli, evidenziando che singoli intervalli possono non comprendere il parametro utilizzato per generare la simulazione. La copertura del 95% riguarda la procedura sotto le ipotesi modellistiche, non una promessa su ciascun intervallo. L'illustrazione è una dimostrazione computazionale progettata per insegnare l'interpretazione della confidenza.
Il valore p: quello che significa e quello che non significa
Un test di ipotesi confronta le osservazioni con un modello statistico. Nella formulazione classica si definisce una ipotesi nulla, per esempio che la differenza media fra due condizioni sia zero nel modello, e si sceglie una statistica di test appropriata. Il valore p misura quanto sarebbero incompatibili dati almeno altrettanto estremi di quelli osservati con l'ipotesi nulla e le assunzioni del test. È una probabilità relativa a possibili risultati condizionata sul modello nullo, non la probabilità che l'ipotesi nulla sia vera.
Se un test restituisce p = 0,03, non possiamo dire «c'è soltanto il 3% di probabilità che la scoperta sia falsa», né «c'è il 97% di probabilità che la teoria sia corretta». Queste frasi confondono la probabilità dei dati dato un modello con la probabilità del modello dati i dati. Il valore p non misura inoltre la grandezza dell'effetto, il beneficio pratico, il valore etico dello studio o la probabilità che una replica riesca. Risultati molto piccoli possono diventare «statisticamente significativi» in campioni enormi; effetti potenzialmente importanti possono restare incerti in studi piccoli.
La soglia convenzionale di 0,05 non è una legge della natura. Se fissata in anticipo per una specifica procedura, rappresenta una regola decisionale che controlla un determinato tasso di errore a lungo termine sotto assunzioni adeguate. Separare rigidamente p = 0,049 da p = 0,051 come se descrivessero due mondi qualitativamente diversi produce interpretazioni arbitrarie. Una relazione credibile deve essere discussa attraverso stime, incertezza, disegno, plausibilità delle alternative e convergenza con altre prove.
Per i punteggi immaginari dei due gruppi, il test di Welch produce t ≈ 3,51, con circa 14 gradi di libertà e p ≈ 0,0035 in un confronto bilaterale. Il calcolo mostra come applicare un test, non è una «scoperta pubblicabile» né una misura empirica dell'efficacia del recupero attivo. Poiché il dataset è stato costruito appositamente, qualunque tentativo di trarne un'affermazione scientifica sul mondo reale sarebbe metodologicamente scorretto.
Errori di primo e secondo tipo, potenza e numerosità
Un errore di primo tipo si verifica quando una procedura rifiuta l'ipotesi nulla benché essa sia vera secondo il modello. Un errore di secondo tipo si verifica quando non la rifiuta benché sia falsa in un modo specificato. La potenza statistica è la probabilità che un test segnali un effetto secondo un'alternativa definita, data una soglia e un disegno. Perciò non è una proprietà assoluta di uno studio «potente»: varia con l'effetto che si desidera rilevare, la dispersione e il criterio adottato.
Se vengono eseguiti venti test indipendenti con soglia del 5%, tutti sotto ipotesi nulle vere e con test correttamente calibrati, la probabilità di ottenere almeno un risultato falsamente positivo è 1 − (0,95)²⁰, circa 64,2%. La formula è un esempio matematico sotto indipendenza, non una descrizione automatica di qualunque progetto con venti confronti; test correlati possono avere un comportamento diverso. Il messaggio generale, però, è importante: la selezione di risultati favorevoli dopo molte prove può creare una falsa impressione di conferma. Le correzioni per confronti multipli, i piani analitici e la trasparenza sulle analisi riducono questa difficoltà in modi differenti.
Per quantificare la dimensione di un risultato si ricorre a misure di effetto. La differenza media di 6,25 punti è un effetto espresso nell'unità del test; la d di Cohen divide la differenza per una misura della deviazione standard comune. Nel caso didattico la d non corretta è circa 1,76, un valore grande secondo molte convenzioni descrittive, ma interamente determinato dai numeri inventati e da un campione minuscolo. Una dimensione dell'effetto standardizzata non deve essere interpretata indipendentemente da attendibilità dello strumento, distribuzione dei punteggi, contesto e intervallo di incertezza. Le soglie «piccolo, medio, grande» sono orientamenti storici, non categorie universali per tutte le discipline.
Alternative frequentiste e inferenza bayesiana
Accanto ai test frequentisti esistono approcci bayesiani, che combinano una distribuzione iniziale delle credenze modellistiche (prior) con la verosimiglianza dei dati per ottenere una distribuzione aggiornata (posterior). In questo contesto è possibile formulare probabilità dirette su parametri, entro un modello e una scelta di prior esplicita. Un intervallo credibile al 95%, per esempio, ha un'interpretazione probabilistica sul parametro secondo il modello bayesiano. Non è automaticamente superiore a un intervallo di confidenza: la qualità dipende dalle assunzioni, dalla scelta della prior e dalla sensibilità dei risultati.
Un fattore di Bayes confronta quanto due modelli rendono plausibili i dati osservati. Non fornisce da solo la probabilità finale di un'ipotesi e va letto alla luce delle specificazioni dei modelli. Approcci diversi possono rispondere a domande leggermente differenti; ciò che conta, per il lettore, è sapere quale domanda ha effettivamente affrontato l'analisi e quali decisioni rimangono incerte. La statistica non sostituisce il ragionamento teorico, ma lo costringe a essere più disciplinato.
2.11 Misurare bene: attendibilità, validità e trasferibilità
Ripetibilità non equivale a verità
Uno strumento è attendibile quando produce misurazioni sufficientemente coerenti rispetto alla fonte di variabilità che intende catturare. Possiamo valutare la stabilità test-retest, somministrando una misura in due occasioni quando il costrutto dovrebbe rimanere relativamente stabile; la coerenza interna, che riguarda le relazioni fra gli item di una scala; e l'accordo tra valutatori, se le osservazioni dipendono da una codifica umana. Queste caratteristiche descrivono aspetti diversi e non devono essere trattate come sinonimi. Una scala potrebbe avere un'alta coerenza interna perché le domande sono quasi ripetitive, pur coprendo solo una piccola parte del concetto che dichiara di valutare.
La validità di misura richiede di giustificare l'interpretazione e l'uso dei punteggi. Non è una proprietà immutabile stampata sul frontespizio di un test. Un questionario può avere buone evidenze per adulti che parlano una determinata lingua e non essere automaticamente adatto a bambini o a una traduzione. Le evidenze comprendono adeguatezza del contenuto, processi di risposta, struttura interna, relazioni con altre misure e conseguenze dell'utilizzo. Per esempio, se uno strumento pretende di misurare comprensione della lettura ma premia soprattutto la velocità di digitazione, una componente estranea al costrutto può distorcere i risultati.
Le correlazioni con misure simili sostengono la validità convergente; la distinzione da caratteristiche teoricamente differenti sostiene quella discriminante. La capacità di prevedere un criterio pertinente può essere parte delle evidenze di validità, ma è necessario evitare circoli logici: se il criterio è quasi identico al test, una correlazione elevata non prova una generalizzazione utile. Un risultato psicometrico va interpretato con le caratteristiche del campione, la procedura e l'impiego previsto.
Errori casuali ed errori sistematici
L'errore casuale produce variazioni imprevedibili attorno al valore che vorremmo stimare, secondo un modello; l'errore sistematico sposta invece le osservazioni in una direzione relativamente coerente. Un cronometro che avvia la misurazione con un ritardo costante può fornire tempi molto stabili ma sistematicamente sbagliati. Analogamente, una scala psicologica può risultare coerente pur riflettendo risposte di desiderabilità sociale più che il costrutto proposto. Maggiore attendibilità può essere necessaria per una buona validità, ma non la garantisce.
Un problema particolarmente importante nei confronti tra gruppi riguarda l'invarianza della misurazione: a parità del costrutto che si intende misurare, gli item funzionano in modo sufficientemente comparabile in gruppi diversi? Una domanda su «sentirsi liberi di parlare durante una riunione» può assumere significati e vincoli differenti tra contesti culturali, gerarchie lavorative e ambienti digitali. Senza verifiche, una differenza media potrebbe riflettere la struttura dello strumento, le condizioni di risposta o vere differenze nel fenomeno; queste possibilità vanno distinte.
Dal laboratorio alla vita: validità ecologica ed eterogeneità degli effetti
La validità ecologica riguarda la pertinenza delle condizioni di studio rispetto ai contesti in cui il fenomeno si manifesta. Non è identica alla validità esterna: un laboratorio apparentemente artificiale può rivelare un processo che opera in numerosi ambienti reali, mentre una rilevazione naturalistica può essere poco rappresentativa di altre situazioni. Il trasferimento dipende dalla corrispondenza fra i meccanismi, i compiti e le popolazioni studiati. Per questo una replica che cambia deliberatamente contesto può essere scientificamente informativa anche quando non riproduce esattamente la stessa grandezza dell'effetto.
Gli effetti eterogenei sono differenze nella risposta tra persone, contesti o momenti. Una media positiva può coesistere con effetti nulli o negativi per alcuni gruppi. La ricerca su moderatori deve però essere progettata con sufficiente informazione: separare un campione già piccolo in molti sottogruppi può produrre stime instabili. L'obiettivo non è ricavare una «regola personalizzata» da ogni differenza osservata, ma distinguere pattern robusti da oscillazioni casuali.
2.12 Replicabilità, scienza aperta, sintesi delle prove ed etica
Perché una scoperta non finisce con un articolo
La pubblicazione di uno studio costituisce una tappa della discussione scientifica, non la sua conclusione. Una replica diretta cerca di riprodurre il più fedelmente possibile le condizioni rilevanti per una specifica affermazione; una replica concettuale testa una previsione simile attraverso misure o procedure diverse. La prima è utile per valutare la stabilità di un risultato sotto condizioni comparabili; la seconda può sostenere la portata teorica di un meccanismo, ma diventa più difficile interpretare una divergenza quando cambiano molte caratteristiche contemporaneamente.
In psicologia si distingue spesso tra riproducibilità computazionale, cioè la possibilità di ottenere gli stessi risultati analitici usando dati e codice disponibili, e replicabilità empirica, cioè l'ottenimento di evidenze compatibili in nuovi studi. Una ricerca può essere perfettamente riproducibile sul computer e nondimeno aver misurato male un costrutto; un nuovo studio può non raggiungere una soglia di significatività anche quando l'effetto sottostante è simile, se la precisione è insufficiente. Confrontare soltanto l'etichetta «significativo/non significativo» non è un criterio adeguato per decidere se due risultati siano compatibili.
Un progetto collaborativo pubblicato nel 2015 sulla replicazione di ricerche psicologiche ha contribuito a mostrare la necessità di migliorare trasparenza, qualità della misurazione e progettazione. I suoi risultati non autorizzano a sostenere che una percentuale fissa di «tutta la psicologia» sia falsa: gli studi scelti, i protocolli, le differenze tra effetti e le definizioni di successo influiscono sull'interpretazione. La lezione metodologica è più importante di uno slogan: occorre stimare la robustezza delle evidenze, dichiarare l'incertezza e sostenere verifiche indipendenti.
Preregistrazione, Registered Reports e condivisione responsabile
La preregistrazione è la documentazione datata delle ipotesi, del disegno e delle principali decisioni analitiche prima di conoscere i dati rilevanti per la verifica. Riduce l'ambiguità tra previsioni originarie e analisi successive, ma non rende automaticamente buona una ricerca: si possono preregistrare ipotesi poco motivate o misure inadeguate. Le analisi non previste restano ammissibili, purché siano presentate come esplorative. L'elemento eticamente e scientificamente importante è la tracciabilità del percorso che porta ai risultati.
Nei Registered Reports una parte del manoscritto — problema, teoria e metodo — viene valutata prima della raccolta dei risultati definitivi. In caso di accettazione preliminare, la pubblicazione non dipende semplicemente dal fatto di avere ottenuto un valore p inferiore a una soglia; restano necessarie qualità esecutiva e rispetto del protocollo concordato. Questa impostazione contrasta alcuni incentivi a pubblicare solo risultati sorprendenti. Non elimina però automaticamente errori, problemi etici o divergenze interpretative.
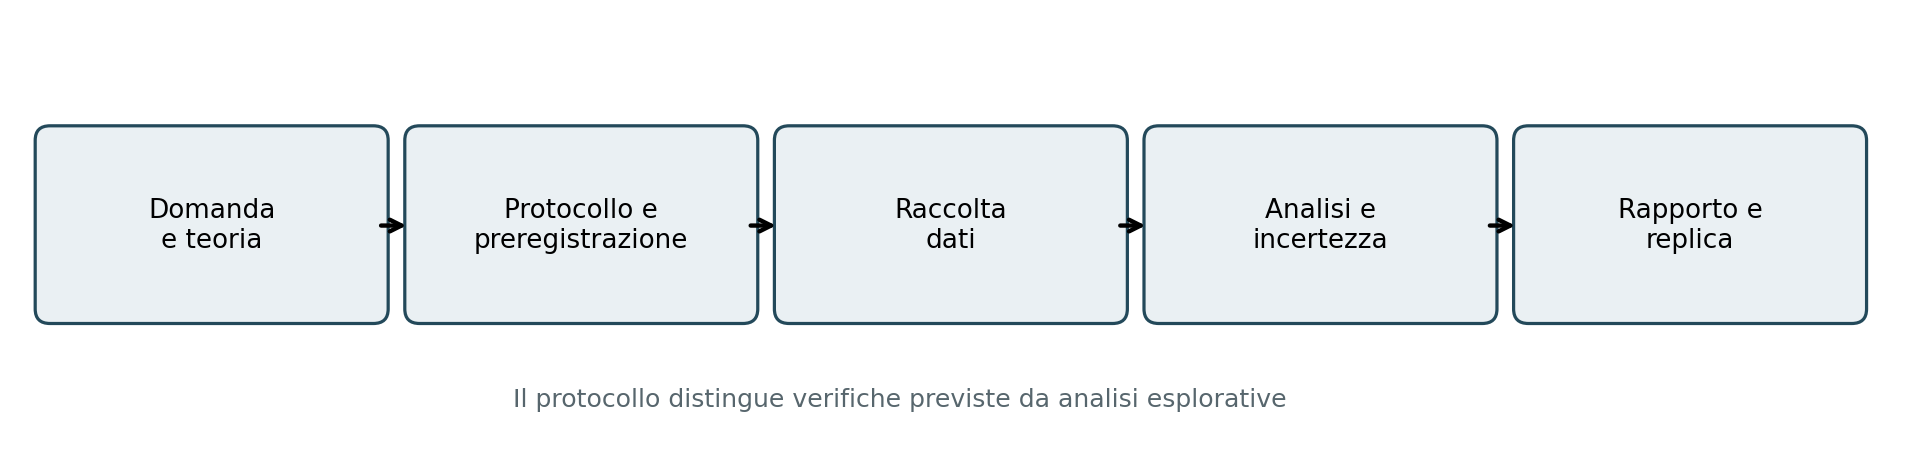
La figura 2.5 schematizza il ciclo di una ricerca trasparente distinguendo decisioni fissate prima dei risultati, verifiche analitiche e successive repliche: le frecce illustrano un processo ideale, non una procedura obbligatoria identica in ogni progetto.
La condivisione di dati, materiali e codice può facilitare controlli e nuove analisi. In psicologia occorre bilanciarla con il rispetto della riservatezza: dati apparentemente anonimizzati possono essere reidentificabili quando contengono combinazioni rare di caratteristiche. Non si devono pubblicare informazioni personali sensibili solo perché la scienza aperta è un valore. Quando la diffusione integrale non è appropriata, si possono prevedere dati sintetici, accessi controllati, protocolli di richiesta o materiali analitici sufficienti a documentare il metodo senza esporre le persone.
Revisioni sistematiche e meta-analisi
Una revisione sistematica formula una domanda esplicita, ricerca studi secondo criteri dichiarati, valuta la loro qualità e sintetizza ciò che emerge. Non coincide con una selezione narrativa di articoli che sembrano interessanti. Una meta-analisi combina quantitativamente risultati di più studi mediante un modello: può aumentare la precisione e mostrare eterogeneità, ma non trasforma automaticamente dati di bassa qualità in prove solide. Se gli studi condividono un errore sistematico, anche una sintesi eseguita correttamente può risentirne.
Nelle meta-analisi è fondamentale distinguere eterogeneità, ossia differenze tra gli effetti stimati che superano o comprendono la semplice variazione campionaria a seconda del modello, e bias di pubblicazione, cioè la maggiore disponibilità o visibilità di risultati selezionati. Grafici come il funnel plot possono suggerire asimmetrie, ma non stabiliscono da soli che esista una precisa causa. Il giudizio sulla qualità di una sintesi richiede di leggere protocolli, criteri di inclusione, definizioni degli esiti, qualità delle misure e analisi di sensibilità.
Etica: il metodo è anche una relazione di responsabilità
La ricerca psicologica coinvolge persone con aspettative, vulnerabilità e diritti. Il consenso informato richiede che chi partecipa riceva informazioni comprensibili sulle attività previste, sui rischi, sui benefici ragionevolmente attesi, sul trattamento dei dati e sulla possibilità di ritirarsi secondo condizioni esplicitate. Il consenso non è una semplice firma: è un processo di comunicazione che deve tenere conto della capacità decisionale, di eventuali rapporti di dipendenza e delle pressioni implicite. Per minori e altre situazioni particolari si applicano ulteriori protezioni, secondo le norme e i protocolli pertinenti.
Tre principi fondamentali, formulati in modo particolarmente influente nel Rapporto Belmont, sono rispetto delle persone, beneficenza e giustizia. Il rispetto implica autonomia e protezione di chi ha autonomia ridotta; la beneficenza richiede una valutazione ponderata di rischi e benefici; la giustizia riguarda l'equa distribuzione di oneri e vantaggi della ricerca. Questi principi non offrono automaticamente la soluzione a ogni dilemma, ma costringono il ricercatore a rendere giustificabili le scelte: perché coinvolgere proprio quella popolazione, perché raccogliere proprio quei dati, perché esporre le persone a quel livello di rischio?
L'inganno sperimentale può essere scientificamente giustificato in circostanze limitate, quando conoscere in anticipo lo scopo preciso comprometterebbe la misura e non esistono alternative adeguate; deve rispettare requisiti etici e di revisione istituzionale pertinenti. Il debriefing consiste nello spiegare successivamente aspetti rilevanti della procedura, offrendo chiarimenti e ascolto dove appropriato. Non è una formula magica che cancella il danno: alcuni rischi e forme di inganno sono inaccettabili anche se vengono spiegati dopo. Gli studi storici sull'obbedienza e sulla conformità, discussi nel capitolo precedente, mostrano quanto le valutazioni etiche possano evolvere e quanto sia insufficiente giustificare ogni mezzo in nome di un risultato scientificamente interessante.
La ricerca con animali esige giustificazione della necessità, valutazione del benessere, riduzione della sofferenza e rispetto degli standard legali e istituzionali vigenti. Il quadro delle 3R — sostituzione (replacement), riduzione (reduction) e perfezionamento (refinement) — orienta la scelta verso metodi alternativi quando possibili, il numero di animali giustificato e procedure meno dannose. Anche la selezione di modelli animali ha implicazioni scientifiche: somiglianze biologiche non garantiscono identità nei comportamenti complessi e nell'esperienza soggettiva.
Etica della comunicazione e uso responsabile dell'intelligenza artificiale
L'integrità della ricerca non riguarda soltanto ciò che accade in laboratorio. La selezione delle analisi, l'attribuzione corretta dei contributi, la conservazione dei dati, la segnalazione di errori e la comunicazione pubblica dei risultati fanno parte della responsabilità scientifica. Una notizia che trasforma «è stata osservata un'associazione in un campione limitato» in «è stata scoperta la causa universale» può indurre decisioni sbagliate anche se l'articolo originario era prudente. La divulgazione deve quindi mantenere la differenza tra risultato, interpretazione e applicazione.
Gli strumenti di intelligenza artificiale possono assistere nella programmazione, nella ricerca bibliografica, nella trascrizione o nella classificazione di materiali. Non dispensano dalla verifica di accuratezza e riproducibilità: possono introdurre errori, amplificare disuguaglianze dei dati, facilitare analisi opportunistiche o generare riferimenti inesistenti. Un impiego responsabile documenta gli strumenti, verifica manualmente risultati e fonti, protegge dati personali e preserva la possibilità di ricostruire le scelte analitiche. La responsabilità dell'affermazione scientifica resta in capo a chi conduce e presenta la ricerca.
Dalla lettura critica a una decisione ragionevole
Il lettore informato non deve sospettare indiscriminatamente di ogni articolo né credere automaticamente a ogni dato stampato. Può porsi una sequenza di domande: che cosa è stato davvero misurato? Chi è stato osservato? Quale confronto è stato costruito? Quali alternative causali rimangono? Quanto è grande e quanto è incerta la stima? Quanto sono affidabili i metodi? Esistono risultati convergenti o repliche? Quale uso pratico si vorrebbe fare dell'informazione e quali conseguenze potrebbe avere un errore?
Questo atteggiamento è scetticismo metodologico, non scetticismo indiscriminato. Significa dare alle affermazioni un grado di fiducia proporzionato alle prove e rendersi disponibili a cambiare idea. È lo stesso atteggiamento che permette alla psicologia di studiare fenomeni complessi senza pretendere di possedere certezze assolute, e di migliorare nel tempo attraverso nuove osservazioni, critiche competenti e correzioni pubbliche.
Tabella 2.4. Che cosa possiamo inferire da un disegno di ricerca?
Disegno | Quesito particolarmente adatto | Forza | Limite principale |
|---|---|---|---|
Osservazione naturalistica | Come si manifesta un comportamento nella vita quotidiana? | Contesto vicino alle pratiche reali | Scarso controllo dei confondenti |
Studio correlazionale | Quali variabili si associano? | Descrive pattern e sostiene previsioni | Non isola da solo le cause |
Studio longitudinale | Come cambia un fenomeno nel tempo? | Ordine temporale e traiettorie individuali | Perdite di partecipanti e fattori concomitanti |
Esperimento randomizzato | Che effetto ha una manipolazione specifica? | Confronto causale in condizioni definite | Trasferibilità e aderenza possono essere limitate |
Ricerca qualitativa | Come viene vissuta e interpretata un'esperienza? | Profondità contestuale e sviluppo di concetti | La generalizzazione richiede criteri differenti |
Revisione sistematica | Che cosa emerge dall'insieme degli studi? | Ricerca e sintesi con criteri documentati | Dipende dalla qualità delle prove incluse |
2.13 Dalla popolazione osservata alla popolazione di interesse: rappresentatività, pesi e selezione
Il campione non è una miniatura automatica della popolazione
Un'indagine psicologica non termina quando il ricercatore ha raccolto molte risposte: termina, sul piano inferenziale, quando sa a quali persone possono essere riferiti i risultati e quali incertezze ne accompagnano l'estensione. Immaginiamo una ricerca sul rapporto tra uso dei social network e benessere degli studenti universitari. Un questionario somministrato volontariamente attraverso un canale molto frequentato può ottenere migliaia di risposte in pochi giorni. Tuttavia, gli studenti che frequentano quel canale, che decidono di rispondere e che completano il questionario possono differire dagli altri proprio per abitudini digitali, carico di studio, condizioni economiche o difficoltà psicologiche. L'ampiezza del campione riduce soltanto alcune componenti dell'errore casuale; non elimina automaticamente l'errore dovuto alla selezione.
La distinzione fondamentale è quella tra popolazione bersaglio, cioè l'insieme di persone o situazioni su cui si desidera formulare una conclusione, e popolazione accessibile, cioè il gruppo da cui la ricerca può effettivamente reclutare partecipanti. Se l'obiettivo riguarda tutti gli universitari italiani, un campione di volontari appartenenti a una sola facoltà di un solo ateneo copre una parte limitata della popolazione di interesse. Questo non rende inutile lo studio: può fornire informazioni sui meccanismi psicologici e suggerire ipotesi. Impedisce però di trasferire senza giustificazione una percentuale osservata alla popolazione nazionale. La qualità dell'inferenza dipende dal rapporto fra quesito, meccanismo di inclusione e variabilità del fenomeno.
Nel campionamento probabilistico ogni unità della popolazione di riferimento ha una probabilità di selezione nota o almeno determinabile in base al disegno. La selezione casuale semplice è il caso più intuitivo, ma non l'unico. Nel campionamento stratificato si dividono le unità in gruppi definiti prima della selezione, per esempio ateneo, fascia d'età o area geografica, e si estrae un campione entro ciascuno strato. Il campionamento a grappoli seleziona invece gruppi naturali, come classi o scuole, osservando successivamente le persone che vi appartengono. Queste scelte hanno conseguenze concrete sui costi, sulla precisione e sulle modalità di analisi; trattare tutti i dati come se provenissero da estrazioni indipendenti può produrre intervalli di confidenza troppo stretti.
Un esempio di ponderazione, con dati interamente ipotetici
Supponiamo di voler stimare la quota di studenti soddisfatti dei servizi di orientamento. Nella popolazione, l'80% studia in sedi urbane e il 20% in sedi periferiche; per ragioni organizzative, nel campione le due categorie rappresentano rispettivamente il 40% e il 60%. Fra i rispondenti urbani il 60% dichiara soddisfazione; fra quelli delle sedi periferiche il 30%. La media grezza del campione è 0,40 × 0,60 + 0,60 × 0,30 = 0,42, cioè il 42%. Se conosciamo le proporzioni della popolazione e assumiamo che, entro ciascuno strato, i rispondenti siano appropriati a rappresentare lo strato, una stima ponderata è 0,80 × 0,60 + 0,20 × 0,30 = 0,54, ossia il 54%. Tutti i valori sono inventati a fini didattici; il calcolo mostra perché una percentuale apparentemente semplice dipende da come il campione è stato costruito.
Tabella 2.5. Esempio di ponderazione stratificata, dati inventati
Sede | Quota popolazione | Quota campione | Soddisfatti |
|---|---|---|---|
Urbana | 80% | 40% | 60% |
Periferica | 20% | 60% | 30% |
Stima grezza | — | 100% | 42% |
Stima ponderata | 100% | — | 54% |
La ponderazione non è una cura universale. Corregge la composizione rispetto alle caratteristiche conosciute e correttamente misurate, ma non può rimediare a differenze sistematiche non osservate. Se, tra gli studenti urbani, rispondono soprattutto coloro che hanno avuto esperienze eccellenti, la stima di quel sottogruppo rimane distorta anche dopo aver ristabilito il peso demografico. Inoltre, pesi molto diseguali possono aumentare la variabilità delle stime: alcuni questionari finiscono per contribuire molto più di altri al risultato. Perciò un rapporto serio dovrebbe descrivere la costruzione dei pesi, i loro estremi, l'eventuale calibrazione e la precisione finale, anziché presentare la ponderazione come una formula che garantisce rappresentatività.
Non risposta e selezione: chi manca dai dati può essere informativo
La non risposta compare quando una persona selezionata non partecipa o omette alcune domande. È importante separare il mancato reclutamento dall'assenza di singoli valori, poiché i due fenomeni richiedono valutazioni differenti. Se chi vive più intensamente una difficoltà psicologica tende a evitare una domanda su quella difficoltà, il meccanismo di omissione può essere collegato alla variabile che si tenta di misurare. Una semplice analisi dei questionari completi può allora fornire una rappresentazione artificialmente rassicurante. Il tasso complessivo di risposta è utile ma insufficiente: servono, quando possibile, confronti fra rispondenti e non rispondenti, analisi di sensibilità e una discussione delle dimensioni non osservabili della selezione.
Nel valutare una ricerca bisogna dunque cercare quattro informazioni distinte: chi poteva entrare nello studio, chi è stato effettivamente contattato, chi ha fornito dati utilizzabili e a chi l'autore vuole estendere la conclusione. La parola «rappresentativo» dovrebbe indicare una proprietà argomentata di un preciso processo di selezione, non un'etichetta attribuita a un campione perché comprende molte persone. Questa cautela torna indispensabile nello studio delle differenze culturali, degli adolescenti, degli anziani e dei gruppi meno facilmente raggiungibili dagli strumenti digitali.
2.14 I dati mancanti: quando l'assenza di una risposta modifica il risultato
Perché non basta eliminare le righe incomplete
I dati mancanti costituiscono una difficoltà specifica perché l'informazione non osservata potrebbe non essere distribuita casualmente. In uno studio sul miglioramento del sonno, per esempio, alcune persone potrebbero non presentarsi alla valutazione finale perché i sintomi sono peggiorati, mentre altre potrebbero abbandonare per motivi di trasporto o per un cambiamento di residenza. Trattare indistintamente queste situazioni e analizzare soltanto chi ha completato tutte le misure può alterare il confronto tra condizioni. Anche quando i gruppi sono stati assegnati casualmente, l'abbandono successivo può compromettere l'equilibrio che la randomizzazione aveva creato all'inizio.
La classificazione tradizionale distingue tre meccanismi. Si parla di MCAR (Missing Completely At Random) quando la probabilità che un valore manchi non dipende né dai dati osservati né dai valori assenti; è un'ipotesi forte. Si parla di MAR (Missing At Random) quando, condizionatamente alle variabili osservate considerate nel modello, l'assenza non dipende dai valori che mancano. Si parla infine di MNAR (Missing Not At Random) quando l'assenza mantiene una dipendenza dal valore non osservato anche dopo aver tenuto conto delle informazioni disponibili. Il nome MAR non significa che l'assenza si presenti in modo del tutto casuale nella vita quotidiana: descrive una condizione statistica relativa a un insieme di variabili osservate.
Il confronto che cambia a seconda di chi abbandona
Consideriamo un esperimento immaginario con 100 partecipanti in ciascun gruppo. Nel gruppo con intervento rimangono 80 partecipanti, che ottengono un punteggio medio finale di 70; nel gruppo di confronto tutti i 100 completano la misura, con media 60. Se si osservano soltanto i dati completi, la differenza è +10 punti. Ma il risultato dell'intervento dipende anche da ciò che sarebbe emerso nei 20 partecipanti mancanti. Se questi ultimi avessero una media di 30, la media complessiva dell'intervento sarebbe (80 × 70 + 20 × 30)/100 = 62, con differenza +2. Se invece i mancanti avessero una media di 90, la media sarebbe 74, con differenza +14. Non sappiamo quale scenario sia vero: la differenza tra scenari quantifica la sensibilità della conclusione ai dati non osservati, non costituisce una stima empirica dei punteggi mancanti.
Tabella 2.6. Sensibilità ai 20 dati mancanti nel gruppo di intervento
Scenario didattico | Media gruppo intervento | Differenza dal controllo (60) |
|---|---|---|
Solo casi completi | 70 | +10 |
Mancanti con media 30 | 62 | +2 |
Mancanti con media 90 | 74 | +14 |
Le tecniche di imputazione multipla costruiscono diversi insiemi plausibili di valori assenti sulla base di modelli espliciti e combinano le analisi, incorporando almeno parte dell'incertezza dovuta all'imputazione. La stima a massima verosimiglianza può utilizzare l'informazione disponibile senza sostituire sempre ogni dato mancante. Nessuna delle due strategie funziona indipendentemente dalle assunzioni: i modelli MAR possono risultare inadeguati quando l'abbandono dipende da informazioni non osservate. Le analisi di sensibilità, che confrontano conclusioni ottenute con ipotesi alternative ragionevoli, sono pertanto una parte sostanziale dell'interpretazione, non un controllo opzionale da omettere quando il risultato piace.
Una pubblicazione trasparente presenta il numero di partecipanti iniziali, la quota di dati disponibili a ogni momento e per ogni misura, le ragioni di mancata osservazione quando note e l'effetto della scelta di trattamento dei dati mancanti. In uno studio randomizzato va chiarito anche quale popolazione definisce la stima: tutti gli assegnati, coloro che hanno seguito l'intervento oppure coloro che lo avrebbero seguito in determinate condizioni. Sono domande diverse. La cosiddetta analisi intention-to-treat, centrata sul gruppo assegnato, ha una particolare importanza per la valutazione di un programma come viene offerto nel mondo reale, ma non elimina da sola il problema dei dati mancanti.
2.15 Ragionare per scenari alternativi: effetti causali, DAG e paradosso di Simpson
Una causa si definisce attraverso un confronto che non possiamo osservare direttamente
Una domanda causale riguarda che cosa cambierebbe se, mantenendo appropriato il confronto, una stessa persona fosse sottoposta oppure no a una certa condizione. Nell'approccio dei risultati potenziali si immagina che ciascuna unità abbia un risultato Y(1) in presenza dell'intervento e un risultato Y(0) in sua assenza. L'effetto individuale sarebbe Y(1) − Y(0), ma nella stessa circostanza osserviamo soltanto uno dei due risultati. La difficoltà fondamentale dell'inferenza causale consiste proprio in questo: il risultato controfattuale, cioè quello relativo all'alternativa non realizzata, non può essere osservato direttamente. La ricerca cerca allora strategie che permettano di stimare confronti medi credibili attraverso gruppi, tempi e assunzioni verificabili per quanto possibile.
In un esperimento randomizzato adeguatamente condotto, l'assegnazione casuale rende, in media e prima dell'intervento, i gruppi comparabili rispetto a variabili misurate e non misurate. La differenza finale fra le medie può quindi stimare un effetto medio dell'assegnazione, a condizione che l'intervento e l'esito siano definiti chiaramente e che non emergano problemi gravi come interferenze tra partecipanti o perdite selettive. Questo vantaggio non garantisce che ogni singolo individuo reagisca nello stesso modo; nemmeno prova che una pratica funzionerà identicamente in qualsiasi altra popolazione.
In uno studio osservazionale, invece, la partecipazione all'intervento può dipendere da motivazione, gravità dei sintomi, risorse economiche o altri fattori che influenzano anche il risultato. Per distinguere relazioni causali plausibili da associazioni spurie, è utile disegnare un grafo aciclico diretto o DAG (Directed Acyclic Graph). Ogni freccia rappresenta un'ipotesi causale; il grafo non è una fotografia del cervello o della realtà, ma un modo per rendere esplicite le assunzioni. Nel DAG una variabile può essere un confondente, se influenza esposizione ed esito, oppure un mediatore, se si colloca sul percorso attraverso il quale l'esposizione produce un effetto. Un collider è invece una variabile influenzata da due cause: condizionarla può creare associazioni artificiali fra quelle cause anche quando prima erano indipendenti.
Un ribaltamento sorprendente: il paradosso di Simpson
Il paradosso di Simpson descrive situazioni in cui una relazione osservata separatamente in più gruppi scompare o si inverte quando i gruppi vengono aggregati. Consideriamo un esempio didattico di due metodi di preparazione a una prova. Fra le persone che affrontano una prova facile, il metodo A porta al successo 80 studenti su 90 (88,9%), mentre il metodo B porta al successo tutti e 10 i partecipanti (100%). Fra chi affronta una prova difficile, A porta al successo 1 studente su 10 (10%), contro 18 su 90 (20%) con B. In entrambi i livelli di difficoltà, il metodo B presenta la percentuale più elevata. Sommando senza distinguere la difficoltà, però, A conta 81 successi su 100 e B ne conta 28 su 100: l'apparente classifica complessiva si rovescia. I numeri sono inventati e volutamente estremi per rendere visibile il meccanismo.
Tabella 2.7. Il ribaltamento delle percentuali, dati inventati
Difficoltà | Metodo A | Metodo B | Confronto |
|---|---|---|---|
Facile | 80/90 = 88,9% | 10/10 = 100% | B maggiore |
Difficile | 1/10 = 10% | 18/90 = 20% | B maggiore |
Tutte insieme | 81/100 = 81% | 28/100 = 28% | A maggiore |
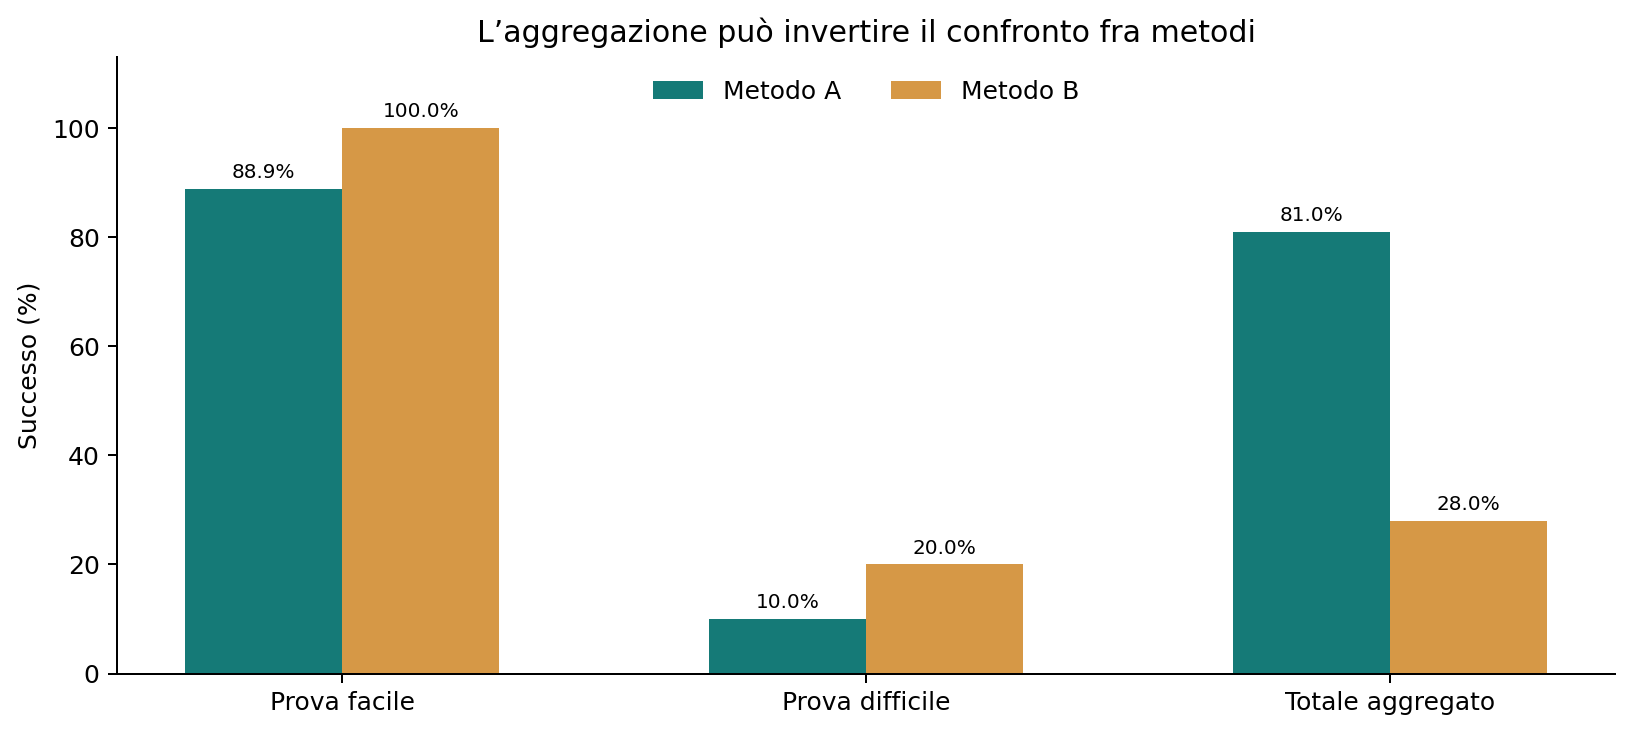
Non esiste una regola secondo la quale sia sempre corretta la tabella aggregata o sempre corretto il confronto stratificato. La scelta dipende dall'obiettivo causale, dal modo in cui i partecipanti sono stati assegnati, dalle relazioni fra livello di difficoltà, intervento ed esito e dall'effetto che si intende stimare. Se, come in questo esempio, il metodo A è stato scelto soprattutto per le prove facili, il confronto aggregato combina l'effetto del metodo con la differente composizione dei gruppi. Correggere per la difficoltà può aiutare a isolare l'effetto del metodo, ma l'interpretazione dipende ancora da altre possibili variabili confondenti e dalle ipotesi del disegno.
Anche l'idea di «controllare per tutto» è fallace. Inserire molte covariate in una regressione senza un modello causale può introdurre distorsioni, soprattutto quando si controlla un mediatore o si condiziona su una variabile di selezione che agisce come collider. Perciò la lista delle variabili da controllare dovrebbe essere motivata da conoscenze preliminari, dalla sequenza temporale e da un modello esplicito, non scelta soltanto in base alle correlazioni statisticamente più elevate. I diagrammi causali aiutano a discutere criticamente le assunzioni, ma non le dimostrano.
2.16 Quando randomizzare non è possibile: esperimenti naturali e disegni quasi-sperimentali
Osservare una riforma non equivale a osservarne l'effetto
Molte domande psicologiche riguardano scuole, ospedali, famiglie, piattaforme digitali o organizzazioni in cui un'assegnazione casuale non è praticabile, non è etica oppure è ostacolata da decisioni amministrative. La psicologia dell'educazione potrebbe voler conoscere gli effetti di una nuova organizzazione dell'orario scolastico; la psicologia del lavoro potrebbe studiare una politica di flessibilità. Se i risultati migliorano dopo l'introduzione della misura, l'aumento potrebbe dipendere dalla politica, ma anche da cambiamenti economici, dalla composizione degli utenti, dalla stagione o dalla maturazione naturale. Il confronto prima-dopo, senza ulteriori controlli, raramente separa queste spiegazioni.
Un disegno quasi-sperimentale utilizza una fonte di variazione che non è stata prodotta da un'assegnazione casuale controllata dai ricercatori, ma che può fornire informazioni causali sotto specifiche assunzioni. L'espressione non identifica un'unica procedura: comprende, fra gli altri, confronti con gruppi non equivalenti, serie temporali interrotte, regressioni discontinue e differenze nelle differenze. Questi metodi non sono automaticamente inferiori o superiori agli esperimenti; rispondono a domande diverse e richiedono controlli diversi. Il punto è riconoscere che la credibilità deriva dal disegno e dalle assunzioni più che dal nome della tecnica statistica.
Differenze nelle differenze: sottrarre un cambiamento comune
Nelle differenze nelle differenze (difference-in-differences, DiD) si confronta la variazione prima-dopo di un gruppo esposto a una politica con la variazione nello stesso periodo di un gruppo di confronto. Immaginiamo dati inventati sul benessere medio in due facoltà: nella prima viene introdotto un servizio di tutorato e il punteggio passa da 40 a 55; nella facoltà senza nuovo servizio passa da 42 a 47. La variazione osservata è +15 nel primo gruppo e +5 nel secondo. La stima DiD è quindi (55 − 40) − (47 − 42) = +10 punti. I cinque punti di crescita osservati nella facoltà di confronto vengono trattati come un'approssimazione di quanto sarebbe cambiato, in assenza del servizio, anche il primo gruppo.
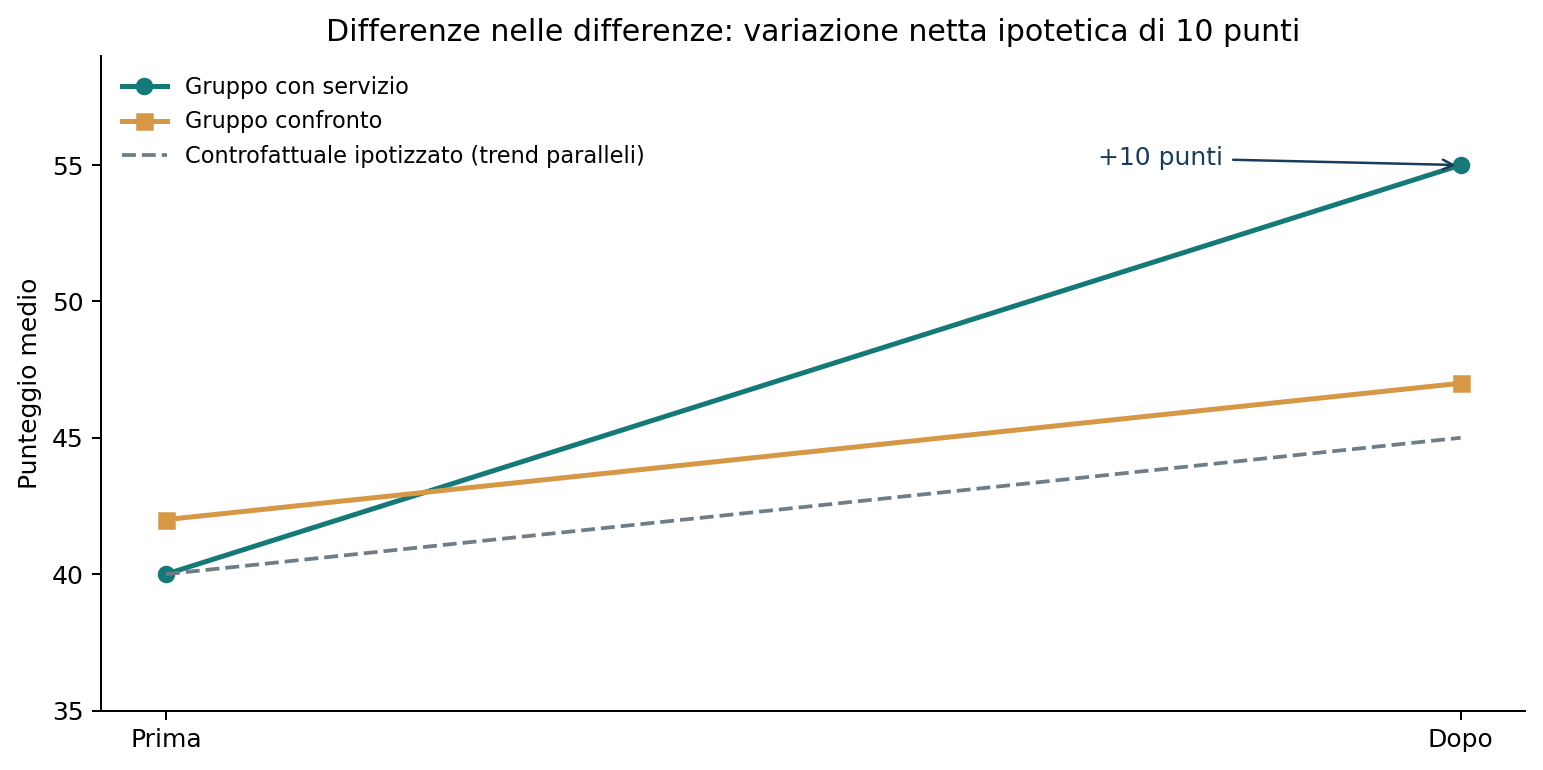
La validità di questa interpretazione richiede un'ipotesi cruciale: in assenza del trattamento, i due gruppi avrebbero seguito andamenti paralleli in media. È l'assunzione dei trend paralleli. Osservare andamenti simili prima dell'intervento può aumentare la credibilità, ma non provarla definitivamente. La stima può essere distorta se nello stesso periodo si verifica uno shock specifico per una facoltà o se cambia la sua composizione in modo rilevante. Nel caso di adozione dell'intervento in tempi diversi tra molti gruppi, occorrono ulteriori cautele: alcuni stimatori tradizionali possono produrre confronti poco intuitivi quando gli effetti variano nel tempo o fra gruppi.
Regressione discontinua e soglie decisionali
Nel disegno di regressione discontinua, l'accesso a un intervento cambia in corrispondenza di una soglia osservabile, come un punteggio di ingresso. Se un programma di sostegno viene offerto soltanto a chi ottiene meno di 50 punti in un test iniziale, il ricercatore può confrontare gli esiti di persone immediatamente sotto e sopra la soglia, a condizione che le altre caratteristiche potenziali cambino in modo sufficientemente regolare. L'idea è che chi ha 49 e chi ha 51 punti possa essere più simile di chi ha 20 e chi ha 90; una discontinuità nei risultati in prossimità della soglia potrebbe essere attribuita, con le dovute assunzioni, al programma.
L'effetto stimato è in genere locale: riguarda persone vicine alla soglia, non necessariamente tutti i destinatari possibili dell'intervento. La strategia diventa fragile quando il punteggio può essere manipolato per entrare nel programma oppure quando altre regole cambiano nello stesso punto. È necessario verificare la plausibilità della continuità, esaminare la distribuzione dei punteggi attorno alla soglia e valutare la robustezza alle scelte della finestra di confronto. Una semplice curva che cambia vicino a 50 non basta a dimostrare l'effetto.
Serie temporali interrotte e minacce contemporanee
Una serie temporale interrotta osserva ripetutamente lo stesso esito prima e dopo una modifica, per valutare se il livello o la pendenza del fenomeno cambino rispetto alla traiettoria precedente. Può essere utile per analizzare chiamate ai servizi di supporto psicologico, assenze scolastiche o indicatori del sonno raccolti frequentemente. Ma il modello deve tener conto di stagionalità, autocorrelazione e modifiche concomitanti: due osservazioni prima e due dopo l'intervento non danno la stessa base di valutazione di una serie stabile di molti mesi. Se in coincidenza della politica si verifica un evento imprevisto che influenza l'esito, attribuire tutto il cambiamento alla politica sarebbe erroneo.
Tabella 2.8. Disegni senza randomizzazione controllata
Disegno | Informazione sfruttata | Assunzione cruciale |
|---|---|---|
Differenze nelle differenze | Mutamenti di gruppi nel tempo | Trend paralleli controfattuali |
Regressione discontinua | Cambiamento dell’accesso alla soglia | Continuità potenziale vicino alla soglia |
Serie temporale interrotta | Cambio di livello o pendenza | Assenza di shock contemporanei non controllati |
2.17 Analisi dei dati con più variabili: regressione, interazioni e interpretazione dei coefficienti
La regressione non è una macchina che genera cause
Quando più variabili sono associate a un esito, la regressione fornisce un modo sistematico per descrivere le loro relazioni e stimare differenze condizionate. Una regressione lineare può essere scritta, in forma semplice, come Y = b0 + b1 X + errore, dove Y è l'esito, X un predittore, b0 l'intercetta e b1 la variazione media prevista di Y per un aumento unitario di X, secondo il modello. Se un punteggio di attenzione aumenta in media di due unità per ogni ora di sonno in più, non significa automaticamente che costringere una persona a dormire un'ora aggiuntiva provochi un miglioramento di due punti: l'associazione potrebbe riflettere altre differenze fra le persone osservate.
Aggiungere un secondo predittore consente di confrontare persone simili rispetto a quella variabile, secondo la specificazione scelta. In un modello Y = b0 + b1 X + b2 Z + errore, il coefficiente b1 descrive l'associazione fra X e Y a parità di Z all'interno del modello. La formulazione non ha un contenuto causale intrinseco. È essenziale verificare la scala dell'esito, la forma delle relazioni, la presenza di osservazioni influenti e il rischio di estrapolare oltre l'intervallo in cui sono stati raccolti i dati. Non basta scegliere un modello perché produce il più alto coefficiente di determinazione R².
Il coefficiente di determinazione R² esprime, nell'ordinario modello lineare con intercetta stimato sul campione, la quota della variabilità osservata di Y associata alla riduzione della somma dei quadrati degli errori rispetto alla previsione della media. Un R² elevato non implica che il modello descriva il meccanismo psicologico vero, né assicura buone previsioni in nuovi campioni. Un modello può adattarsi molto bene a dati già visti, per poi fallire quando cambiano scuola, popolazione o periodo storico. Questo fenomeno è chiamato overfitting, o sovraadattamento: il modello cattura particolarità del campione insieme alla struttura utile.
Interazioni: un effetto non deve essere uguale per tutti
Le interazioni permettono di esprimere l'ipotesi che l'associazione tra una variabile e l'esito cambi in funzione di un'altra variabile. Immaginiamo una sperimentazione didattica interamente ipotetica in cui si confrontano due modalità di insegnamento e due condizioni di preparazione iniziale. Fra studenti con preparazione A, il punteggio medio passa da 55 nel controllo a 70 dopo l'intervento: +15. Fra studenti con preparazione B passa da 62 a 64: +2. L'interazione su scala additiva è +15 − (+2) = +13 punti. Dire soltanto che «il metodo migliora il rendimento» nasconderebbe la differenza fra sottogruppi; dire che «funziona solo per A» sarebbe però eccessivo, perché +2 potrebbe ancora essere un effetto reale e l'incertezza delle stime non è stata specificata.
Tabella 2.9. Interazione additiva, valori didattici
Preparazione | Controllo | Intervento | Differenza |
|---|---|---|---|
A | 55 | 70 | +15 |
B | 62 | 64 | +2 |
Differenza degli effetti | — | — | +13 |
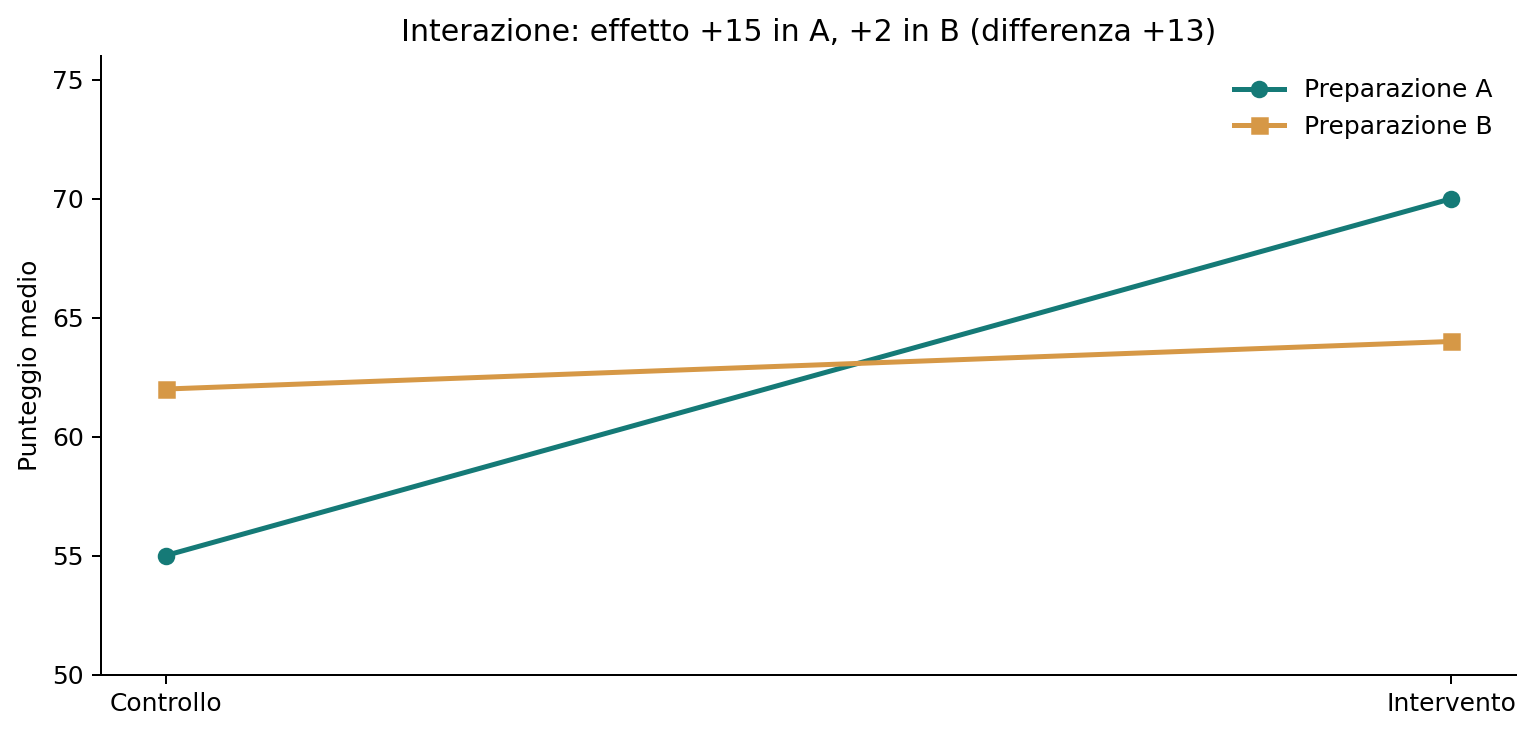
L'interpretazione dell'interazione dipende dalla scala scelta. Una differenza costante in punti non coincide necessariamente con una differenza costante in percentuale, e una interazione su una scala trasformata può non corrispondere a un'interazione sulla scala originale. Il problema è particolarmente importante quando l'esito è binario, come successo/insuccesso. La regressione logistica modella il logaritmo del rapporto fra probabilità dell'evento e probabilità del suo complemento, detto log-odds. Gli esponenziali dei coefficienti descrivono rapporti di odds, non differenze dirette nelle probabilità; interpretare un odds ratio pari a due come «probabilità doppia» può essere fuorviante, soprattutto quando l'evento non è raro.
Un esercizio di probabilità condizionata
Supponiamo che un questionario di screening, in un campione ipotetico di 1.000 persone, riguardi una condizione presente nel 10% dei casi. Il test individua l'80% di chi presenta la condizione (sensibilità) e classifica correttamente come non casi il 90% di chi non la presenta (specificità). Su 100 casi attesi, 80 risultano positivi; su 900 non casi, il 10% produce un falso positivo, cioè 90 persone. Pertanto, fra i 170 positivi totali, la quota con condizione presente è 80/170 ≈ 47,1%. Questo è il valore predittivo positivo, nel contesto di quella prevalenza ipotizzata. Il calcolo ricorda che sensibilità e specificità, pur essendo proprietà utili del test in determinate condizioni, non bastano a interpretare il risultato individuale senza considerare quanto è frequente la condizione nella popolazione esaminata.
Un test di screening non coincide con una diagnosi, e un risultato positivo non implica automaticamente che la persona presenti un disturbo. Nella ricerca psicologica i questionari vengono talvolta trasformati impropriamente in etichette cliniche; il rischio aumenta quando si ignora il margine d'errore e quando si applicano soglie elaborate per un contesto a popolazioni diverse. I modelli predittivi devono essere valutati su dati nuovi, con attenzione a calibrazione (corrispondenza fra probabilità previste e frequenze osservate), capacità discriminativa e conseguenze pratiche dei falsi positivi e falsi negativi.
2.18 Dati gerarchici e misure ripetute: la dipendenza fra osservazioni
La stessa persona misurata quattro volte non è quattro persone
Una parte importante degli studi psicologici comprende osservazioni che non sono indipendenti: lo stesso individuo risponde più volte, più studenti appartengono alla medesima classe o più lavoratori condividono lo stesso ambiente organizzativo. Questa struttura viene detta gerarchica, annidata o multilivello, a seconda del disegno. Se dieci persone rispondono ogni giorno per trenta giorni, le 300 registrazioni non equivalgono a 300 soggetti diversi. Le risposte appartenenti alla stessa persona condividono caratteristiche stabili, abitudini e contesti che rendono plausibile una correlazione interna. Trattarle come indipendenti può rendere apparentemente precise stime che in realtà si fondano su un numero molto inferiore di unità autonome.
Nei modelli a effetti misti si distinguono, in una formulazione comune, una componente descritta da parametri condivisi e una componente che rappresenta variazioni fra persone o gruppi. Per esempio, è possibile studiare se l'umore medio cambi con le ore di sonno e contemporaneamente riconoscere che alcune persone partono da livelli di umore abitualmente diversi. Un'intercetta casuale consente a ogni persona di avere un proprio livello di base; una pendenza casuale consente, quando giustificato dai dati e dal modello, di descrivere quanto la relazione con il sonno differisca fra persone. Il modello resta dipendente da assunzioni e qualità della misura: una struttura più sofisticata non cancella il confondimento o gli errori di selezione.
Correlazione intraclasse e numerosità effettiva
La correlazione intraclasse, spesso indicata con ICC, descrive in specifici modelli quanto della variabilità totale sia attribuibile a differenze fra gruppi. Immaginiamo, a puro scopo didattico, una varianza fra scuole pari a 20 e una varianza residua entro scuole pari a 80. L'ICC è 20/(20 + 80) = 0,20. Con classi di 20 studenti e una struttura semplificata in cui la correlazione entro classe sia costante, un'approssimazione del design effect è 1 + (20 − 1) × 0,20 = 4,8. In termini di precisione per una stima media in questo modello semplificato, 400 osservazioni raggruppate possono corrispondere a un numero effettivo approssimativo di 400/4,8 ≈ 83 osservazioni indipendenti. È un'illustrazione, non una formula universalmente valida per ogni coefficiente o modello multilivello.
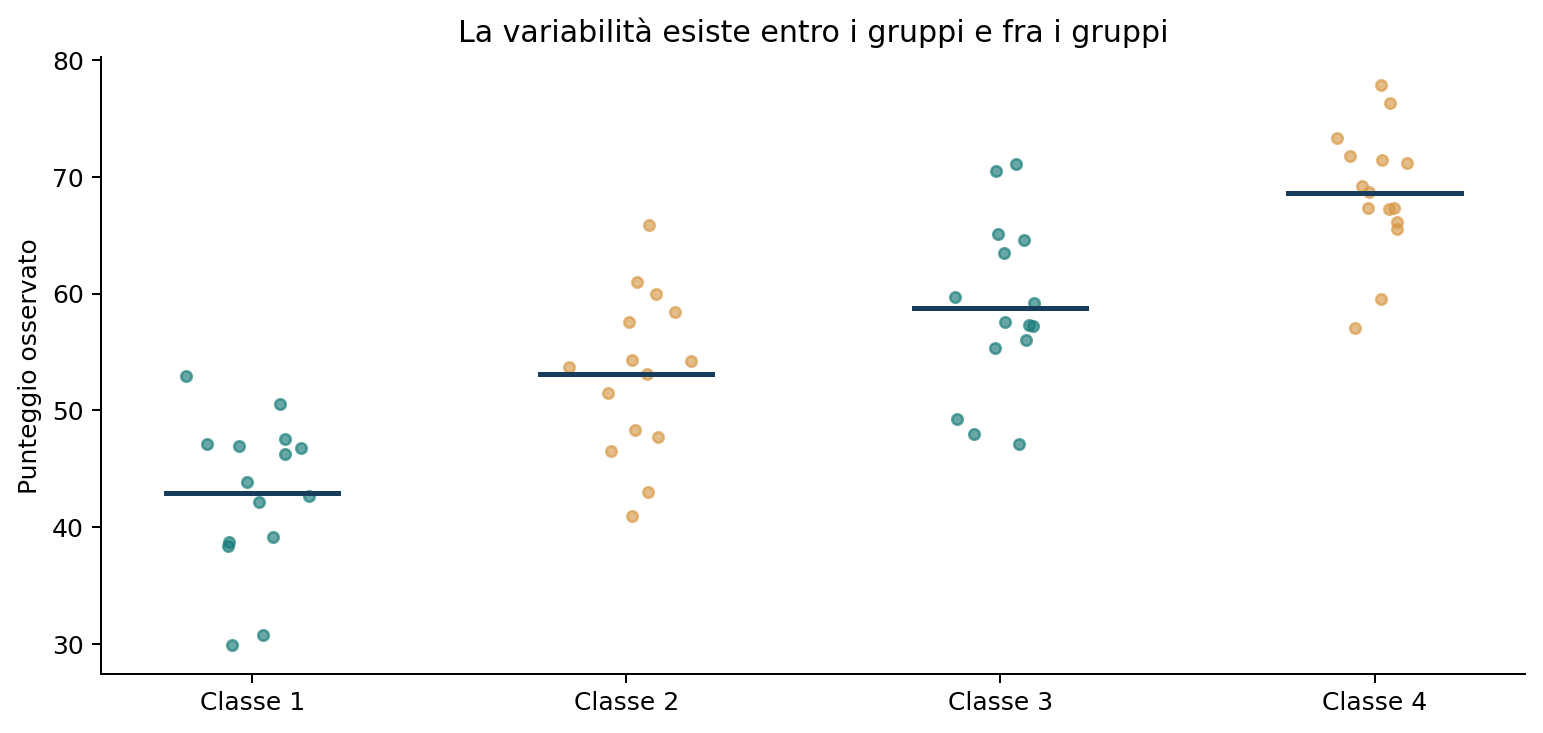
Le analisi longitudinali devono inoltre distinguere cambiamento individuale e differenze fra persone. Se gli studenti che dormono di più ottengono mediamente punteggi migliori, ciò non dimostra che lo stesso studente migliorerà il proprio punteggio ogni volta che dorme un'ora in più. Le due relazioni possono avere intensità o persino direzioni diverse. Per studiarle bisogna separare opportunamente le medie individuali dalle oscillazioni rispetto alla media della stessa persona. Questa distinzione è essenziale nelle ricerche sul benessere, sulle emozioni, sulle abitudini digitali e sulla psicologia dello sviluppo.
La presenza di misure ripetute apre anche questioni temporali: il valore di un giorno può influenzare quello successivo, gli effetti possono essere ritardati e alcuni eventi possono cambiare la traiettoria per periodi brevi o lunghi. Modelli autoregressivi e serie temporali sono strumenti per rappresentare queste dipendenze, ma i loro coefficienti non diventano automaticamente causali. La direzione del tempo aiuta a escludere alcune spiegazioni, ma non tutte le cause comuni o le variabili omesse.
2.19 Dimensioni dell'effetto, incertezza e decisioni: oltre la soglia di significatività
Da «esiste una differenza?» a «quanto è grande e per chi conta?»
In molte pubblicazioni l'attenzione si concentra sulla presenza o assenza di un valore p inferiore a una soglia convenzionale. Questo approccio trascura due domande scientificamente distinte: quanto è grande l'effetto stimato e con quale precisione è stato misurato? Una differenza di due punti in un test può essere rilevante in un contesto e trascurabile in un altro. Le dimensioni dell'effetto servono a quantificare un fenomeno sulla scala originale, come una differenza media o una variazione percentuale, oppure su una scala standardizzata, utile in certi confronti fra misure. Le unità originali restano spesso le più comprensibili per valutare conseguenze pratiche.
Consideriamo un esempio ipotetico: il gruppo A mostra in media 72 punti, il gruppo B 68, con deviazione standard combinata di 10. La differenza grezza è 4 punti. Una misura standardizzata approssimativa è d = 4/10 = 0,40, assumendo appropriato il modello di riferimento e il denominatore utilizzato. Questo numero non significa che il 40% delle persone benefici dell'intervento, né dice quale sia la probabilità che l'effetto sia presente in un nuovo studio. Per valutare il risultato occorrono l'intervallo di incertezza, la qualità delle misure, il disegno di ricerca e il significato concreto di quattro punti nel contesto osservato.
La precisione non cresce senza limiti interpretativi
In campioni molto grandi, anche differenze minuscole possono produrre valori p piccoli; in campioni ridotti, effetti importanti possono essere stimati con intervalli troppo ampi per sostenere conclusioni nette. La potenza statistica è funzione della numerosità, della variabilità, della vera grandezza dell'effetto considerato e della procedura scelta; non è un certificato di verità del risultato ottenuto. Dichiarare dopo l'analisi una potenza calcolata sostituendo l'effetto osservato può essere scarsamente informativo. È più utile discutere che cosa l'intervallo di confidenza consenta o non consenta di escludere.
La soglia di importanza pratica dovrebbe essere motivata prima di osservare i risultati, quando possibile. Supponiamo che una differenza di almeno cinque punti sia considerata rilevante per un intervento didattico. Una stima di +4 punti con intervallo dal −1 a +9 non supporta una conclusione netta né di efficacia né di irrilevanza: contiene sia effetti sfavorevoli sia benefici clinicamente o educativamente rilevanti, secondo la soglia adottata. Una stima di +0,5 con intervallo da −0,5 a +1,5 può invece essere sufficientemente precisa da escludere effetti grandi, pur non essendo una prova di effetto esattamente nullo. La equivalenza richiede un ragionamento statistico specifico e margini dichiarati, non la sola assenza di significatività.
Analisi multiple e risultati selezionati
Se si effettuano venti test indipendenti, tutti riferiti a ipotesi nulle vere e ciascuno con probabilità di falso positivo pari al 5%, la probabilità di trovare almeno un falso positivo è 1 − 0,95^20 ≈ 64,2%. È un'illustrazione matematica basata sull'indipendenza e non descrive automaticamente qualunque insieme di analisi reali. Quando le variabili sono correlate, la probabilità complessiva cambia. Rimane tuttavia chiaro il problema delle analisi multiple: selezionare il risultato più interessante fra molti tentativi, senza segnalarli, aumenta il rischio di trarre conclusioni eccessive.
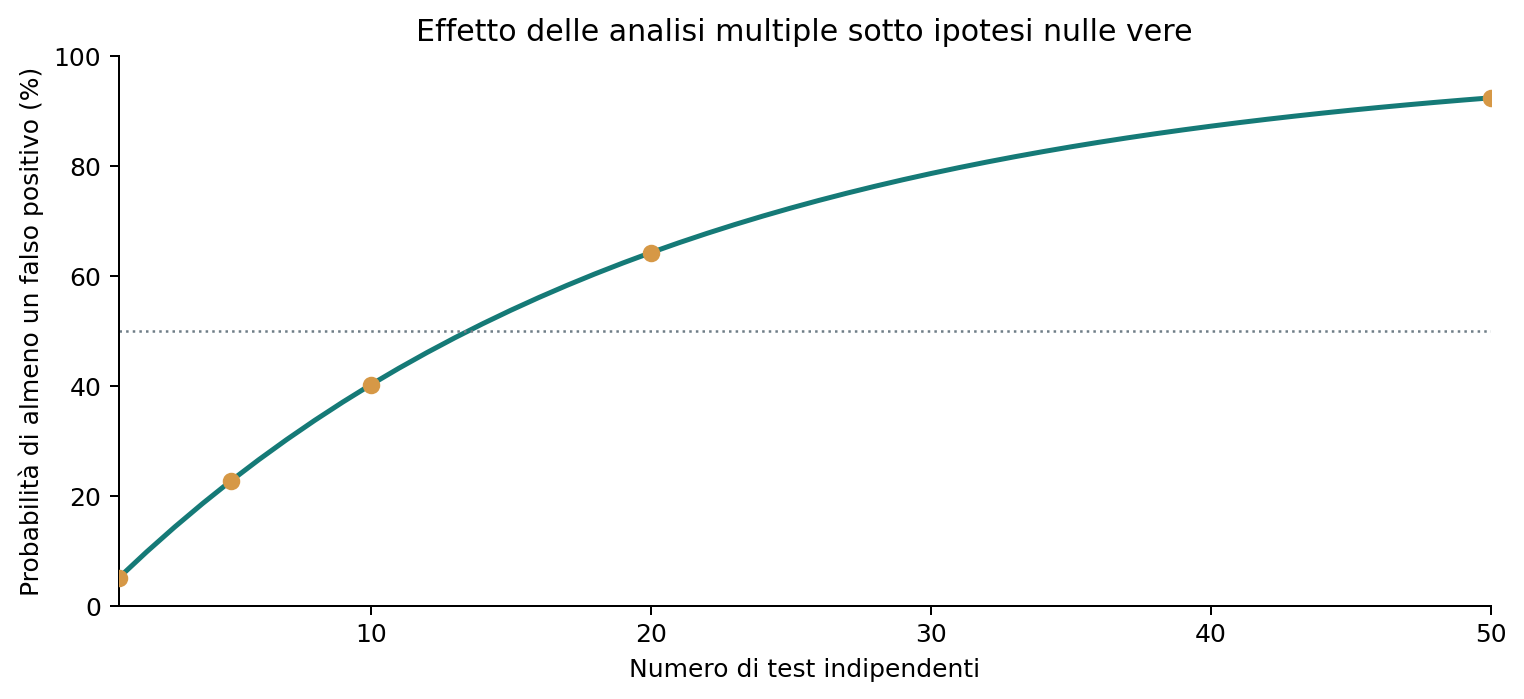
Le procedure che controllano la family-wise error rate mirano a limitare la probabilità di almeno un errore di primo tipo in una famiglia definita di test. Il controllo del false discovery rate affronta un altro obiettivo: la proporzione attesa di falsi positivi fra i risultati dichiarati significativi, in determinate condizioni. Nessuna correzione statistica sostituisce la formulazione di ipotesi primarie, un piano analitico trasparente e la pubblicazione dei risultati non selezionati. Inoltre, test multipli legittimi in una ricerca esplorativa non diventano scorretti per definizione: diventano problematici quando vengono presentati retroattivamente come conferme indipendenti previste fin dall'inizio.
2.20 Dal singolo studio all'insieme delle prove: meta-analisi ed eterogeneità
Perché una media delle medie può essere ingannevole
Una revisione sistematica cerca, seleziona e valuta in modo tracciabile le ricerche pertinenti a un quesito. Quando i risultati sono sufficientemente comparabili, una meta-analisi può combinarne quantitativamente le stime. Il vantaggio non è soltanto produrre un numero complessivo: è rendere visibili la precisione, la variabilità dei risultati, le differenze fra contesti e i limiti delle prove. Una media ingenua degli effetti, senza pesi appropriati e senza considerare qualità metodologica, caratteristiche dei partecipanti e differenze fra interventi, può essere fuorviante.
Una meta-analisi a effetti comuni, in un modello tipico, assume che tutti gli studi mirino allo stesso effetto sottostante, mentre le loro stime differiscono per errore di campionamento. Un modello a effetti casuali consente invece che gli effetti veri degli studi varino secondo una distribuzione descritta dal modello. Quest'ultimo non risolve automaticamente problemi di comparabilità o selezione degli studi; può perfino fornire una stima molto incerta quando gli studi sono pochi o molto diversi. La scelta deve essere giustificata dal quesito e dalla struttura delle evidenze.
Un forest plot, o diagramma a foresta, presenta di norma le stime individuali e i rispettivi intervalli, permettendo di confrontare direzioni e precisione. Il lettore deve notare se gli studi si concentrano su interventi equivalenti, se gli esiti sono misurati allo stesso modo e se uno o due studi particolarmente grandi dominano la sintesi. La quantità I² viene spesso utilizzata per descrivere la quota stimata di variabilità fra risultati che non è attribuita al solo errore campionario, ma non identifica le cause dell'eterogeneità e può essere interpretata male quando è considerata senza l'incertezza e senza il contesto.
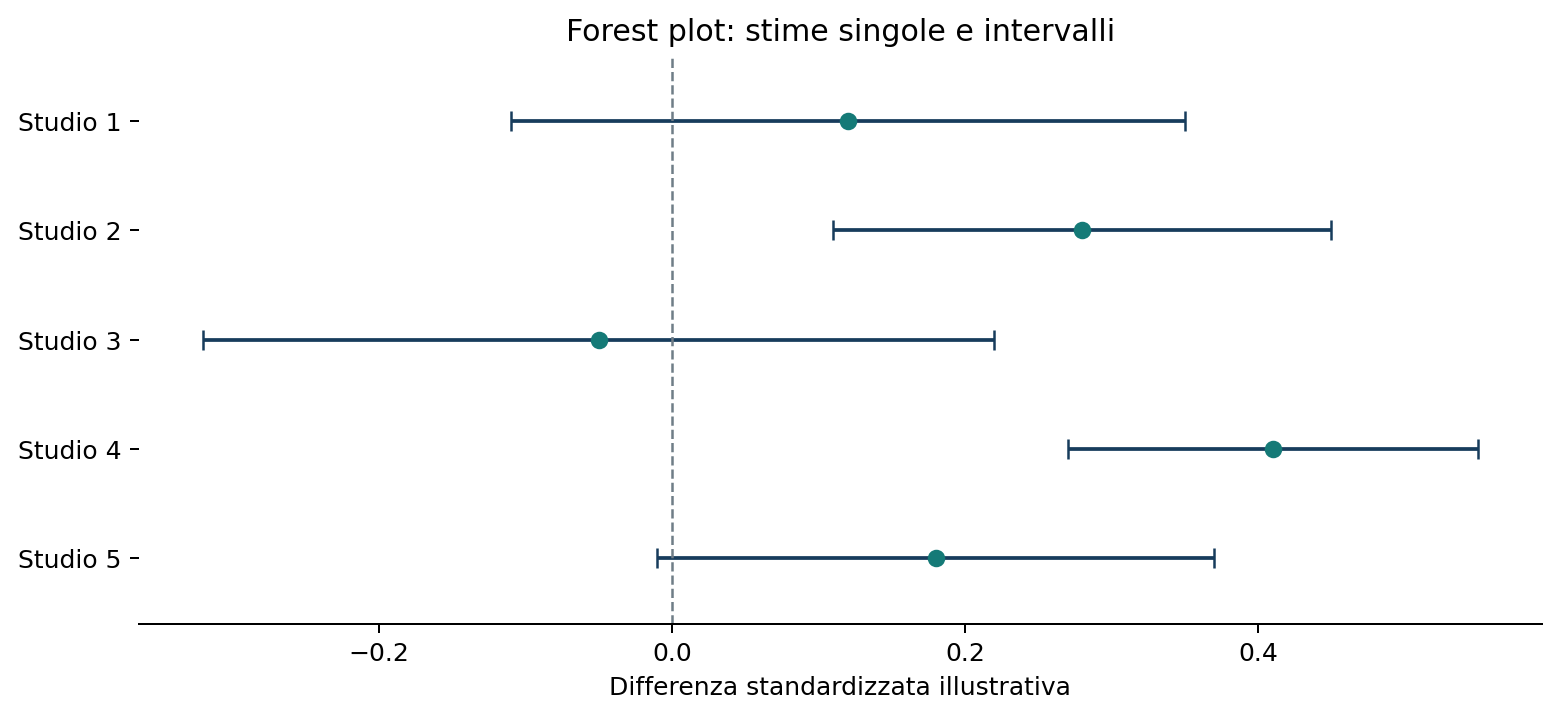
Studi non pubblicati, esiti selezionati e rischio di distorsione
Se gli studi con risultati apparentemente favorevoli hanno maggiori probabilità di comparire in una rivista o se gli autori riportano soltanto alcune misure, la letteratura disponibile può sovrastimare il beneficio. Un funnel plot può suggerire asimmetrie compatibili con effetti dei piccoli studi o distorsioni di pubblicazione, ma non consente da solo di stabilirne la causa. Esistono altre spiegazioni, per esempio differenze reali fra campioni, metodi o contesti. Le registrazioni preventive, la ricerca di studi non pubblicati e il confronto fra protocolli e risultati aiutano a valutare il problema, pur senza garantire il recupero di tutta l'informazione assente.
Una buona sintesi scientifica distingue la valutazione del rischio di bias dei singoli studi dalla misurazione della mera precisione statistica: uno studio può produrre una stima numericamente precisa ma sistematicamente distorta. Non è quindi sensato trattare l'intervallo più stretto come prova automaticamente più affidabile. Inoltre, il numero di articoli non equivale al numero di studi indipendenti: più pubblicazioni possono utilizzare la stessa coorte o gli stessi dati, e contarle separatamente gonfierebbe il peso attribuito a una fonte di informazioni.
Le raccomandazioni metodologiche per rendere chiari gli studi includono linee guida di rendicontazione differenti a seconda del disegno. Gli studi osservazionali possono essere documentati secondo STROBE; gli esperimenti randomizzati seguono indicazioni di reporting come CONSORT; le revisioni sistematiche utilizzano PRISMA; nella psicologia sono particolarmente rilevanti anche gli standard APA JARS. Questi strumenti guidano la completezza della descrizione, ma non certificano da soli l'assenza di errori o di bias. Una ricerca molto ben descritta può essere metodologicamente debole; viceversa, una ricerca condotta con attenzione ma raccontata in modo incompleto impedisce al lettore di valutarla correttamente.
2.21 Dalla spiegazione alla previsione: modelli predittivi, validazione e responsabilità
Le previsioni riuscite su dati già visti valgono poco
La ricerca psicologica formula sia domande esplicative sia domande predittive. Una teoria esplicativa cerca di chiarire i meccanismi che producono un fenomeno; un modello predittivo mira ad anticipare l'esito di nuove osservazioni. Una variabile può essere utile per prevedere un comportamento senza causarlo. Per esempio, un indice di accesso ai servizi può anticipare alcuni esiti scolastici, ma modificarlo artificialmente non comporta necessariamente il cambiamento previsto dal modello: potrebbe funzionare come indicatore di un insieme più ampio di condizioni sociali. Confondere predizione e causa può portare a interventi inefficaci o ingiusti.
Se si addestra un modello e poi lo si valuta sugli stessi dati, la stima della prestazione risulta generalmente ottimistica. Per questo si utilizza un insieme di dati di addestramento e uno di test, separati prima dell'analisi quando possibile, oppure forme appropriate di validazione incrociata. Nel caso di persone misurate più volte, tutte le osservazioni della stessa persona devono spesso rimanere nello stesso insieme per evitare che il modello utilizzi indirettamente informazione già vista. Nei dati temporali, la validazione dovrebbe rispettare l'ordine cronologico: prevedere il futuro usando informazioni che saranno disponibili soltanto dopo il momento della previsione costituirebbe una fuga di informazioni, o data leakage.
Una classificazione che indovina il 90% dei casi può essere inutilizzabile quando l'evento che interessa è raro. Se soltanto il 5% dei partecipanti presenta un esito, un sistema che dichiara sempre «assenza dell'esito» raggiunge comunque il 95% di accuratezza. La valutazione richiede quindi misure più informative: sensibilità, specificità, valore predittivo, precisione delle probabilità e analisi delle conseguenze degli errori. Il valore appropriato di ciascuna misura dipende dal contesto: sbagliare una raccomandazione su un contenuto didattico non ha le stesse conseguenze di sbagliare una valutazione che limita l'accesso a servizi di assistenza.
Differenze fra gruppi e problemi etici della classificazione automatica
Un algoritmo di previsione può funzionare in maniera diversa fra gruppi per ragioni legate a raccolta dei dati, caratteristiche delle misure, rappresentazione dei partecipanti e strutture sociali. Non basta eliminare da un dataset una variabile sensibile per escludere disparità: altri predittori possono esservi associati. Inoltre, criteri differenti di equità predittiva non sono sempre soddisfacibili simultaneamente quando i tassi di base e gli errori variano. La valutazione deve dunque essere condotta rispetto a finalità specifiche, coinvolgere competenze disciplinari e considerare le conseguenze sociali della classificazione.
Quando la psicologia utilizza sistemi di intelligenza artificiale, è utile separare almeno tre domande: il modello prevede bene su nuove persone? La sua previsione mantiene validità quando cambiano ambiente e periodo? È appropriato utilizzare quella previsione per prendere decisioni su individui? Rispondere positivamente alla prima domanda non risolve le altre due. Per applicazioni sensibili sono essenziali trasparenza, supervisione umana, protezione dei dati e possibilità di contestare valutazioni errate. Le prestazioni di laboratorio non devono essere presentate come garanzia di affidabilità clinica o educativa.
2.22 Laboratorio di lettura critica: un articolo, sei livelli di verifica
Separare il titolo giornalistico dalle informazioni necessarie
Immaginiamo di leggere un titolo secondo cui «Dieci minuti di esercizio al giorno aumentano la memoria del 30%». La reazione spontanea è chiedersi se l'affermazione sia vera. Il metodo scientifico invita a formulare prima una serie di domande più specifiche. Qual è la memoria misurata: un test di riconoscimento di parole, la memoria di lavoro o il ricordo di un episodio reale? Che cosa significa «30%»: aumento relativo rispetto a un punto di partenza, differenza su una scala arbitraria o percentuale di persone che migliorano? La misura è stata presa subito dopo l'esercizio oppure settimane più tardi? L'intervento è stato confrontato con il riposo, con un'attività sociale o con un'altra forma di movimento? Una singola cifra può descrivere realtà profondamente diverse.
Nel primo livello bisogna identificare la domanda di ricerca e l'esito principale. Se lo studio comprende dieci prove cognitive, è utile sapere quale fosse il risultato primario stabilito prima della raccolta dei dati. Nel secondo livello si valuta il disegno: assegnazione casuale, osservazione o confronto naturale. Nel terzo si controllano campionamento e perdite: la ricerca riguarda venti giovani volontari, centinaia di adulti o persone con caratteristiche cliniche particolari? Nel quarto si esaminano numeri e incertezza, non soltanto la direzione della stima: differenza media, intervalli, variabilità e dimensione dell'effetto. Nel quinto si cercano analisi alternative ragionevoli e limiti riconosciuti. Nel sesto si chiede se esistano repliche indipendenti e sintesi coerenti.
Per esercitarci, immaginiamo uno studio didattico nel quale un gruppo con attività fisica ottiene 26 parole ricordate su 40, mentre il confronto ne ricorda 24. La differenza assoluta è 2 parole. L'incremento relativo rispetto alla media del confronto è (26 − 24)/24 ≈ 8,3%, mentre rispetto al massimo teorico della scala è 2/40 = 5 punti percentuali della prestazione massima. Nessuna di queste espressioni equivale a «memoria aumentata del 30%». Mancano inoltre informazioni su dispersione, campione e qualità del disegno. L'esempio mostra che la stessa osservazione può essere descritta in modi diversi senza che i modi siano intercambiabili.
L'etica come parte della qualità del dato
È possibile condurre uno studio formalmente ben disegnato e ottenere comunque informazioni poco affidabili se le persone non si sentono libere di rispondere o non comprendono il consenso richiesto. Nelle ricerche con minori, persone vulnerabili o dati potenzialmente stigmatizzanti, la protezione non riguarda soltanto l'anonimizzazione finale. Comprende la proporzionalità delle informazioni raccolte, la comprensibilità del consenso, la possibilità di rifiuto senza conseguenze indebite e la sicurezza nel trattamento dei dati. Quando sono coinvolti animali, la giustificazione scientifica, la minimizzazione della sofferenza e la ricerca di alternative adeguate costituiscono condizioni essenziali della valutazione etica.
Un altro problema riguarda la privacy inferenziale. Persino dati privati di identificatori diretti possono consentire il riconoscimento di una persona quando sono combinati con informazioni esterne, specialmente nei piccoli sottogruppi. La condivisione responsabile può quindi richiedere accessi controllati, dati sintetici, codici di analisi e descrizioni sufficienti per la verifica senza esporre informazioni sensibili. Aprire indiscriminatamente un archivio non è sinonimo di trasparenza scientifica. La trasparenza richiede che le scelte metodologiche siano ricostruibili entro limiti compatibili con diritti e sicurezza dei partecipanti.
La buona conclusione di un articolo scientifico non è una formula retorica di certezza: è una risposta condizionata al quesito iniziale, alle prove raccolte, alle assunzioni utilizzate e alle alternative ancora plausibili. In psicologia, dove i fenomeni dipendono da persone, contesti e tempi diversi, la cautela non è un segno di debolezza della disciplina. È la condizione che consente di migliorare le spiegazioni senza trasformare risultati locali in verità universali.
Una griglia finale per valutare le prove
Tabella 2.10. Sei livelli di controllo di una conclusione
Verifica | Domanda guida |
|---|---|
Quesito e misure | Quale costrutto e quale esito sono davvero misurati? |
Disegno | Quali alternative causali può escludere? |
Campione e perdite | Quali persone sono incluse, escluse o assenti? |
Risultati | Quanto è grande l’effetto e quanto è incerto? |
Analisi | Quali decisioni erano pianificate e quali esplorative? |
Sintesi | Esistono repliche e convergenza di prove indipendenti? |
Prima di assumere una conclusione come base di decisioni pratiche è utile controllare se risponde davvero alla domanda di interesse. Un esperimento sul tempo di reazione in laboratorio può illustrare un meccanismo attentivo, ma non dimostra automaticamente che una determinata applicazione commerciale migliori lo studio o la sicurezza stradale. Uno studio clinico può riguardare una popolazione selezionata ed esiti a breve termine, senza offrire garanzie per tutte le persone o per un uso prolungato. La ricerca scientifica diventa utile quando le sue prove vengono applicate con la stessa precisione con cui sono state raccolte.
2.23 Strumenti psicologici e qualità della misura: modelli latenti e comparabilità
Un punteggio non coincide con il costrutto che vorremmo conoscere
Molte grandezze studiate dalla psicologia non sono direttamente osservabili. Ansia, fiducia, impulsività, autostima e soddisfazione non si misurano come una lunghezza con un righello: si inferiscono da indicatori comportamentali, risposte, osservazioni ripetute e modelli teorici. Si parla di costrutti latenti per indicare proprietà non osservate direttamente, rappresentate attraverso un insieme di indicatori. Quando un questionario somma venti risposte in un punteggio unico, compie implicitamente scelte importanti: assume che le domande riguardino un fenomeno sufficientemente coerente, che alcune risposte siano confrontabili e che la somma interpreti la posizione della persona in modo adeguato allo scopo. La grandezza numerica non dimostra da sola la validità di queste assunzioni.
Una scala sulla preoccupazione per gli esami, per esempio, potrebbe contenere domande su pensieri ricorrenti, disturbi del sonno e tensione muscolare. Se i tre aspetti rispondono in modo diverso a periodi dell'anno, condizioni mediche o pratiche culturali, il punteggio totale può mescolare informazioni non perfettamente equivalenti. La validità di contenuto chiede se gli indicatori rappresentino adeguatamente il campo concettuale di interesse. Le evidenze sulla struttura interna esplorano se le relazioni fra le risposte siano compatibili con il modello proposto. La validità rispetto a criteri esterni esamina i rapporti con altri fenomeni che, secondo una teoria, dovrebbero essere collegati o distinti. La validità non è una proprietà assoluta e immutabile del questionario: riguarda la giustificazione delle interpretazioni e degli usi dei suoi punteggi in determinati contesti.
Perché la coerenza interna non basta
La coerenza interna descrive come gli indicatori si relazionino all'interno di una scala. Una misura comunemente riportata è l'alfa di Cronbach. Un alfa elevato può essere compatibile con un insieme di domande simili, ma non dimostra in modo automatico che tutte misurino un singolo costrutto, che la scala sia valida o che il punteggio rimanga stabile nel tempo. Il coefficiente dipende anche dal numero di item, dalle correlazioni fra essi e dalle assunzioni del modello; molte domande quasi duplicate possono produrre valori elevati pur aggiungendo poca informazione sostanziale. In determinati casi sono più appropriati modelli fattoriali e coefficienti di affidabilità basati su assunzioni esplicite, come alcuni indici omega.
La stabilità test-retest valuta il rapporto fra misurazioni effettuate in momenti differenti. Tuttavia un punteggio può cambiare perché il costrutto è realmente cambiato, non soltanto perché lo strumento è impreciso. Se misuriamo l'umore prima e dopo un evento importante, una differenza è possibile e attesa; interpretare ogni cambiamento come errore sarebbe sbagliato. Viceversa, uno strumento che produce sempre punteggi molto simili potrebbe non cogliere una trasformazione reale. Bisogna quindi stabilire se la proprietà che si intende misurare sia concepita come relativamente stabile, transitoria o suscettibile di cambiamenti nel periodo osservato.
La teoria classica dei test distingue concettualmente punteggio osservato, componente vera secondo il modello ed errore: X = T + E. Il «vero» del modello non indica una conoscenza infallibile dell'essenza psicologica della persona, ma una definizione statistica entro assunzioni determinate. L'errore standard di misura aiuta a ricordare che un punteggio non è perfettamente preciso. Se uno strumento ha deviazione standard 15 e un'affidabilità stimata di 0,84, la formula semplificata SEM = 15 × √(1 − 0,84) produce un errore standard di misura pari a 6 punti. Si tratta di un risultato illustrativo, valido soltanto nella cornice delle assunzioni utilizzate; non consente di affermare che «il vero punteggio» di ogni individuo debba cadere esattamente in un intervallo deterministico di sei punti.
Confrontare gruppi richiede confrontare il significato delle misure
Una scala somministrata in due lingue può mostrare differenze di punteggio perché i partecipanti differiscono davvero nella caratteristica oppure perché le domande non hanno lo stesso significato pragmatico, emotivo o sociale. Analogamente, una domanda sul «sentirsi produttivi» può essere interpretata in modo diverso da un adolescente e da una persona pensionata. La invarianza di misura riguarda il grado in cui uno strumento mantiene la stessa relazione fra costrutto e indicatori nei gruppi confrontati. Nelle analisi fattoriali multigruppo si distinguono, fra altre, equivalenza della struttura generale, dei carichi fattoriali e delle intercette. Questi livelli non devono essere trattati come semplici formalità: determinano quali confronti siano difendibili.
Un test può apparire affidabile separatamente in due popolazioni e non permettere ugualmente di confrontarne le medie. Se una domanda è sistematicamente più facile, più accettabile o più familiare a un gruppo a parità del tratto latente, si può osservare un funzionamento differenziale dell'item. Le analisi di Differential Item Functioning possono aiutare a individuare tali differenze; non indicano automaticamente una discriminazione intenzionale né risolvono da sole la questione di equità. Occorrono valutazioni sul contenuto, sul contesto culturale, sulla finalità della misura e sulle conseguenze delle decisioni associate ai punteggi.
I modelli di risposta all'item studiano la probabilità di una risposta in funzione del livello del tratto latente e delle proprietà dell'item secondo un modello. In una formulazione semplice, una domanda più difficile richiede livelli più elevati della caratteristica per avere la stessa probabilità di risposta corretta. La precisione può variare lungo la scala: uno strumento può distinguere bene livelli medi di una capacità e risultare poco informativo agli estremi. Questa proprietà è rilevante quando si costruiscono prove adattive, screening o strumenti per valutare cambiamenti clinici. Anche i modelli più raffinati, tuttavia, necessitano di verifica empirica e di un'interpretazione sostantiva del costrutto.
Tabella 2.11. Domande per valutare uno strumento psicologico
Proprietà | Quesito centrale | Un rischio da evitare |
|---|---|---|
Contenuto | Gli item coprono il costrutto? | Sottorappresentazione del fenomeno |
Attendibilità | Con quali fonti di errore è coerente? | Scambiare alfa alto per validità |
Struttura | Il modello descrive gli indicatori? | Somma di dimensioni incongruenti |
Equivalenza | Le misure hanno lo stesso significato fra gruppi? | Confronti di media non giustificati |
Impiego | Che cosa accade quando il punteggio guida una decisione? | Eccesso di certezza sul singolo caso |
2.24 Ragionamento bayesiano e aggiornamento delle convinzioni
La probabilità dipende dall'informazione e dal modello
L'inferenza bayesiana descrive l'aggiornamento delle probabilità di ipotesi o parametri alla luce di dati osservati, secondo un modello esplicito. Il principio di base è che la distribuzione a priori rappresenti l'informazione o le assunzioni disponibili prima di considerare i nuovi dati, mentre la verosimiglianza esprima come i diversi valori ipotizzati rendano più o meno plausibili le osservazioni. Dalla loro combinazione si ottiene una distribuzione a posteriori. Questa struttura non rende automaticamente la conclusione soggettiva o arbitraria: rende invece visibili le assunzioni che entrano nell'analisi e permette di chiedersi quanto il risultato cambi quando quelle assunzioni vengono modificate.
Una difficoltà frequente è confondere la probabilità dei dati data un'ipotesi con la probabilità dell'ipotesi dati i risultati. Il valore p di un test frequentista è, sotto precise assunzioni, una probabilità di risultati almeno altrettanto estremi condizionata al modello nullo. Non è quindi la probabilità che l'ipotesi nulla sia vera. L'inferenza bayesiana può assegnare probabilità posteriori ai valori dei parametri, ma queste dipendono dal modello e dalle distribuzioni a priori adottate. Un risultato scritto come «probabilità del 95% che l'effetto sia positivo» può essere appropriato in una specifica analisi bayesiana, mentre non coincide con l'interpretazione standard di un intervallo frequentista al 95%.
Un esempio numerico di aggiornamento semplice
Immaginiamo, senza riferirci a dati reali, di esaminare un'ipotesi H che prima delle osservazioni abbia probabilità 20%; la sua alternativa ha probabilità 80%. Si osserva un risultato E che, secondo il modello, avrebbe probabilità 60% se H fosse vera e 15% se H fosse falsa. La probabilità a posteriori si calcola come P(H|E) = [0,60 × 0,20]/([0,60 × 0,20] + [0,15 × 0,80]) = 0,12/(0,12 + 0,12) = 0,50. Il dato porta quindi l'ipotesi dal 20% al 50%, non direttamente al 60%. Quest'ultimo era infatti la probabilità del risultato dato H, non la probabilità di H dato il risultato. Il procedimento è una forma della regola di Bayes e vale entro l'impostazione probabilistica specificata.
Le odds a priori di H erano 0,20/0,80 = 0,25; il rapporto di verosimiglianza per il risultato osservato è 0,60/0,15 = 4. Le odds a posteriori sono allora 0,25 × 4 = 1, corrispondenti a una probabilità 1/(1+1) = 0,50. Questa seconda via di calcolo mostra con chiarezza che la forza informativa della nuova osservazione si combina con la plausibilità iniziale attribuita all'ipotesi. Lo stesso risultato può produrre conclusioni differenti se viene inserito in contesti in cui l'ipotesi era inizialmente molto rara oppure già fortemente sostenuta da evidenze precedenti.
Nell'analisi dei parametri, le distribuzioni a priori debolmente informative possono scoraggiare valori estremi poco plausibili senza concentrare tutta la massa su una singola ipotesi rigida. In campioni piccoli la scelta della distribuzione a priori può influenzare molto la stima, ed è pertanto importante esaminare alternative ragionevoli. Nel confronto fra modelli si possono utilizzare fattori di Bayes, previsioni posteriori e altri strumenti, ciascuno con le proprie assunzioni. Un fattore di Bayes quantifica in modo relativo quanto i dati siano sostenuti da due modelli specificati; non dovrebbe essere presentato come un indice universale indipendente dalla formulazione delle alternative.
Controllare il modello, non soltanto calcolare la posteriori
Una procedura bayesiana può produrre una distribuzione numericamente precisa e comunque descrivere male il fenomeno. I posterior predictive checks confrontano caratteristiche dei dati realmente osservati con quelle che il modello sarebbe in grado di generare, per identificare discrepanze rilevanti. Se un modello sulle risposte emotive prevede distribuzioni simmetriche ma i dati presentano concentrazioni agli estremi e numerose risposte zero, la struttura stessa del modello merita una revisione. Questa logica si collega al controllo dei residui nella regressione e, più in generale, all'idea che il buon adattamento statistico non sostituisca la validità teorica della misura e del disegno.
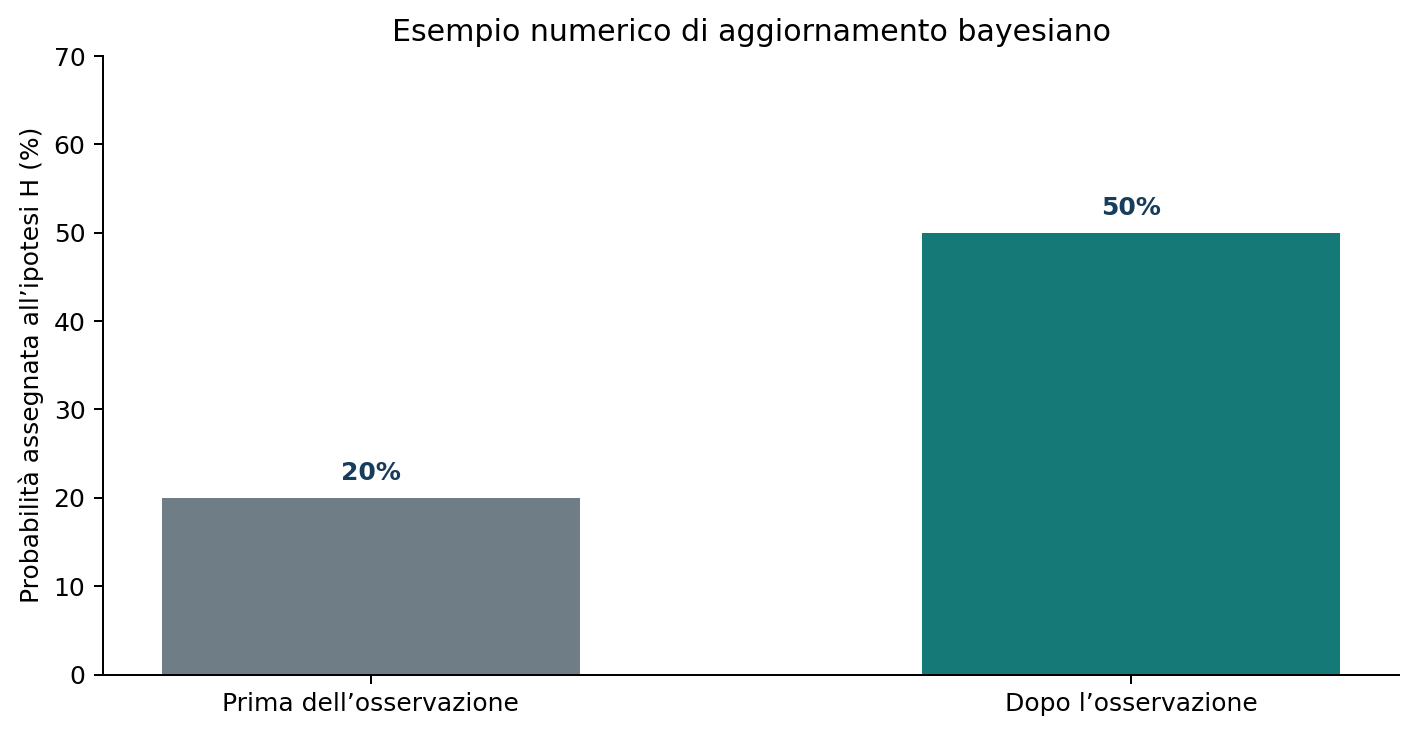
2.25 Esperimenti più informativi: potenza, precisione e disegni efficienti
La pianificazione deve partire dall'effetto che conta
Quando si progetta una ricerca, un errore ricorrente consiste nel decidere la numerosità del campione soltanto sulla base del tempo disponibile o del numero di persone reclutabili. La dimensione necessaria dipende invece dalla domanda: una differenza media piccola richiede, a parità di condizioni, più dati per essere stimata con una precisione utile rispetto a una differenza grande. La variabilità delle risposte, la qualità della misura, la presenza di dati ripetuti e la struttura dei gruppi modificano ulteriormente il fabbisogno informativo. Una pianificazione responsabile può usare analisi di potenza, obiettivi di precisione degli intervalli e simulazioni calibrate su scenari motivati.
Un'analisi di potenza tradizionale richiede di specificare almeno un effetto di interesse, una procedura di test, un livello di errore di primo tipo e una probabilità desiderata di individuare quell'effetto se fosse presente. È importante che l'effetto utilizzato sia scientificamente significativo, non soltanto quello più ottimistico individuato in uno studio precedente. Gli effetti pubblicati possono infatti essere sovrastimati, soprattutto quando derivano da campioni piccoli o da selezione di risultati. Un'alternativa consiste nel pianificare una ampiezza massima desiderata per l'intervallo di confidenza, se l'obiettivo principale è stimare un parametro anziché superare una soglia di significatività.
Misure ripetute, randomizzazione per cluster e contaminazione
Un disegno entro soggetti può ridurre la variabilità dovuta a differenze stabili fra persone, perché ciascun partecipante funge da proprio confronto. Tuttavia introduce il rischio di effetti d'ordine, apprendimento del compito, affaticamento e trasferimento da una condizione all'altra. Il contro-bilanciamento delle sequenze e gli intervalli appropriati fra condizioni possono limitarli, ma non garantiscono sempre di annullarli. Un disegno tra soggetti, al contrario, evita alcuni effetti di trasferimento ma spesso richiede più partecipanti per ottenere precisione comparabile. La scelta dipende dal fenomeno e dalla reversibilità degli interventi.
Quando un programma educativo viene erogato a intere classi, assegnare individualmente gli studenti può essere impraticabile perché insegnanti e compagni condividono informazioni. In questi casi si può randomizzare la classe o la scuola: è un esperimento a grappoli o cluster. La randomizzazione dei cluster riduce alcuni rischi di contaminazione ma non produce automaticamente un grande numero di unità indipendenti. Se si randomizzano quattro scuole con cento studenti ciascuna, le unità effettive di assegnazione sono quattro, non quattrocento. L'analisi e la pianificazione devono riflettere la correlazione interna ai cluster e il numero di cluster disponibili.
Nei disegni fattoriali si possono valutare più fattori contemporaneamente. Se si confrontano due forme di feedback (immediato/differito) e due ritmi di studio (distribuito/concentrato), un disegno 2 × 2 permette di stimare effetti medi dei due fattori e la loro possibile interazione. La presenza di un'interazione cambia il modo corretto di discutere gli effetti principali: «il feedback immediato migliora in media» può non descrivere adeguatamente la differenza fra i due ritmi di studio. Quando le interazioni sono l'obiettivo primario, occorre pianificare adeguata precisione per stimarle; non basta avere potenza per una semplice differenza fra due gruppi.
Il caso degli studi pilota
Uno studio pilota è utile per verificare fattibilità, tempi, comprensibilità degli strumenti, procedure di reclutamento e funzionamento del protocollo. Un piccolo studio pilota non dovrebbe essere usato come prova conclusiva dell'efficacia di un trattamento, né il suo effetto osservato dovrebbe diventare automaticamente la stima su cui progettare la ricerca definitiva. In piccoli campioni l'incertezza è spesso ampia. È più rigoroso trattare il pilota come una prova del metodo e utilizzare anche conoscenze esterne e scenari conservativi per la pianificazione successiva.
Tabella 2.12. Scelte di disegno e minacce specifiche
Impostazione | Vantaggio tipico | Rischio da controllare |
|---|---|---|
Entro soggetti | Controllo di differenze stabili | Ordine, apprendimento, trasferimento |
Tra soggetti | Minore contaminazione fra condizioni | Differenze casuali e perdita di precisione |
Randomizzazione a cluster | Riduzione di contaminazione organizzativa | ICC e pochi cluster indipendenti |
Fattoriale | Confronto di più fattori e loro interazione | Interazioni poco precise se sottodimensionato |
Pilota | Verifica di fattibilità e procedure | Scambiarlo per prova di efficacia |
2.26 Metodi qualitativi e metodi misti: conoscere i significati senza ridurli a numeri
Quando la domanda richiede le parole dei partecipanti
Alcuni fenomeni psicologici si comprendono male se vengono tradotti immediatamente in risposte predefinite. Una persona può interpretare il proprio isolamento come rifiuto, bisogno di tranquillità, protezione o desiderio di autonomia. Una scala numerica può quantificare aspetti di quell'esperienza, ma potrebbe non cogliere le ragioni con cui le persone attribuiscono significato al comportamento. La ricerca qualitativa studia discorsi, narrazioni, pratiche e contesti attraverso procedure sistematiche. Non è semplicemente ricerca «senza statistica» e non consiste nel riportare alcune frasi suggestive; richiede un disegno coerente, un processo analitico documentabile e una riflessione su come il ricercatore contribuisca alla produzione e all'interpretazione dei dati.
Nelle interviste semistrutturate il ricercatore definisce un insieme di temi ma consente risposte aperte e approfondimenti in funzione di ciò che emerge. Nei gruppi di discussione l'interazione fra partecipanti diventa essa stessa una fonte di informazioni: gli accordi, i conflitti e le negoziazioni del significato possono mostrare dinamiche che una serie di interviste individuali non rivelerebbe. L'osservazione partecipante richiede attenzione al ruolo del ricercatore nel contesto osservato; la sua presenza può modificare comportamenti e rapporti. In tutti questi metodi bisogna chiarire la selezione delle persone, la raccolta del consenso, la registrazione e la gestione riservata dei dati, nonché la strategia adottata per trasformare il materiale grezzo in conclusioni.
La analisi tematica individua schemi di significato nel materiale, ma esistono approcci differenti: alcuni lavorano con un sistema di codifica più strutturato, altri valorizzano l'interpretazione riflessiva e il ruolo attivo degli analisti. Non sarebbe corretto usare indiscriminatamente gli stessi criteri di «accordo fra codificatori» per tutte le tradizioni qualitative; la coerenza della valutazione deve dipendere dalla domanda epistemologica e dalle procedure dichiarate. Allo stesso modo, la saturazione dei temi non è una soglia universale misurabile semplicemente contando il numero di interviste: il suo significato varia in funzione del disegno, della complessità dei partecipanti e del tipo di analisi.
Metodi misti e triangolazione: due tipi di prova, non due metà incomplete
I metodi misti integrano dati quantitativi e qualitativi all'interno di un progetto per rispondere a domande che un solo approccio affronterebbe parzialmente. Supponiamo che un intervento contro l'abbandono universitario produca una riduzione misurata del numero di rinunce. Il dato quantitativo può descrivere quanto il fenomeno cambi in un determinato campione; le interviste possono esplorare in quali circostanze gli studenti abbiano trovato utile il programma, quali ostacoli siano rimasti e perché alcuni non vi abbiano partecipato. L'integrazione deve essere progettata: accostare un grafico e tre citazioni nello stesso articolo non costituisce automaticamente un disegno misto rigoroso.
La triangolazione confronta prospettive, fonti o strumenti differenti, ma non garantisce che una concordanza sia necessariamente vera. Due misure possono condividere lo stesso bias, per esempio perché derivano dalla stessa autovalutazione. D'altro canto, risultati divergenti possono fornire indicazioni importanti: ciò che le persone raccontano sull'efficacia di una pratica potrebbe differire da quanto emerge da misure comportamentali, senza che una delle due informazioni sia per definizione irrilevante. La discrepanza può orientare nuove ipotesi su desiderabilità sociale, contesto di misura o differenza fra esperienza vissuta ed esito oggettivo.
Nella scrittura finale bisogna distinguere trasferibilità interpretativa e generalizzazione statistica. Una ricerca qualitativa approfondita in una comunità specifica può chiarire processi e costruire concetti utili altrove, senza poter stimare automaticamente la percentuale di persone che condividono un'esperienza nella popolazione. La qualità dipende dalla ricchezza e pertinenza dei materiali, dalla trasparenza dell'analisi, dalla riflessività del ricercatore e dalla disponibilità di elementi sufficienti per valutare se l'interpretazione sia plausibile rispetto al contesto. Il metodo appropriato non è quello che produce il dato più appariscente: è quello capace di rispondere con maggiore rigore alla domanda formulata.
Approfondimenti: tre esperimenti e che cosa insegnano sul metodo
Interferenza tra lettura e denominazione dei colori
Un esempio classico di trasformazione di un problema cognitivo in una misura controllabile è il lavoro pubblicato nel 1935 da John Ridley Stroop. Il problema consisteva nel capire perché compiti apparentemente semplici possono interferire fra loro quando caratteristiche diverse dello stesso stimolo suggeriscono risposte incompatibili. In una condizione si può chiedere di leggere parole che indicano colori; in un'altra di denominare il colore dell'inchiostro ignorando la parola. Se la parola «verde» è stampata in rosso, la risposta corretta alla seconda consegna è «rosso»: l'abitudine di leggere può competere con il compito di nominare l'inchiostro.
Il risultato storico, verificabile nell'articolo originale, mostrò un'interferenza marcata della parola incongruente sul tempo necessario a denominare i colori. La differenza fu molto più evidente rispetto all'interferenza opposta dell'inchiostro sulla lettura delle parole. Stroop descrisse più esperimenti con materiali e partecipanti universitari; non è corretto ridurre l'intero lavoro a una sola prova con un unico campione né trasferire automaticamente la sua grandezza numerica a una versione digitale odierna. Il contributo metodologico sta nel costruire condizioni che isolano in modo operativo due compiti simili ma non equivalenti, usando tempi ed errori come indicatori della competizione cognitiva.
Non possiamo però concludere che il compito misuri soltanto una capacità pura e universale chiamata «controllo dell'attenzione». Familiarità con le parole, velocità di lettura, strategie, lingua e modalità di risposta possono influire sulla prestazione. La validità di costrutto richiede una rete di risultati, non un'unica dimostrazione memorabile. Studi successivi hanno impiegato molte varianti del paradigma, mostrando l'importanza di specificare quale versione si utilizza e quale ipotesi intende mettere alla prova.
Domande suggestive e ricostruzione dei ricordi
Elizabeth Loftus e John Palmer pubblicarono nel 1974 una ricerca dedicata all'influenza delle parole utilizzate nelle domande dopo la visione di filmati di incidenti automobilistici. Il quesito era se una differenza nel linguaggio della domanda potesse alterare la stima della velocità e, in un'ulteriore prova, i ricordi dichiarati di dettagli non presenti. Il disegno sperimentale manipolava il verbo impiegato nella domanda, mantenendo costante l'evento visivo rilevante per il confronto. La variabile osservata era dapprima una stima numerica, successivamente una risposta sulla presenza di vetri rotti.
L'estratto dell'articolo documenta che formulazioni più energiche produssero stime di velocità maggiori e che, in una successiva prova, chi aveva ricevuto una formulazione particolarmente forte riferiva più spesso di avere visto vetri rotti, assenti nel filmato. Questi risultati costituiscono evidenza sperimentale che l'informazione successiva a un evento può influenzare i resoconti. Non dimostrano però che ogni ricordo sia fabbricato a piacere o che tutti i testimoni siano inattendibili: l'effetto dipende da procedura, materiali, tempo e formulazioni, e le spiegazioni dei processi mentali sottostanti richiedono ulteriori verifiche.
L'esperimento illustra bene la differenza tra manipolazione e inferenza teorica. Il verbo nella domanda è stato modificato; la velocità reale dei veicoli non è cambiata. L'effetto osservabile riguarda le risposte, mentre l'interpretazione dei meccanismi della memoria richiede teorie e convergenza con altre misure. La stessa attenzione metodologica è necessaria quando si raccolgono testimonianze, interviste o dichiarazioni retrospettive: domande orientate possono modificare il dato che si pretende semplicemente di registrare.
La presenza di altri osservatori e l'intervento in emergenza
Nel 1968 John Darley e Bibb Latané studiarono sperimentalmente l'intervento in una situazione percepita come emergenza. Partecipanti universitari ascoltavano una situazione simulata tramite comunicazione audio e ritenevano che un'altra persona fosse in difficoltà; una manipolazione cruciale riguardava quanti altri possibili ascoltatori fossero presenti. I ricercatori osservarono se e quanto rapidamente i partecipanti cercassero aiuto. Il risultato riportato mostrava che la presenza percepita di altri riduceva la rapidità della segnalazione, coerentemente con una possibile diffusione della responsabilità.
Il valore del lavoro non sta nella tesi superficiale secondo cui «gli esseri umani sono indifferenti quando sono in gruppo». L'esperimento cercava, piuttosto, di isolare un aspetto della situazione — il numero di altri osservatori ritenuti presenti — e di confrontarlo con una specifica risposta. Un limite importante riguarda l'uso di una simulazione, la natura del campione, le aspettative dei partecipanti e la trasferibilità a emergenze molto diverse. La procedura introduce anche interrogativi etici, perché la situazione può evocare allarme e perché i partecipanti non conoscevano tutti gli elementi della messa in scena.
Questi tre studi hanno oggetti distinti — interferenza cognitiva, memoria, comportamento sociale — ma mostrano una struttura comune: definire un confronto osservabile, registrare una risposta e discutere quanto si possa inferire da essa. Il passaggio dall'esperimento alla teoria è precisamente il punto in cui servono prudenza e ulteriori studi. Nessuno di essi dovrebbe essere usato come formula per descrivere ogni persona in ogni circostanza.
Errori comuni e falsi miti sul metodo scientifico
«Un risultato significativo dimostra che l'ipotesi è vera». La significatività statistica indica un rapporto fra dati e specifiche assunzioni sotto un modello. Non dimostra la validità di un'intera teoria né quantifica automaticamente la probabilità che sia corretta. Contano grandezza, incertezza, qualità delle misure e prove indipendenti.
«Se due variabili sono correlate, una causa l'altra». Una correlazione è compatibile con diversi meccanismi causali, fra cui causalità inversa, fattori comuni e selezione. Per sostenere una causa serve un disegno di ricerca e un argomento sulle alternative.
«Un campione grande è sempre rappresentativo». La dimensione riduce alcuni tipi di variabilità campionaria, ma non elimina distorsioni sistematiche di selezione o non risposta. La rappresentatività dipende da come sono state selezionate le unità e da quale popolazione si vuole descrivere.
«Una misura ripetibile è necessariamente valida». Uno strumento può produrre punteggi stabili e tuttavia rappresentare il costrutto sbagliato. Attendibilità e validità rispondono a domande diverse.
«Un esperimento randomizzato risolve ogni problema». La randomizzazione rafforza l'interpretazione causale del confronto creato, ma non garantisce buona misurazione, adesione, assenza di abbandoni o trasferibilità ad altre popolazioni.
«Un articolo non replicato è automaticamente falso». Una replica può differire per precisione, procedure o contesto. Occorre confrontare stime, intervalli e assunzioni prima di classificare risultati come compatibili o incompatibili.
«La ricerca qualitativa non è scientifica perché non utilizza sempre numeri». Metodi diversi rispondono a domande diverse. Una ricerca qualitativa rigorosa rende espliciti raccolta dei materiali, criteri interpretativi e limiti delle conclusioni; non è dispensata dalla critica metodologica.
«Pubblicare tutti i dati rende sempre migliore la scienza». Trasparenza e accessibilità sono importanti, ma il diritto alla riservatezza e il rischio di reidentificazione richiedono talvolta restrizioni, anonimizzazioni robuste o accessi controllati.
Collegamenti interdisciplinari
Il metodo psicologico dialoga costantemente con altre discipline. Dalla biologia riprende l'attenzione alla misurazione dei processi organismici e alla distinzione tra meccanismi e correlati. Dalla medicina eredita molti criteri per la valutazione di interventi, inclusi gruppi di controllo, bilanciamento dei rischi ed elaborazione delle prove cumulative. Dall'econometria e dalla statistica utilizza strumenti per separare effetti causali da associazioni, trattare dati longitudinali e quantificare l'incertezza. Dalla filosofia della scienza trae la riflessione sul rapporto tra osservazioni, teorie e spiegazioni. Dalla sociologia e dall'antropologia riceve l'esigenza di interrogare contesto, significati e categorie di osservazione.
Queste connessioni non autorizzano a trasferire automaticamente una tecnica da un ambito all'altro. Un modello costruito per serie temporali economiche potrebbe non descrivere bene dati raccolti da persone che interagiscono nello stesso gruppo; una procedura clinica può essere inappropriata per un quesito di psicologia dello sviluppo. La competenza interdisciplinare consiste nel comprendere le assunzioni degli strumenti, non soltanto nell'impararne il nome.
Sintesi ragionata
La psicologia diventa scienza quando trasforma domande sul comportamento e sull'esperienza in confronti che ammettono esiti diversi da quelli attesi. Le teorie organizzano concetti e formulano previsioni; le ipotesi selezionano relazioni controllabili; le definizioni operative collegano concetti astratti a misure. Ogni passaggio può fallire: una teoria può essere vaga, una misura inadeguata, un campione distorto oppure una procedura incoerente con il quesito.
I metodi osservativi descrivono ciò che accade e consentono di studiare fenomeni in contesti relativamente naturali; correlazioni e disegni longitudinali rivelano associazioni e traiettorie, ma non isolano automaticamente la causalità. Gli esperimenti costruiscono un confronto manipolando un fattore; l'assegnazione casuale e il controllo delle condizioni rafforzano l'inferenza causale, pur lasciando aperte questioni di precisione, rappresentatività e trasferibilità. Nessun disegno è migliore per tutte le domande: il criterio è la relazione tra quello che si vuole sapere e quello che il metodo permette effettivamente di concludere.
La statistica descrittiva organizza valori, distribuzioni e differenze; quella inferenziale valuta l'incertezza di affermazioni che vanno oltre le osservazioni disponibili. Media e mediana, deviazione standard ed errore standard, correlazione e regressione, valore p e intervallo di confidenza non sono termini intercambiabili. Comprenderli significa distinguere una quantità osservata da una stima incerta, la grandezza di un effetto dalla sua compatibilità con un modello nullo e un risultato numericamente corretto da una spiegazione causale fondata.
Infine, le prove scientifiche acquisiscono credibilità nel tempo attraverso misure valide, documentazione delle procedure, repliche, sintesi sistematiche e revisione pubblica. L'etica accompagna tutte queste attività: le persone non sono semplici fonti di dati, gli animali non sono strumenti privi di tutela e l'incertezza scientifica non è un difetto da nascondere. Un lettore competente impara quindi non soltanto a calcolare, ma a chiedere quale domanda sia stata posta, quale prova sia stata raccolta e quanto sia legittimo affermare sulla base di essa.
Glossario del capitolo
Analisi di potenza: valutazione probabilistica della capacità di un test di rilevare uno specifico effetto in un determinato disegno.
Assegnazione casuale: attribuzione probabilistica delle unità alle condizioni di uno studio.
Attendibilità: grado di coerenza delle misure rispetto alle fonti di variabilità considerate.
Bias: distorsione sistematica in misurazione, campionamento, analisi o inferenza.
Bias di pubblicazione: squilibrio nella disponibilità degli studi legato ai loro risultati o ad altri fattori selettivi.
Calibrazione predittiva: corrispondenza tra probabilità previste da un modello e frequenze osservate entro categorie appropriate.
Campionamento probabilistico: selezione delle unità con probabilità d'inclusione stabilite dal disegno.
Campione: insieme delle unità effettivamente osservate per studiare una popolazione o un processo.
Causalità: relazione per la quale un cambiamento in una causa produce, in condizioni specificate, una differenza nell'esito.
Coefficiente di correlazione: indice della direzione e dell'intensità di una relazione secondo una forma specificata.
Collider: variabile causata da due o più fattori, il cui condizionamento può creare associazioni spurie.
Confondimento: distorsione di un'associazione dovuta a fattori collegati a esposizione ed esito.
Consenso informato: processo attraverso cui una persona riceve informazioni adeguate e decide liberamente se partecipare alla ricerca.
Controbilanciamento: variazione pianificata dell'ordine delle condizioni per ridurre effetti di sequenza.
Controfattuale: esito che un'unità avrebbe presentato in una condizione alternativa a quella osservata.
Costrutto: concetto teorico utilizzato per organizzare e spiegare fenomeni psicologici osservabili.
DAG: diagramma aciclico diretto che rappresenta ipotesi causali mediante nodi e frecce.
Debriefing: spiegazione post-studio di elementi rilevanti della procedura e dei suoi obiettivi.
Definizione operativa: specificazione di procedure con cui un concetto viene osservato o manipolato.
Design effect: fattore che quantifica, entro un dato modello, la variazione della varianza della stima dovuta al disegno campionario.
Deviazione standard: radice della varianza; misura di dispersione espressa nell'unità originaria.
Differenze nelle differenze: strategia che confronta le variazioni di un gruppo esposto con quelle di un gruppo di confronto sotto precise assunzioni.
Dimensione dell'effetto: misura quantitativa della grandezza di una differenza o relazione.
Disegno a cluster: studio in cui si selezionano o assegnano gruppi di unità anziché necessariamente singoli individui.
Disegno fattoriale: studio in cui si variano più fattori per stimare effetti e interazioni.
Distribuzione a posteriori: distribuzione dei parametri o delle ipotesi condizionata ai dati osservati e a un modello bayesiano.
Distribuzione campionaria: distribuzione teorica di una statistica su ripetizioni del campionamento.
Errore di primo tipo: rifiuto dell'ipotesi nulla quando è vera secondo il modello di test.
Errore di secondo tipo: mancato rifiuto dell'ipotesi nulla quando è falsa nell'alternativa considerata.
Errore standard: misura della variabilità campionaria di una statistica stimata.
Errore standard di misura: stima della dispersione degli errori di punteggio secondo una teoria e assunzioni specifiche.
Esperimento: disegno che modifica deliberatamente un fattore e ne confronta gli esiti in condizioni controllate.
Experience sampling: campionamento ripetuto delle esperienze delle persone durante la vita quotidiana.
False discovery rate: criterio relativo alla proporzione attesa di falsi positivi tra le scoperte selezionate, sotto un modello.
Falsificabilità: possibilità di specificare osservazioni incompatibili con una proposta teorica.
Forest plot: grafico delle stime di più studi e dei relativi intervalli di incertezza.
Funzionamento differenziale dell’item: variazione della relazione tra risposta a un item e tratto latente fra gruppi.
Imputazione multipla: procedura che crea più versioni plausibili dei dati mancanti e combina le analisi tenendo conto dell’incertezza.
Inferenzia statistica: procedura che collega osservazioni campionarie e affermazioni su parametri o processi sotto assunzioni esplicite.
Interazione: variazione dell'effetto di un fattore in funzione del livello di un altro fattore.
Interazione statistica: dipendenza dell’effetto o dell’associazione di un predittore dal livello di un altro secondo una scala e un modello.
Intervallo di confidenza: intervallo prodotto da una procedura con una copertura frequentista definita nel lungo periodo.
Intervallo interquartile: differenza fra terzo e primo quartile di una distribuzione.
Invarianza di misura: proprietà per cui il legame fra costrutto e indicatori si mantiene sufficientemente comparabile fra gruppi o tempi.
Ipotesi: affermazione specifica e controllabile su una relazione, una differenza o un fenomeno.
Ipotesi nulla: modello di riferimento sottoposto a test, spesso relativo all'assenza di una differenza specificata.
Likelihood ratio: rapporto fra la probabilità di un risultato sotto due ipotesi o condizioni specificate.
MAR: meccanismo di dati mancanti indipendente dai valori non osservati, dopo condizionamento sulle variabili osservate considerate.
MCAR: meccanismo in cui la probabilità di mancanza è indipendente dai dati osservati e mancanti.
Media aritmetica: somma dei valori divisa per il numero delle osservazioni.
Mediana: valore centrale della distribuzione ordinata secondo la convenzione di calcolo.
Mediatore: variabile che rappresenta un possibile percorso attraverso il quale si produce un effetto.
Meta-analisi: sintesi quantitativa di stime provenienti da più studi secondo un modello.
MNAR: meccanismo in cui la mancanza dipende anche da valori non osservati, dopo le condizioni del modello.
Modello a effetti misti: modello che combina effetti condivisi e componenti casuali associate a unità o gruppi.
Modello di risposta all’item: famiglia di modelli che lega la probabilità di risposta alle caratteristiche latenti e agli item.
Moderatore: caratteristica che modifica la grandezza o la direzione di una relazione.
Non risposta: assenza di dati richiesta al campione o a una parte di esso.
Outlier: osservazione distante dalle altre secondo criteri descrittivi o di modello.
Overfitting: adattamento eccessivo alle specificità dei dati disponibili che penalizza la prestazione su nuove osservazioni.
Paradosso di Simpson: inversione o cambiamento di una relazione dopo aggregazione di gruppi con composizioni diverse.
Percentile: posizione relativa in una distribuzione ordinata.
Placebo: condizione di confronto progettata per controllare componenti aspecifiche di un intervento.
Ponderazione campionaria: assegnazione di pesi alle unità per tener conto del disegno e di informazioni note sulla popolazione.
Posterior predictive check: confronto fra dati osservati e dati generabili da un modello bayesiano per valutarne l’adeguatezza.
Potenza statistica: probabilità di segnalare un effetto in un test, data una specifica alternativa e le condizioni del disegno.
Preregistrazione: documentazione anticipata e datata di ipotesi, procedure e piani principali di analisi.
Prevalenza: proporzione di individui che presenta una condizione in una popolazione definita.
Randomizzazione: impiego di un meccanismo casuale per selezionare o assegnare unità, secondo il problema considerato.
Regressione: famiglia di modelli per descrivere o prevedere la relazione tra esito e predittori.
Regressione discontinua: disegno quasi-sperimentale basato su una discontinuità dell’assegnazione in corrispondenza di una soglia.
Replicabilità empirica: possibilità di ottenere evidenze compatibili effettuando nuovi studi.
Riproducibilità computazionale: possibilità di ricreare i risultati analitici utilizzando gli stessi dati e le procedure documentate.
Scala nominale: classificazione in categorie non ordinate quantitativamente.
Scala ordinale: misura con categorie ordinabili ma distanze non necessariamente confrontabili.
Scienza aperta: insieme di pratiche per rendere trasparenti e controllabili processi e risultati della ricerca.
Selezione: processo con cui unità o risultati entrano nell'analisi, potenzialmente capace di introdurre distorsioni.
Sensibilità del test: quota di individui con la condizione correttamente individuata come positiva, nella popolazione pertinente.
Specificità del test: quota di individui senza la condizione correttamente individuata come negativa, nella popolazione pertinente.
Statistica descrittiva: tecniche che sintetizzano e rappresentano i dati osservati.
Statistica inferenziale: tecniche per ragionare su generalizzazione, stima e incertezza dei dati.
Test-retest: valutazione della stabilità di una misura ripetuta in momenti diversi.
Trend paralleli: assunzione secondo cui, senza intervento, i gruppi considerati avrebbero presentato andamenti comparabili nel tempo.
Validazione incrociata: procedura di valutazione predittiva basata su suddivisioni ripetute o sistematiche tra dati di stima e valutazione.
Validità di costrutto: qualità delle evidenze che collegano le misure ai concetti teorici dichiarati.
Validità esterna: grado di trasferibilità dei risultati a popolazioni e contesti ulteriori.
Validità interna: credibilità dell'interpretazione causale entro uno studio.
Valore p: probabilità, sotto il modello nullo e le assunzioni del test, di risultati almeno altrettanto estremi di quelli osservati.
Valore predittivo positivo: quota degli individui risultati positivi che presenta effettivamente la condizione nel contesto specificato.
Variabile dipendente: esito registrato in relazione a una manipolazione o a predittori.
Variabile indipendente: fattore manipolato o predittore, a seconda del disegno e delle convenzioni.
Varianza: misura della dispersione quadratica delle osservazioni rispetto alla media.