
10. L’intelligenza
Che cosa intendiamo quando diciamo che una persona è intelligente? La risposta spontanea può essere diversa a seconda che si pensi a uno studente che apprende rapidamente, a una professionista capace di risolvere un problema inatteso o a una persona che sa adattarsi a circostanze difficili. In psicologia non basta raccogliere esempi convincenti: bisogna definire che cosa si vuole misurare, costruire prove affidabili, verificare che i risultati prevedano qualcosa di rilevante e riconoscere ciò che le misure non possono dire. Questo capitolo presenta l’intelligenza come un insieme di abilità cognitive studiabili scientificamente, non come un giudizio complessivo sul valore delle persone.
Obiettivi formativi
Comprendere la distinzione fra capacità generale e abilità specifiche; ricostruire l’origine dei test e dei modelli psicometrici; interpretare correttamente punteggi standardizzati e intervalli di confidenza; distinguere attendibilità, validità ed equità; comprendere l’interazione fra ereditarietà e ambiente; esaminare in modo critico affermazioni sulle differenze individuali e tra gruppi; valutare realisticamente gli interventi di potenziamento cognitivo.
10.1 — Che cosa misurano i test di intelligenza
Una prova cognitiva non misura l’intelligenza come un termometro misura la temperatura. Presenta alla persona un insieme di compiti: riconoscere relazioni, manipolare informazioni, comprendere parole, individuare regole o risolvere problemi. Le risposte sono osservazioni; l’intelligenza è invece un costrutto, cioè una caratteristica teorica utilizzata per interpretare una struttura regolare di prestazioni. Il passaggio dal compito al costrutto richiede una catena di argomentazioni: bisogna mostrare che la prova rileva ciò che dichiara di rilevare, che produce risultati sufficientemente stabili e che funziona nel contesto in cui viene impiegata. Un punteggio non è una spiegazione: è un risultato da spiegare e interpretare.
Se una persona comprende con facilità un testo complesso ma si muove lentamente in un compito cronometrato, non è corretto condensare immediatamente tutto in un’etichetta. Il profilo delle abilità può contenere punti relativamente forti e deboli; a loro volta, fatica, familiarità con la lingua della prova, ansia, salute, condizioni ambientali e opportunità di istruzione possono influenzare la prestazione. La standardizzazione riduce alcune fonti di variabilità, ma non elimina il contesto. Per questa ragione la valutazione psicologica professionale integra punteggi, osservazione, storia individuale e finalità concrete dell’esame.
La nozione di capacità cognitiva generale nasce da un’osservazione empirica: le prestazioni di persone diverse in prove mentali differenti tendono spesso a correlare positivamente. Chi ottiene un risultato relativamente elevato in un compito di ragionamento tende, in media, a raggiungere risultati favorevoli anche in altri compiti, pur senza alcuna garanzia per il singolo caso. Questa correlazione positiva, chiamata talvolta manifold positivo, non autorizza a immaginare una singola sostanza mentale. È una proprietà della distribuzione dei risultati che diversi modelli tentano di spiegare. I fattori latenti sintetizzano covariazioni, ma la loro esistenza statistica non identifica automaticamente una causa biologica unica.
10.1.1 — Definire un costrutto senza trasformarlo in una cosa
La misurazione psicologica inizia con un problema di definizione. Quando un ricercatore parla di «intelligenza», non può indicare un oggetto delimitato come un osso o una ghiandola. Introduce piuttosto un costrutto: un concetto teorico utile per organizzare differenze osservabili fra persone e per formulare previsioni. L'operazionalizzazione consiste nello scegliere procedure attraverso le quali il costrutto possa essere studiato: prove di ragionamento, memoria di lavoro, comprensione verbale, soluzione di problemi. Una buona operazionalizzazione è argomentata, non arbitraria; non significa che il costrutto coincida per definizione con il punteggio. Identificare l'intelligenza con «ciò che misura il test» sarebbe circolare, perché eviterebbe proprio la domanda cruciale: per quali ragioni la prova costituisce un indicatore adeguato di capacità più generali?
Consideriamo una prova nella quale bisogna individuare il simbolo mancante in una matrice di figure. Il successo può richiedere il riconoscimento di simmetrie, trasformazioni e regole combinatorie. È però influenzato anche dalla capacità di comprendere le istruzioni, dall'attenzione sostenuta, dalle strategie adottate, dal tempo disponibile e dall'esperienza con esercizi simili. Nessuna di queste condizioni rende inutile il test; indica semplicemente che il punteggio è una risultante. Il compito dello psicometrista è stimare quanto della variabilità osservata corrisponda alla competenza d'interesse e quanto, invece, sia dovuto ad altre fonti. Se una persona ottiene risultati differenti in due prove, la discrepanza non dimostra necessariamente che una delle due sia «sbagliata»: può riflettere abilità specifiche, errore di misura o differenze genuine nei compiti.
Questo principio aiuta a distinguere tre domande che spesso vengono confuse. La prima è descrittiva: come si distribuiscono le prestazioni in una popolazione? La seconda è predittiva: in quale misura un certo risultato permette di prevedere, con incertezza, prestazioni future in compiti rilevanti? La terza è esplicativa: quali processi cognitivi, neurali e ambientali producono le differenze individuali? Un modello statistico può rispondere assai bene alla prima e alla seconda domanda senza risolvere la terza. Viceversa, uno studio neuroscientifico di un circuito può chiarire un meccanismo senza produrre automaticamente uno strumento affidabile di valutazione individuale. La psicologia dell'intelligenza si costruisce proprio combinando questi livelli.
10.1.2 — Profili cognitivi, contesto e limiti della previsione
Nel linguaggio ordinario si tende a considerare l'intelligenza un attributo uniforme della persona. La valutazione cognitiva suggerisce una descrizione più articolata. Un individuo può mostrare una notevole capacità di astrazione verbale e incontrare difficoltà in compiti visuospaziali; un altro può ragionare con efficacia su figure e relazioni ma impiegare tempi più lunghi nell'accesso alle parole. Il profilo non va interpretato come un insieme di etichette fisse, perché le differenze tra subtest hanno una propria incertezza statistica. Lo psicologo deve distinguere una discrepanza sufficientemente grande e attendibile da oscillazioni comuni anche in persone senza particolari difficoltà.
La situazione di valutazione modifica, in parte, ciò che è osservabile. Una prova somministrata in una lingua poco conosciuta introduce un carico linguistico ulteriore; una prova cronometrata può attribuire più peso alla velocità di risposta; un ambiente rumoroso può accentuare vulnerabilità attentive. Analogamente, un individuo con ridotte capacità motorie può conoscere perfettamente la soluzione e non riuscire a registrarla con la modalità richiesta. L'adattamento delle condizioni di somministrazione è dunque spesso necessario, ma bisogna chiedersi se cambi il costrutto effettivamente misurato. Concedere più tempo può eliminare un ostacolo irrilevante in una prova di ragionamento non temporizzata; in un test che intende misurare la rapidità di elaborazione, il tempo costituisce invece parte della proprietà indagata.
Una correlazione predittiva non equivale mai a una sentenza sul destino individuale. Se un test è associato statisticamente al rendimento scolastico, questo significa che, aggregando molte osservazioni, una quota delle differenze nei rendimenti si accompagna a differenze nei punteggi. Non implica che si possa inferire con certezza il risultato di una singola persona, né che il successo dipenda esclusivamente dalla capacità misurata. Qualità dell'insegnamento, accesso alle risorse, salute, motivazione, opportunità e sostegno sociale restano importanti. La previsione più utile è quella che dichiara il proprio margine d'errore e delimita chiaramente la popolazione alla quale si riferisce.
Tabella 10.4 — Dal risultato osservato all’interpretazione corretta
Osservazione | Inferenza possibile | Inferenza non lecita |
|---|---|---|
Alto punteggio in matrici | Buona prestazione nel compito standardizzato | Superiorità in ogni ambito della vita |
Elevato QI totale | Posizione normativa relativamente alta | Assenza di difficoltà cognitive specifiche |
Risultato migliorato al re-test | Possibile cambiamento oppure effetto della pratica | Crescita certa e permanente della capacità |
10.2 — Nascita della psicometria e standardizzazione
Agli inizi del Novecento Alfred Binet e Théodore Simon svilupparono prove per individuare bambini che avrebbero potuto beneficiare di sostegni educativi aggiuntivi. Il contesto storico è essenziale: l’obiettivo originario non era assegnare un destino intellettuale immutabile, bensì formulare una valutazione pragmatica di alcune competenze utili per l’istruzione. La successiva diffusione dei test negli Stati Uniti, le trasformazioni delle scale e l’impiego in contesti selettivi modificarono profondamente le funzioni sociali della misurazione. La storia dei test comprende progressi metodologici, ma anche gravi abusi, interpretazioni essenzialistiche e pratiche discriminatorie.
Standardizzare significa definire procedure uniformi di somministrazione, istruzioni, tempi, materiali e criteri di attribuzione del punteggio. Significa inoltre costruire norme sulla base di un campione di riferimento adatto alla popolazione per cui si desidera interpretare il risultato. Se una prova assegna 30 punti a una persona, il numero grezzo dice poco finché non conosciamo distribuzione, età di riferimento, versione del test e finalità della valutazione. Un campione normativo non rappresentativo può produrre interpretazioni sistematicamente distorte anche quando il sistema di correzione appare preciso.
Il quoziente intellettivo storico, ottenuto come rapporto fra età mentale ed età cronologica, è stato per lo più sostituito dal QI di deviazione. In molte scale contemporanee la media normativa è 100 e la deviazione standard 15. Per esempio, un punteggio di 115 corrisponde a una deviazione standard sopra la media del riferimento; non significa che la persona possieda il 15% di intelligenza in più. I punti sono unità convenzionali di una distribuzione standardizzata, non quantità fisiche di capacità. La comparazione fra gruppi o epoche richiede attenzione agli aggiornamenti delle norme e alla comparabilità dei test.
10.2.1 — La nascita dei test e la separazione tra diagnosi educativa e classificazione sociale
La ricostruzione storica delle scale cognitive mostra che gli strumenti non nascono al di fuori della società. Le prime prove di Binet e Simon si collocano in una fase in cui i sistemi scolastici cercavano procedure più sistematiche per identificare bambini bisognosi di sostegno. In tale contesto, trasformare una difficoltà osservata dall'insegnante in una serie di compiti comparabili rappresentava un progresso rispetto al giudizio puramente impressionistico. Ma lo stesso strumento, impiegato per selezionare, escludere o gerarchizzare le persone, può assumere una funzione eticamente molto diversa. La bontà tecnica di una misura non fornisce da sola una giustificazione morale dei suoi usi.
Nel Novecento alcuni programmi di valutazione attribuirono alle differenze di punteggio significati biologici e sociali sproporzionati rispetto alle prove disponibili. Il problema non consistette soltanto in errori statistici, ma nel passaggio illegittimo da una differenza media osservata a un giudizio globale sul valore di persone o gruppi. Le interpretazioni furono talvolta intrecciate con ideologie eugenetiche e pratiche discriminatorie. Una storia scientificamente seria deve analizzare questi episodi senza negare i progressi della misurazione, perché le conquiste metodologiche e gli abusi istituzionali possono coesistere. Il criterio contemporaneo non è eliminare la misurazione, ma renderla verificabile, proporzionata allo scopo e sottoposta a controllo etico.
Le scale moderne derivano da un processo di standardizzazione che va molto oltre la scelta delle domande. Occorre fissare istruzioni e procedure, sperimentare gli item, eliminare quelli poco informativi, verificare attendibilità e struttura interna, raccogliere norme adeguate e documentare le condizioni di interpretazione. Per la maggior parte dei test professionali sono previste qualifiche di utilizzo: la loro somministrazione da parte di personale non formato può produrre errori che nessuna tabella normativa è in grado di correggere. Il manuale tecnico del test è parte integrante dello strumento e deve essere consultato prima di ricavare conclusioni da un singolo punteggio.
10.2.2 — Norme, percentili e trasformazioni standardizzate
Si immagini una distribuzione di punteggi grezzi con media 42 e deviazione standard 8. Una persona ottiene 54: il suo punteggio standard z è uguale a (54 − 42) / 8 = 1,5. Se, per puro esercizio, trasformiamo questo valore sulla scala con media 100 e deviazione standard 15, otteniamo 122,5. Non si tratta automaticamente di un QI clinico: abbiamo eseguito soltanto una trasformazione lineare. Per ottenere un QI validamente interpretabile servirebbe un test standardizzato, un campione normativo adeguato e una procedura di conversione autorizzata. La distinzione è decisiva perché una formula corretta non garantisce che le premesse psicometriche siano rispettate.
In una distribuzione normale teorica, un valore z di 1,5 corrisponde approssimativamente al percentile 93. Il percentile esprime la posizione relativa rispetto al gruppo normativo: in un modello continuo indica la percentuale di valori non superiori a quel livello. Non significa avere risolto correttamente il 93% delle domande, né possedere il 93% della capacità massima immaginabile. Una persona che si trovi al percentile 93 in una prova di ragionamento potrebbe avere un profilo differente nel lessico o nella memoria di lavoro. Il percentile non deve essere convertito in un voto scolastico, perché i due strumenti rispondono a criteri diversi.
Le norme hanno una data e una geografia. Se la prestazione media su certi tipi di prova cambia nel tempo, l'interpretazione del medesimo punteggio grezzo cambia quando si aggiorna la popolazione di riferimento. Anche una norma costruita con un campione numeroso può essere inadatta a una regione, fascia di età, lingua o situazione clinica che non sia stata sufficientemente rappresentata. La scelta del gruppo normativo è pertanto un'ipotesi scientifica e pratica da motivare. Non bisogna confondere la precisione della trasformazione numerica con la precisione dell'interpretazione clinica.
10.2.3 — L'effetto Flynn e il significato dei cambiamenti storici
Nel corso del Novecento, numerose popolazioni hanno mostrato aumenti di prestazione in alcuni test cognitivi rispetto a coorti precedenti. Questo fenomeno è comunemente chiamato effetto Flynn. La sua entità dipende dal paese, dalla generazione e dal dominio misurato; inoltre, in alcune popolazioni e periodi si sono osservati rallentamenti o inversioni. Sarebbe quindi scorretto parlare di una crescita universale, continua e identica dell'intelligenza. La ricerca distingue l'aumento nei risultati standardizzati dal problema più difficile di sapere quali processi cognitivi e culturali siano cambiati.
Tra le spiegazioni proposte compaiono miglioramenti della nutrizione e della salute, espansione della scuola, maggiore familiarità con rappresentazioni astratte, riduzione di alcuni svantaggi ambientali e trasformazioni delle richieste cognitive quotidiane. Nessuna ipotesi, da sola, spiega necessariamente tutti i risultati. Alcune abilità e prove mostrano cambiamenti più marcati di altre, e un ambiente che favorisce la classificazione simbolica può migliorare prestazioni in compiti astratti senza produrre incrementi omogenei in ogni capacità. È più corretto analizzare le prove e le coorti nello specifico che immaginare un «aumento del cervello» come causa unica.
L'effetto Flynn costituisce anche un esperimento naturale sulla plasticità delle prestazioni cognitive. Cambiamenti storici relativamente rapidi possono alterare le distribuzioni dei punteggi, mentre la composizione genetica di una popolazione non cambia su quella stessa scala temporale in modo tale da spiegare, da sola, un simile fenomeno. Questo non elimina i contributi genetici alle differenze individuali entro un periodo storico. Mostra però perché la variazione all'interno di una popolazione e i cambiamenti tra generazioni debbano essere tenuti concettualmente distinti.
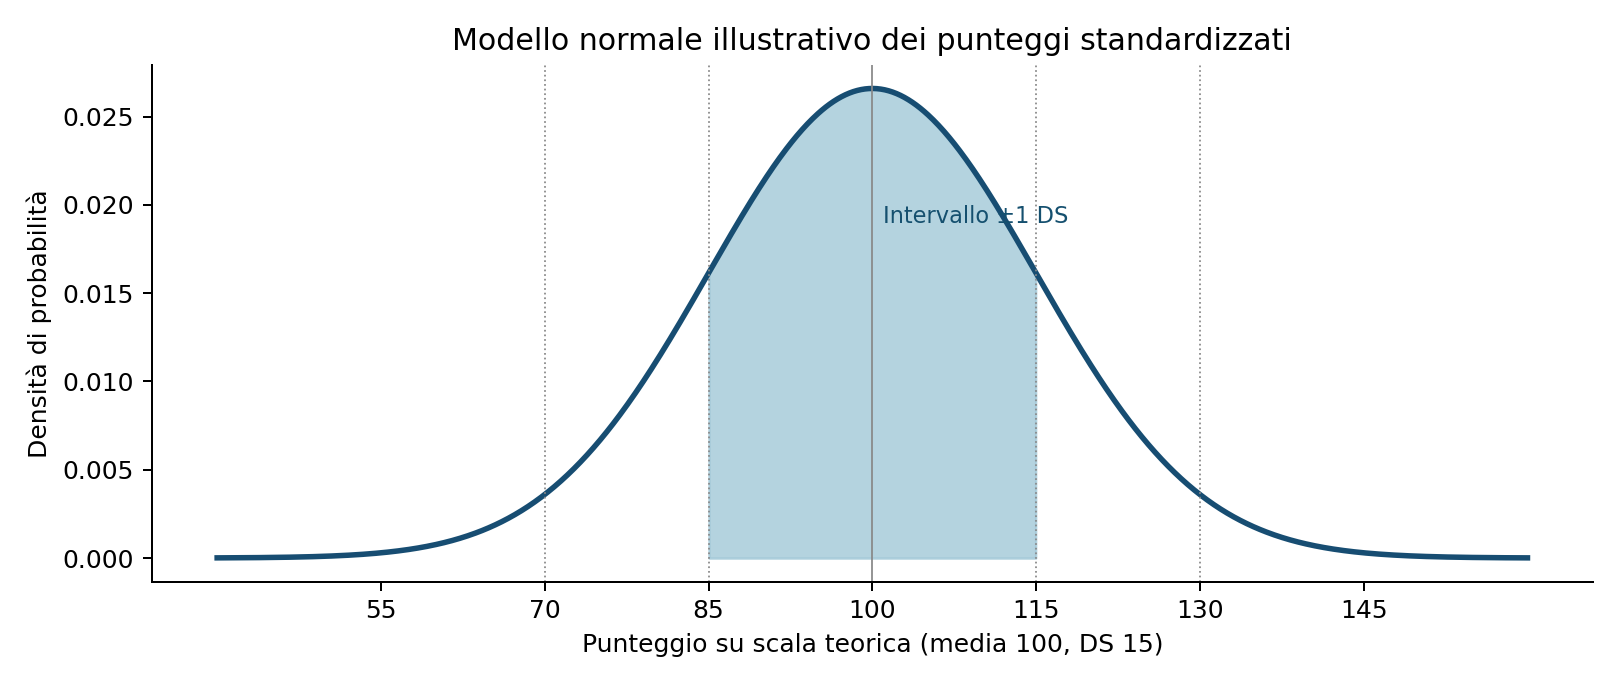
Tabella 10.5 — Conversioni didattiche in una scala con media 100 e DS 15
z | Punteggio trasformato | Lettura appropriata |
|---|---|---|
−2 | 70 | Due deviazioni sotto la media teorica |
−1 | 85 | Una deviazione sotto la media teorica |
0 | 100 | Centro della scala teorica |
+1 | 115 | Una deviazione sopra la media teorica |
+2 | 130 | Due deviazioni sopra la media teorica |
10.3 — Il fattore g e i modelli gerarchici
Charles Spearman propose di descrivere le correlazioni positive fra prove attraverso un fattore comune, g, e componenti specifiche. Il modello aveva una funzione economica: anziché trattare decine di correlazioni come fenomeni scollegati, ricercava una dimensione condivisa. L’analisi fattoriale consente di stimare strutture latenti a partire dalle covariazioni; non osserva però direttamente g nel cervello. Una rappresentazione fattoriale può adattarsi bene ai dati pur lasciando aperte le questioni relative ai processi cognitivi da cui quelle covariazioni derivano.
Modelli successivi hanno articolato la struttura delle capacità in diversi livelli. La prospettiva gerarchica di John Carroll distingue abilità ristrette, abilità ampie e una dimensione generale al vertice. Le tradizioni associate a Raymond Cattell e John Horn hanno distinto forme importanti di elaborazione e conoscenza, ma non sono perfettamente sovrapponibili alla lettura di Carroll: perfino l’etichetta CHC, frequentemente presentata come teoria unitaria, indica meglio una famiglia di modelli storicamente intrecciati e non priva di divergenze. La discussione su un fattore generale di vertice rimane significativa nella ricerca teorica.
Gli approcci alternativi evidenziano reti di processi che si influenzano reciprocamente nel corso dello sviluppo oppure distinguono attitudini e risorse cognitive con criteri differenti. Una teoria scientifica utile deve produrre previsioni controllabili, specificare le condizioni in cui i dati la metterebbero in difficoltà e confrontarsi con modelli concorrenti. L’attrattiva intuitiva di una proposta sulle intelligenze multiple, per esempio, non basta a dimostrarne l’indipendenza psicometrica: le evidenze a favore di abilità differenziate non equivalgono automaticamente all’esistenza di intelligenze autonome e separate.
10.3.1 — Dalla matrice delle correlazioni ai fattori latenti
Supponiamo di somministrare a molte persone quattro prove: ragionamento verbale, matrici astratte, memoria di lavoro e velocità di elaborazione. Se tutte le correlazioni fossero positive, potremmo cercare un fattore generale capace di rappresentare una parte della covariazione. La matrice delle correlazioni è il punto di partenza: contiene associazioni osservate, mentre il fattore è una variabile latente, cioè non osservata direttamente, inferita da un modello statistico. La presenza di un fattore generale non afferma che ogni abilità sia la stessa cosa, né che tutte le correlazioni abbiano uguale intensità. Le differenze residue possono essere modellate attraverso fattori specifici o errori di misura.
Un modello fattoriale può essere espresso, in forma semplificata, come Xᵢ = λᵢF + εᵢ. Qui Xᵢ rappresenta il risultato standardizzato nella prova i, F è la variabile latente comune, λᵢ è il caricamento del fattore e εᵢ comprende ciò che il modello non spiega con F. Il caricamento non equivale alla percentuale di intelligenza che si trova nel compito; esprime, secondo le ipotesi del modello, quanto quella variabile osservata è connessa al fattore. Quando sono presenti più fattori, la struttura diventa più articolata. Un valore elevato di adattamento ai dati non dimostra che il modello descriva un unico meccanismo causale: modelli diversi possono produrre covarianze simili.
La distinzione tra analisi esplorativa e confermativa è utile. Nell'analisi fattoriale esplorativa si cerca una struttura plausibile lasciando relativamente aperto il numero e il significato dei fattori. Nell'analisi confermativa si valuta una struttura specificata in anticipo confrontandola con i dati. In entrambi i casi contano la numerosità e la rappresentatività del campione, il tipo di prove impiegate, le assunzioni statistiche, gli indici di adattamento e la stabilità dei risultati in campioni indipendenti. Interpretare un fattore come se fosse una parte del cervello semplicemente perché ha un nome sarebbe un errore categoriale.
10.3.2 — Modelli gerarchici, CHC e interpretazione delle abilità
Nei modelli gerarchici le prove più specifiche sono raggruppate in abilità ampie, e queste possono condividere una componente ancora più generale. Per esempio, più compiti che richiedono memoria a breve termine possono essere associati a un fattore di memoria di lavoro; più attività che richiedono trattamento rapido di stimoli semplici possono riferirsi alla velocità di elaborazione. La gerarchia descrive la struttura delle differenze individuali nel campione e rende più efficiente la sintesi dei risultati. Ma l'interpretazione di ogni livello richiede cautela: due persone con uguale risultato complessivo possono ottenere combinazioni diverse di punteggi nelle abilità ampie.
La tradizione Cattell-Horn-Carroll, spesso abbreviata CHC, è particolarmente influente nella costruzione di batterie cognitive, ma l'acronimo non identifica una teoria immutabile condivisa in ogni dettaglio. Raymond Cattell aveva sviluppato la distinzione tra capacità fluide e cristallizzate; John Horn contribuì a espandere il numero delle capacità ampie; John Carroll propose una struttura gerarchica a tre strati. Le versioni contemporanee integrano elementi di queste tradizioni, pur mantenendo discussioni su numero, confini e struttura superiore dei fattori. L'esistenza di una classificazione psicometrica utile non impone una sola classificazione dei meccanismi cognitivi.
In un contesto educativo, un profilo ampio può aiutare a formulare ipotesi su difficoltà specifiche e punti di forza. Tuttavia un intervento didattico non dovrebbe essere scelto esclusivamente sulla base del nome di un indice. Bisogna mostrare che la differenza fra indici sia sufficientemente attendibile e che l'intervento proposto abbia dimostrato benefici pertinenti. Non è sufficiente raggruppare allievi in tipi cognitivi e applicare un insegnamento rigidamente «adattato al loro stile»: molte versioni popolari dell'ipotesi degli stili di apprendimento non hanno solide evidenze sperimentali per l'efficacia dell'abbinamento fra stile dichiarato e metodo di insegnamento.
10.3.3 — Intelligenze multiple e altre teorie: quale prova serve?
Alcune teorie distinguono molte forme di intelligenza, assegnando un ruolo autonomo a competenze linguistiche, spaziali, musicali, interpersonali o corporee. La proposta può avere una funzione educativa: ricorda che il successo nella vita e le qualità di una persona non si esauriscono nel rendimento a una prova cognitiva standardizzata. Come teoria psicometrica, però, richiederebbe di identificare dimensioni sufficientemente indipendenti, costruire misure attendibili e verificare previsioni che i modelli concorrenti non producono altrettanto bene. La diversità delle abilità è un fatto; l'autonomia statistica e biologica di presunte «intelligenze» distinte è un'affermazione ulteriore.
Una distinzione simile riguarda la cosiddetta intelligenza emotiva. Se con questo termine si indicano abilità nel riconoscere informazioni emotive, comprendere situazioni sociali e regolare gli stati affettivi, esistono domande scientifiche legittime e procedure di valutazione. Tuttavia gli strumenti che chiedono alla persona di descrivere se stessa misurano spesso un insieme di tratti, preferenze e giudizi su di sé, diverso dalle prove di prestazione. Chiamare entrambe le cose «intelligenza emotiva» può creare equivoci. È necessario specificare se si parla di abilità verificabile, comportamento abituale o rappresentazione che l'individuo ha di sé, e valutare quanto la misura aggiunga rispetto a costrutti già noti.
L'utilità scientifica di una teoria non è proporzionale al numero di categorie che propone né alla loro immediatezza intuitiva. Una buona teoria rischia di essere contraddetta dai dati: per esempio, formula previsioni su quali prove devono correlare, come cambiano le capacità durante lo sviluppo o quale abilità dovrebbe migliorare dopo un intervento. Dove mancano tali previsioni o gli strumenti di verifica, è opportuno parlare di schema descrittivo o di ipotesi educative piuttosto che di modello consolidato della struttura dell'intelligenza.
## 10.4.1 — Ragionamento su problemi nuovi: oltre l'idea di un talento astratto
La distinzione fra abilità fluide e cristallizzate non equivale alla separazione fra «intelligenza pura» e cultura. Una matrice visiva riduce il peso del vocabolario, ma non elimina l'influenza delle esperienze. Riconoscere progressioni logiche, confrontare figure e monitorare ipotesi richiede procedure cognitive che possono essere affinate con la pratica. Allo stesso tempo il possesso di conoscenze consente spesso di risolvere problemi che sembrerebbero nuovi senza dover ripercorrere tutti i passaggi di ragionamento. Un ingegnere esperto può individuare rapidamente un errore in un disegno tecnico grazie a schemi appresi; un principiante, pur dotato di elevata capacità di ragionamento, deve ricostruire da zero gli stessi rapporti. La competenza nasce quindi dall'interazione tra risorse cognitive relativamente generali e organizzazione della conoscenza.
La memoria di lavoro, cioè il sistema di mantenimento e manipolazione temporanea di informazioni necessarie a un compito, contribuisce a molte prove di ragionamento. Quando una regola deve essere confrontata con varie alternative, il soggetto deve conservarla abbastanza a lungo da verificare ciascun candidato, scartare le possibilità incongruenti e aggiornare le conclusioni. Tuttavia memoria di lavoro e ragionamento non sono sinonimi: prove progettate per una funzione possono coinvolgere processi molteplici. La difficoltà aumenta quando si richiede di coordinare più relazioni simultaneamente o di inibire una risposta immediata ma errata. Per comprendere la prestazione non basta sapere se la risposta finale è corretta; è utile osservare tempi, errori sistematici e strategie.
Immaginiamo che un alunno risolva un problema di proporzionalità senza conoscere formalmente il linguaggio delle equazioni. Potrebbe usare una rappresentazione grafica, ricorrere a tentativi ordinati oppure individuare intuitivamente una relazione moltiplicativa. Tutte e tre le strategie possono condurre allo stesso risultato, ma impegnano combinazioni differenti di conoscenze e controllo cognitivo. Un test di ragionamento che assegni un solo punto alla risposta corretta tende a perdere questa ricchezza processuale, mentre un'analisi qualitativa da sola potrebbe risultare difficile da standardizzare. L'integrazione fra misurazione quantitativa e studio dei processi consente di comprendere meglio che cosa i punteggi sintetizzano.
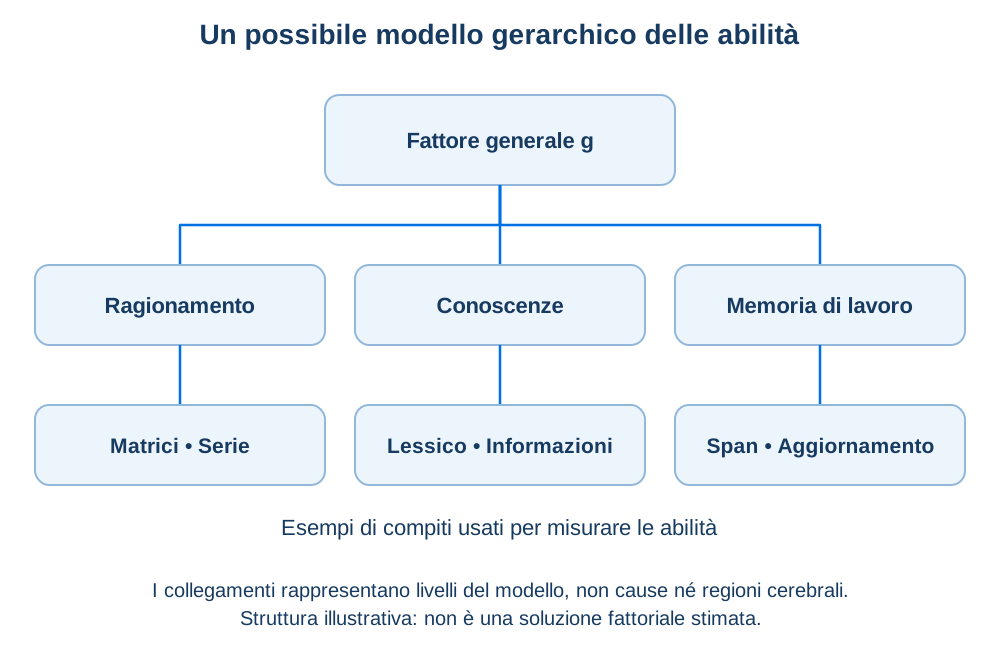
Tabella 10.6 — Livelli e interpretazioni dei modelli delle abilità
Livello | Esempio | Domanda scientifica |
|---|---|---|
Prova specifica | Memorizzare una sequenza | Quali processi richiede il compito? |
Abilità ampia | Memoria di lavoro | Quanto condividono prove affini? |
Fattore generale | g | Quale covariazione resta fra domini? |
10.4 — Intelligenza fluida e cristallizzata
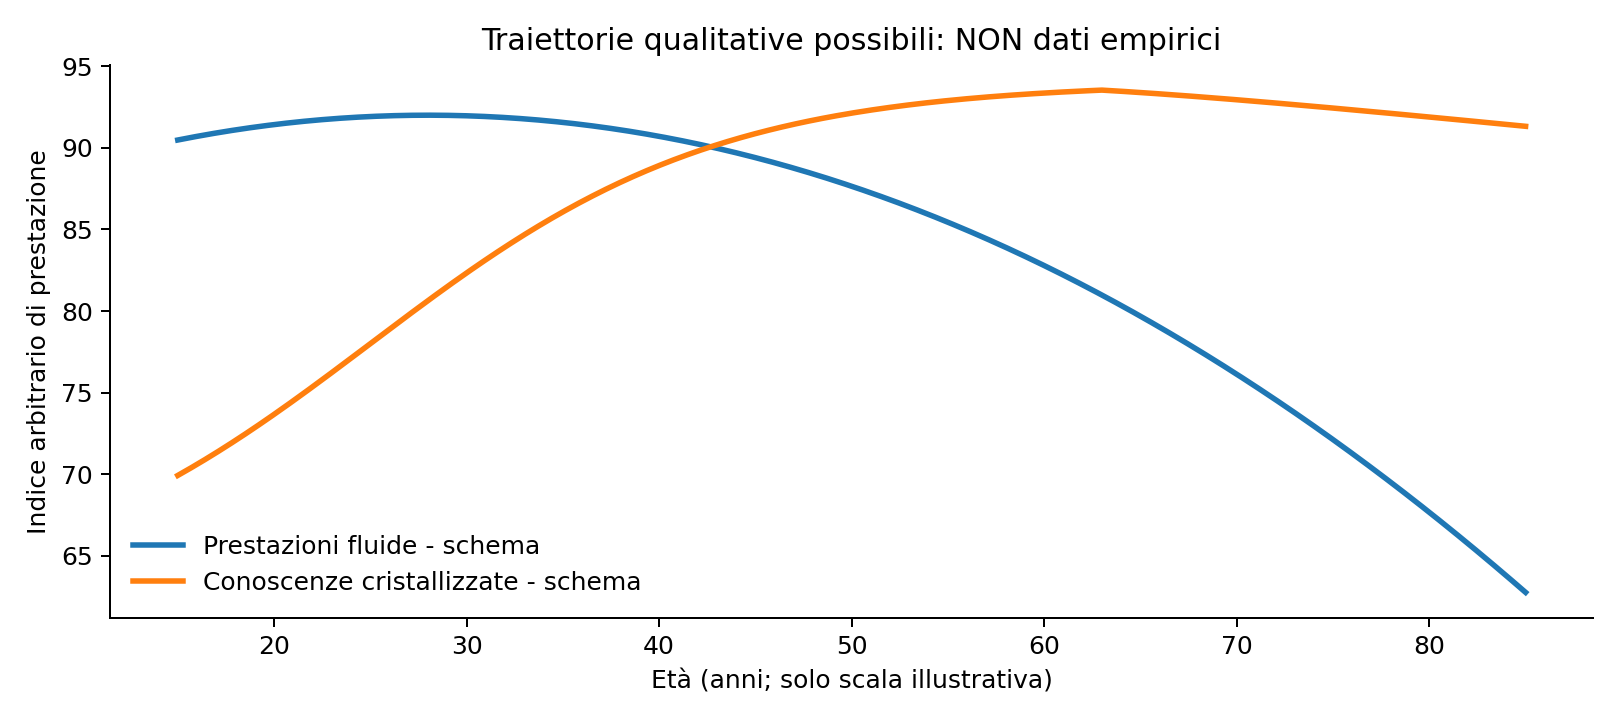
Per intelligenza fluida si intende comunemente la capacità di ragionare di fronte a problemi relativamente nuovi e di cogliere relazioni quando la soluzione non dipende soprattutto da conoscenze già apprese. L’intelligenza cristallizzata riguarda maggiormente il patrimonio di conoscenze e abilità costruito attraverso istruzione ed esperienza, come vocabolario e informazioni culturali. Le due componenti non costituiscono compartimenti indipendenti: il ragionamento influenza ciò che si impara e le conoscenze pregresse possono facilitare la soluzione di problemi nuovi.
Un esercizio con matrici astratte può richiedere di riconoscere una progressione senza utilizzare parole specialistiche; ma persino tale compito risente dell’abitudine a prove analoghe, delle strategie e delle istruzioni. Analogamente una prova di lessico, che sembra misurare conoscenza acquisita, richiede attenzione, recupero dalla memoria e capacità di gestire le richieste. È quindi utile pensare alle dimensioni fluida e cristallizzata come fattori che descrivono prevalenze di processi, non come etichette che classificano perfettamente ogni compito.
Nel corso della vita alcune capacità di ragionamento rapido possono mostrare tendenze diverse dalle abilità basate sulla conoscenza. Tuttavia le curve di età dipendono da campionamento, coorte, salute, scolarità e pratiche professionali. Se confrontiamo individui di età differenti in una sola occasione non sappiamo quanto delle differenze provenga dall’invecchiamento e quanto dalle esperienze storiche diverse. Studi longitudinali e sequenziali aiutano a separare almeno parzialmente queste spiegazioni, pur dovendo affrontare abbandoni, effetti della ripetizione delle prove e selezione dei partecipanti.
10.4.2 — Le traiettorie nell'arco della vita
Durante l'infanzia e l'adolescenza, molte competenze cognitive cambiano rapidamente per effetto congiunto di maturazione, istruzione, pratica e trasformazioni delle richieste ambientali. Nell'età adulta e nell'invecchiamento, le abilità non seguono tutte la stessa traiettoria. In media alcune prestazioni legate alla rapidità di elaborazione e al ragionamento su materiale poco familiare raggiungono il massimo relativamente presto e poi possono ridursi; conoscenze linguistiche e competenze culturalmente accumulate si mantengono spesso più a lungo. Si tratta di tendenze aggregate, non di un calendario rigido applicabile a ogni persona. Salute, istruzione, lavoro svolto, stimolazione ambientale e opportunità di compensazione modificano i profili individuali.
Confrontare giovani e anziani in una singola rilevazione non è equivalente a seguire le stesse persone per decenni. Lo studio trasversale mette a confronto coorti che hanno vissuto in epoche diverse, mentre quello longitudinale osserva cambiamenti entro individui ma può risentire di abbandoni selettivi e della familiarità crescente con le prove ripetute. I disegni sequenziali, combinando più coorti e misurazioni, tentano di separare queste componenti. Quando una ricerca annuncia che una certa abilità «declina con l'età», bisogna domandarsi quale disegno abbia utilizzato e se abbia considerato l'effetto della generazione e della salute. La stessa conclusione potrebbe cambiare in modo sostanziale dopo una diversa correzione di queste fonti di variazione.
Le competenze professionali costituiscono un esempio di compensazione. Un operatore esperto può mantenere una prestazione eccellente grazie a conoscenze, automatismi e strategie che riducono il carico di memoria di lavoro, anche se alcuni processi elementari risultano più lenti. Ciò non significa negare il cambiamento cognitivo; significa comprenderlo come un fenomeno multidimensionale, in cui l'esito di un'attività dipende tanto dai processi di base quanto dalla struttura delle conoscenze e dall'adattamento delle pratiche. Anche il concetto di «invecchiamento cognitivo» richiede perciò precisione: un punteggio totale non descrive l'intero funzionamento mentale nella vita quotidiana.
10.4.3 — Conoscenza, competenza e trasferimento
Una distinzione cruciale riguarda il trasferimento dell'apprendimento. Si parla di trasferimento vicino quando un miglioramento si estende a compiti simili a quelli esercitati; di trasferimento lontano quando riguarda attività di natura diversa. Esercitarsi con matrici può rendere più rapidi nel riconoscere trasformazioni di figure; non ne segue che aumentino in ugual misura comprensione del testo, pianificazione economica e capacità di prendere decisioni in situazioni reali. Le persone apprendono spesso regole e strategie dipendenti dal contesto, e la loro generalizzazione richiede condizioni precise.
Il ruolo della conoscenza consolidata è evidente nella soluzione dei problemi complessi. Un medico che interpreta un caso non utilizza soltanto ragionamento astratto: richiama strutture causali, diagnosi differenziali e vincoli appresi. Un economista che analizza un mercato impiega strumenti matematici, esperienza sui dati e modelli istituzionali. In entrambi i casi le capacità cognitive generali possono facilitare l'acquisizione di competenze, ma la padronanza di un dominio non è riducibile a una graduatoria psicometrica. Un percorso educativo efficace deve coltivare sia conoscenze organizzate sia procedure per applicarle in nuovi contesti.
10.5 — Attendibilità, validità e interpretazione del QI
L’attendibilità indica quanto una procedura restituisca risultati sufficientemente coerenti rispetto alle condizioni rilevanti. Una prova può avere buona consistenza interna quando gli item concorrono in modo appropriato a misurare una dimensione; può mostrare stabilità test-retest quando somministrazioni ripetute producono risultati compatibili. Le diverse stime rispondono a domande diverse e nessuna garantisce da sola che il test misuri il costrutto desiderato. Una bilancia sempre tarata con due chilogrammi di errore è ripetibile, ma non accurata: l’analogia serve a mostrare il limite logico dell’affidabilità isolata.
La validità non è un’etichetta posseduta una volta per tutte dallo strumento. Riguarda la qualità delle evidenze a sostegno delle interpretazioni e degli usi del punteggio: struttura interna, relazioni con criteri esterni, processi di risposta, contenuto e conseguenze della valutazione. Un test può risultare utile per prevedere il rendimento in un determinato contesto e inadatto a prendere decisioni cliniche individuali. Allo stesso modo, predire in media un esito futuro non equivale a determinare il percorso di una singola persona. Lo scopo per cui viene utilizzato un numero è parte della sua valutazione.
Ogni punteggio individuale contiene incertezza di misura. Il professionista non dovrebbe leggere un risultato come una quantità perfettamente esatta, ma considerare gli intervalli di confidenza forniti dall’interpretazione psicometrica appropriata. L’errore standard di misura può essere illustrato, sotto ipotesi classiche, con SEM = SD × √(1−r), dove SD è la deviazione standard dei punteggi e r una stima appropriata dell’attendibilità. Se SD vale 15 e r vale 0,90, il SEM illustrativo è circa 4,74 punti. Non bisogna trasformare meccanicamente questo esempio in un intervallo clinico universale: distribuzione degli errori, metodo di stima e manuale del test contano.
10.5.1 — Il modello classico del punteggio osservato
Una rappresentazione introduttiva della teoria classica dei test è X = T + E. X indica il punteggio osservato, T il punteggio vero teorico ed E la componente di errore. Il termine «vero» non identifica una quantità biologica immutabile: rappresenta, sotto specifiche ipotesi, la media attesa dei risultati in ripetizioni equivalenti della misurazione. L'errore include condizioni transitorie e fattori non sistematici che producono oscillazioni di punteggio. Nella pratica le condizioni non sono perfettamente replicabili e le persone cambiano; il modello rimane utile purché non sia interpretato in modo letterale come separazione reale fra «vera intelligenza» ed «errore».
L'attendibilità esprime la proporzione di varianza del punteggio osservato attribuibile alla componente di punteggio vero, secondo il modello pertinente. È possibile stimarla attraverso procedure differenti: ripetizione a distanza, forme parallele, coerenza fra item o accordo fra valutatori. Queste stime non sono intercambiabili, perché rispondono a domande diverse. Una prova può mostrare elevata coerenza interna e, nello stesso tempo, essere sensibile a cambiamenti di condizioni esterne; può essere stabile nel tempo ma misurare un costrutto non pertinente alla decisione che si vuole prendere. Perciò non è corretto dire che un test è «attendibile al 90%» senza specificare quale stima è stata ottenuta e su quale popolazione.
Il coefficiente alfa, spesso presentato come indice di coerenza interna, può essere influenzato dal numero degli item e dalle ipotesi sui loro rapporti. Un alfa elevato non dimostra automaticamente che il test sia unidimensionale, né garantisce l'assenza di item ridondanti. Altri coefficienti, come omega, possono essere più appropriati in certe strutture fattoriali; nessun numero singolo sostituisce l'analisi degli item, della struttura e della finalità. L'affidabilità è inoltre un requisito della validità, non un suo sinonimo: una bilancia che sovrastima sempre di due chilogrammi può essere molto coerente, ma produrre misure sistematicamente inaccurate rispetto alla proprietà d'interesse.
10.5.2 — Interpretare un punteggio con il margine d'incertezza
Prendiamo un test con deviazione standard normativa di 15 e un coefficiente di attendibilità di 0,90 appropriato all'uso previsto. Nella teoria classica l'errore standard di misura è SEM = 15 × √(1 − 0,90), cioè circa 4,74 punti. Se il punteggio osservato è 108, un intervallo puramente illustrativo costruito come 108 ± 1,96 × 4,74 ha estremi approssimativi 98,7 e 117,3. Tale calcolo richiede assunzioni precise: non sostituisce gli intervalli ufficiali del manuale, non tiene conto automaticamente di regressione verso la media e non può essere applicato a qualsiasi sottoscala usando l'attendibilità del QI totale.
L'intervallo di confidenza è spesso frainteso. Nella formulazione frequentista, il livello del 95% si riferisce alla copertura a lungo termine di una procedura in ipotetiche ripetizioni, non a una probabilità soggettiva che un punteggio vero immutabile sia «dentro» uno specifico intervallo dopo aver osservato il campione. Nella valutazione individuale, inoltre, le condizioni del modello possono essere solo approssimative. In un testo applicato è quindi corretto presentare l'intervallo come indicatore dell'incertezza della misura, accompagnandolo con una spiegazione della procedura e dei suoi limiti. Dimenticare questi limiti può trasformare piccole differenze numeriche in categorie arbitrarie.
La regressione verso la media rappresenta un ulteriore problema. Quando una persona viene selezionata perché ha ottenuto un punteggio molto estremo, un secondo risultato tende spesso a essere meno estremo anche in assenza di un intervento, soprattutto se la misurazione contiene errore. Se si offre un corso soltanto a chi ha ottenuto punteggi particolarmente bassi e poi se ne misura il miglioramento, una parte della variazione osservata può derivare da questo fenomeno statistico. Per sostenere che il corso sia efficace occorre un confronto adeguato, possibilmente con un gruppo di controllo e misure alternative. L'errore di misura ha dunque conseguenze non soltanto diagnostiche, ma anche sperimentali.
10.5.3 — Validità: un'argomentazione fondata su prove
La validità non è un timbro permanente che il costruttore applica a un test. Riguarda la solidità delle interpretazioni dei punteggi per uno scopo determinato. Una batteria può fornire misure ben supportate per descrivere certe abilità in studenti di una data fascia di età, ma non essere adatta a selezionare candidati per una professione o a valutare persone che non conoscono la lingua di somministrazione. Le evidenze di validità provengono da più direzioni: contenuto degli item, processi di risposta, struttura interna, rapporti con variabili esterne e conseguenze della decisione. Queste evidenze formano un'argomentazione, non una lista meccanica da spuntare.
La validità di contenuto chiede se i compiti rappresentano adeguatamente il dominio di abilità che vogliamo valutare. La validità basata sulle relazioni con altre variabili considera, per esempio, se il punteggio è associato a prove affini e distingue costrutti differenti. La validità predittiva esamina in quale misura i risultati anticipano esiti rilevanti, tenendo conto della base-rate, della restrizione di gamma e di variabili concorrenti. Se tutti i candidati ammessi a un corso possiedono già punteggi elevati, la correlazione fra QI e rendimento tra gli ammessi può risultare inferiore a quella osservabile nella popolazione da cui sono stati selezionati, semplicemente perché è ridotta la variabilità del predittore.
È essenziale aggiungere il criterio della proporzionalità decisionale. Un test utilizzato per orientare un percorso di sostegno educativo dovrebbe produrre informazioni utili per progettare interventi, anziché limitarsi a classificare. Un test impiegato in una decisione ad alto impatto sociale richiede prova più stringente della pertinenza, della comparabilità e delle conseguenze. Non basta che il coefficiente di correlazione con un criterio sia diverso da zero: bisogna valutarne l'entità, la precisione e il valore aggiunto rispetto a informazioni già disponibili. Un indicatore può essere statisticamente significativo e quasi irrilevante per un singolo caso.
10.5.4 — Esempio guidato: due punteggi non sempre indicano due capacità differenti
Immaginiamo che una studentessa ottenga 112 in un indice verbale e 104 in un indice visuospaziale. La differenza aritmetica è otto punti. Prima di concludere che possieda «intelligenza verbale superiore», dobbiamo sapere quali sono gli errori standard delle due misure, quanto esse correlino, quale sia la frequenza di una discrepanza simile nel campione normativo e quali siano le istruzioni per interpretare i profili nel manuale tecnico. Una differenza statisticamente attendibile può inoltre essere comune nella popolazione e non necessariamente avere significato clinico. Senza queste informazioni, otto punti costituiscono soltanto una differenza descrittiva.
La questione è particolarmente importante in ambito scolastico e clinico, dove l'attenzione agli scarti fra indici può suggerire ipotesi di intervento. È corretto usare le discrepanze come indizi da integrare con altri dati; non è corretto usarle come diagnosi autosufficienti. La stessa logica vale per confronti longitudinali: migliorare di cinque punti dopo alcuni mesi non dimostra necessariamente un cambiamento della capacità, perché occorre confrontare la differenza con l'errore, gli effetti della pratica e gli eventuali cambiamenti delle norme. La precisione numerica di un referto non deve indurre a sovrastimare la precisione concettuale della conclusione.
Tabella 10.7 — Distinzioni tecniche nella valutazione
Proprietà | Che cosa esamina | Che cosa non dimostra |
|---|---|---|
Attendibilità | Coerenza della misura | Pertinenza dello scopo |
Validità | Giustificazione delle interpretazioni | Assenza assoluta di errore |
Invarianza | Comparabilità del modello fra gruppi | Identiche distribuzioni medie |
Sensibilità al cambiamento | Capacità di rilevare variazioni pertinenti | Che il cambiamento sia causato da un intervento |
10.6 — Natura, ambiente e interazioni
Le ricerche di genetica comportamentale stimano quanto della variabilità osservata in una popolazione, in un dato contesto e momento storico, sia associata a differenze genetiche. L’ereditarietà non esprime la frazione di intelligenza di un individuo attribuibile ai geni. Per chiarire la distinzione si immagini un gruppo di piante geneticamente diverse allevate in condizioni quasi identiche: le differenze genetiche potrebbero spiegare una larga parte della variabilità osservata. Cambiando acqua, nutrimento e luce, tuttavia, le capacità di crescita dell’intera popolazione potrebbero modificarsi radicalmente. Alta ereditarietà e forte influenza ambientale non sono logicamente incompatibili.
Gli studi su gemelli e famiglie sfruttano differenti gradi di somiglianza genetica per stimare componenti di varianza, ma le inferenze dipendono da assunzioni: ambienti condivisi, assortative mating, selezione e comparabilità delle esperienze possono complicare le stime. Metodi genomici più recenti combinano informazioni da moltissime varianti genetiche per costruire punteggi poligenici; tali punteggi sono probabilistici e sensibili alla popolazione di riferimento. Non definiscono un destino individuale e non isolano automaticamente percorsi causali semplici. Il contesto sociale contribuisce a determinare quali differenze possano esprimersi.
Le interazioni gene-ambiente si verificano quando l’associazione fra una predisposizione e un risultato varia in funzione delle condizioni ambientali; le correlazioni gene-ambiente sorgono quando predisposizioni e opportunità tendono a presentarsi insieme. Un bambino particolarmente interessato alla lettura può cercare più libri, ricevere incoraggiamento o essere indirizzato a percorsi formativi avanzati. Una successiva relazione fra caratteristiche genetiche e competenze linguistiche può allora riflettere una sequenza di processi biologici, comportamentali e sociali. Non è metodologicamente corretto contrapporre natura e cultura come cause che si escludono reciprocamente.
10.6.1 — Ereditarietà della varianza: che cosa il dato può e non può dire
L'ereditarietà, nella genetica quantitativa, descrive una quota di varianza attribuibile statisticamente alle differenze genetiche in una popolazione e in condizioni specifiche. Non rappresenta la «percentuale del QI di una persona causata dai suoi geni». Se un gruppo ha condizioni di vita molto uniformi, alcune differenze ambientali possono contribuire relativamente poco alla variabilità osservata e la stima di ereditarietà può risultare elevata. Questo non dimostra che l'ambiente sia irrilevante: modificare sistematicamente nutrizione, istruzione o condizioni sanitarie potrebbe cambiare la media di tutti senza alterare in modo semplice la stima. L'ereditarietà è un concetto di variazione statistica, non una dichiarazione sull'immutabilità.
Nei modelli classici su gemelli si confronta la somiglianza tra coppie monozigoti, che condividono quasi tutto il genoma, e dizigoti, che condividono mediamente circa metà delle varianti segreganti. Modelli semplificati scompongono la varianza in componenti genetiche additive, ambientali condivise e ambientali non condivise, spesso indicate con le lettere A, C ed E. È però essenziale conoscere le ipotesi necessarie: comparabilità degli ambienti, assenza di alcuni effetti di assortimento o interazioni non modellate e adeguata qualità della misurazione. La componente E comprende spesso anche errore di misura, per cui non coincide con un elenco identificabile di esperienze individuali.
Gli studi di gemelli non sono l'unica strategia disponibile. Le ricerche su adozioni, fratelli, famiglie e dati genomici forniscono informazioni complementari, ma ciascuna presenta limiti propri. Nelle adozioni, per esempio, la collocazione delle famiglie non è necessariamente casuale e può esistere selezione; negli studi familiari, geni e ambienti sono spesso correlati. La convergenza di più disegni è più informativa del risultato di una singola classe di studi. Anche quando i contributi genetici alle differenze individuali sono robusti, resta aperta la domanda dei meccanismi specifici attraverso i quali interagiscono con lo sviluppo cerebrale e con l'esperienza.
10.6.2 — Interazioni e correlazioni fra geni e ambiente
L'interazione gene-ambiente si verifica quando l'effetto statistico di una caratteristica genetica dipende dal contesto, o quando l'effetto di un'esposizione varia in relazione alla predisposizione dell'individuo. Un esempio ipotetico può aiutare: una strategia educativa potrebbe produrre miglioramenti diversi a seconda delle conoscenze iniziali, della motivazione e di caratteristiche individuali associate a processi biologici. Il dato non autorizza a costruire categorie rigide di studenti; indica che gli effetti medi possono nascondere eterogeneità da spiegare e verificare con studi appropriati. Identificare una vera interazione richiede disegni e analisi accurati, perché le differenze di scala e alcune distorsioni statistiche possono creare interazioni apparenti.
La correlazione gene-ambiente è un fenomeno distinto. Nella forma passiva, genitori e figli condividono sia caratteristiche genetiche sia parte dell'ambiente domestico; nella forma evocativa, comportamenti individuali suscitano risposte differenti negli altri; nella forma attiva, le persone cercano ambienti coerenti con inclinazioni e interessi. Un bambino molto interessato alla lettura può scegliere spontaneamente libri, ottenere attenzioni dagli adulti e accrescere il proprio vocabolario. L'esempio non richiede un «gene della lettura»: mostra come predisposizioni iniziali, scelte ed esperienze possano alimentarsi reciprocamente. Anche un'associazione fra genotipo e risultato scolastico può riflettere, in parte, gli ambienti costruiti dalle famiglie.
Il concetto di plasticità completa il quadro. I sistemi nervosi cambiano in risposta all'esperienza per tutta la vita, pur con vincoli biologici e differenze tra periodi evolutivi. Una caratteristica può essere influenzata geneticamente e nello stesso tempo modificabile attraverso opportunità, formazione, riabilitazione o condizioni ambientali. Il falso dilemma «genetico oppure modificabile» deriva dal confondere la spiegazione delle differenze osservate con la previsione degli effetti di un intervento. La ricerca seria evita entrambe le scorciatoie, sia quella che riduce ogni differenza alla biologia sia quella che nega l'esistenza di vincoli e variazioni biologiche.
10.6.3 — Studi genomici e punteggi poligenici
Gli studi di associazione sull'intero genoma, chiamati GWAS, analizzano statisticamente moltissime varianti genetiche in grandi campioni per identificare associazioni con un tratto misurato. Nelle capacità cognitive la maggior parte dei singoli effetti individuati è piccola, e l'architettura genetica è complessa: non esiste una variante semplice che determini, da sola, il livello di intelligenza. Un punteggio poligenico combina numerose varianti, pesate in base ad associazioni stimate in campioni di ricerca, allo scopo di prevedere una piccola o moderata quota di differenze in altri campioni. La quota predetta dipende dai dati, dalla popolazione e dalla qualità dello strumento.
La capacità predittiva di un punteggio poligenico non va confusa con l'ereditarietà stimata dagli studi familiari. Una caratteristica potrebbe essere sostanzialmente ereditaria in un certo contesto e, tuttavia, essere predetta solo parzialmente dai marcatori disponibili. Inoltre, un indice costruito in un gruppo ancestrale può perdere accuratezza in altri gruppi per differenze nelle frequenze alleliche, nelle correlazioni fra varianti e negli ambienti associati. Le ricerche genomiche contemporanee evidenziano queste limitazioni e la necessità di campioni più diversificati. Applicazioni individuali ad alto impatto, specialmente su minori o decisioni educative, richiederebbero una giustificazione molto più forte di quella fornita da una correlazione di ricerca.
Il problema etico è concreto. I dati genetici possono generare rischi di privacy, stigmatizzazione e discriminazione; le previsioni probabilistiche possono essere facilmente comunicate come destini biologici. L'utilità scientifica delle analisi genomiche consiste soprattutto nel contribuire alla comprensione dei processi biologici e della variabilità, non nell'assegnare graduatorie morali fra persone. Anche le differenze genetiche statistiche tra popolazioni non forniscono, da sole, spiegazioni causali delle differenze medie osservate fra gruppi sociali: storia, selezione, contesto, misurazione e fattori ambientali devono essere studiati separatamente.
## 10.7.1 — Istruzione e capacità cognitive: perché la causalità è difficile da stabilire
Scuola e risultati ai test cognitivi sono associati, ma l'associazione da sola non stabilisce in quale direzione agisca la causalità. Una persona che apprende rapidamente può avere maggiori probabilità di proseguire gli studi, mentre gli anni di istruzione possono a loro volta sviluppare competenze di ragionamento, conoscenze, familiarità con problemi astratti e strategie esecutive. Entrambe le direzioni sono plausibili. Vi si aggiungono fattori di selezione: le famiglie possono offrire opportunità diverse, le istituzioni possono indirizzare i percorsi, e condizioni di salute o economiche possono influenzare simultaneamente durata degli studi e rendimento. Un semplice confronto fra laureati e persone con meno anni di scuola mescolerebbe tutti questi processi.
Per avvicinarsi a una stima causale, i ricercatori usano disegni quasi sperimentali. Alcuni confrontano persone con punteggi cognitivi precedenti noti e successivi percorsi scolastici differenti; altri sfruttano modifiche delle leggi sull'obbligo scolastico; altri ancora studiano studenti molto vicini a un criterio amministrativo di accesso alla scuola. Ciascun disegno introduce ipotesi proprie. Per esempio, una riforma scolastica potrebbe modificare altre opportunità contemporaneamente; il confronto intorno a una soglia potrebbe descrivere solo individui molto prossimi a quella soglia. Quando risultati provenienti da strategie differenti convergono, la conclusione è più credibile, ma gli effetti numerici possono rimanere eterogenei.
Una meta-analisi di Ritchie e Tucker-Drob ha sintetizzato 42 insiemi di dati, comprendenti oltre 600.000 partecipanti e 142 dimensioni dell'effetto, utilizzando tre classi di disegni quasi sperimentali. I risultati sono compatibili con un effetto benefico di un ulteriore anno di istruzione sulle prestazioni cognitive, con stime che variano approssimativamente da uno a cinque punti QI a seconda del disegno e delle analisi. Questa ampiezza non deve essere utilizzata come formula meccanica per il singolo individuo: non significa che uno studente guadagni necessariamente cinque punti ogni anno, né che l'effetto si sommi indefinitamente in modo lineare. Il messaggio scientificamente solido è che l'istruzione non è soltanto conseguenza delle capacità precedenti, ma può contribuire a modificarne le espressioni misurate.
Tabella 10.8 — Fonti complementari di evidenza genetica
Disegno | Contributo | Cautela interpretativa |
|---|---|---|
Gemelli | Confronto di somiglianze familiari | Assunzioni su ambienti e assortimento |
Adozioni | Informazioni da rapporti biologici e ambientali | Selezione e collocazione non casuale |
GWAS | Associazioni fra varianti e tratti | Predizione non deterministica; variabilità per popolazione |
10.7 — Scuola, povertà e opportunità
Un’istruzione di qualità non fornisce soltanto nozioni. Può allenare il ragionamento, il vocabolario, la capacità di rappresentare problemi e la familiarità con procedure cognitive complesse. Per distinguere l’effetto della scuola dal fatto che studenti già più abili tendono a proseguire gli studi, i ricercatori impiegano disegni quasi sperimentali e confronti basati su cambiamenti nelle leggi dell’obbligo scolastico o soglie di accesso. Una meta-analisi del 2018 ha rilevato effetti medi favorevoli dell’istruzione sui punteggi cognitivi, nell’ordine di alcuni punti di QI per un anno aggiuntivo, con variabilità a seconda degli studi. Il dato non autorizza a promettere lo stesso guadagno a ogni studente.
Le condizioni economiche influenzano l’apprendimento attraverso molteplici percorsi: alimentazione, qualità delle abitazioni, esposizione allo stress, salute, accesso a materiali didattici, sicurezza, tempo degli adulti e possibilità di frequentare scuole attrezzate. Nessuno di questi fattori è un destino inevitabile, ma ignorarli produce spiegazioni ingannevolmente individualistiche della performance. Anche le decisioni istituzionali su finanziamenti, insegnanti e servizi educativi cambiano le opportunità di sviluppo. Un punteggio comparabile non garantisce che due persone abbiano avuto condizioni di apprendimento comparabili.
La questione degli interventi richiede domande più precise di «la scuola rende intelligenti?»: quale intervento, per quali studenti, con quale durata, rispetto a quale alternativa e misurato dopo quanto tempo? Un programma può migliorare significativamente una competenza scolastica concreta senza produrre cambiamenti misurabili in una batteria generale, oppure mostrare effetti immediati che si riducono a distanza di mesi. Ciò non implica che l’intervento sia inutile. Occorre valutare gli obiettivi educativi pertinenti, oltre a distinguere benefici di apprendimento, prestazione al test e trasferimento a nuove situazioni.
10.7.2 — Povertà, salute e opportunità di apprendimento
La condizione socioeconomica è associata a molte variabili che incidono sull'esperienza di sviluppo: qualità dell'alimentazione, sicurezza dell'ambiente domestico, possibilità di accesso ai servizi sanitari, esposizione a inquinanti, disponibilità di materiali educativi, qualità degli istituti, stabilità abitativa e stress cronico. Queste variabili non operano necessariamente in modo indipendente. Un ambiente instabile può aumentare il carico attentivo, limitare il sonno e rendere più difficile la partecipazione regolare alle attività scolastiche; nello stesso tempo, il sostegno di adulti e insegnanti può attenuare alcuni svantaggi. La relazione tra contesto economico e risultato cognitivo è dunque un problema di sistemi interconnessi, non un semplice effetto del denaro sul cervello.
Un rischio interpretativo consiste nel descrivere persone che crescono in ambienti svantaggiati come portatrici di una carenza intrinseca. Un test può rilevare prestazioni inferiori in determinate condizioni senza chiarire quali opportunità siano mancate o quali competenze non siano state richieste dal particolare formato della prova. D'altra parte, sarebbe altrettanto scorretto attribuire automaticamente ogni differenza a un solo fattore ambientale: la variabilità individuale è reale e richiede studi specifici. Le migliori analisi cercano meccanismi modificabili e separano, per quanto possibile, confondimento, mediazione e cause dirette.
La salute precoce è un esempio di processo complesso. Alcune carenze nutrizionali e condizioni mediche possono interferire con lo sviluppo neurologico, ma non ne segue che un'integrazione alimentare aumenti indistintamente il QI di persone già adeguatamente nutrite. La qualità della prova dipende dalla presenza di un bisogno reale, dalla fase dello sviluppo, dall'intensità dell'intervento e dal suo disegno sperimentale. Più in generale, migliorare l'accesso a istruzione e cure può avere benefici importanti anche quando non è possibile attribuire un aumento esatto a un singolo indicatore psicometrico. L'intervento è giustificato anche da ragioni educative e sanitarie non riducibili al quoziente intellettivo.
10.7.3 — Capacitazione educativa e valutazione degli interventi
Se si vuole verificare un programma destinato a migliorare capacità cognitive, occorre innanzitutto specificare l'esito atteso. Aumentare il vocabolario? Rafforzare la comprensione dei testi? Ridurre le difficoltà nella memoria di lavoro durante compiti scolastici? Migliorare il ragionamento in prove non allenate? Le domande non sono intercambiabili. Un intervento può aumentare la conoscenza disciplinare, produrre benefici scolastici significativi e non modificare in maniera sensibile il QI totale. Sarebbe errato definirlo inefficace soltanto perché non ha cambiato un indicatore globale diverso dall'obiettivo originario.
Le prove migliori combinano misure prima e dopo l'intervento con gruppi di confronto credibili, valutatori il più possibile ignari della condizione e verifiche a distanza. È importante prevedere il livello iniziale dei partecipanti, la durata reale della partecipazione, le ragioni degli abbandoni e il rischio che le attività del gruppo sperimentale siano più motivanti semplicemente perché nuove. Dove non sia possibile randomizzare, conviene utilizzare strategie alternative di inferenza causale e dichiararne i limiti. In particolare, scegliere soltanto studenti con risultati iniziali eccezionalmente bassi può generare miglioramenti apparenti per regressione verso la media.
Una pedagogia informata dalla ricerca non implica dividere definitivamente gli studenti in «capaci» e «incapaci». Può invece offrire strumenti graduati, feedback specifico, recupero attivo delle informazioni, pratica distribuita e opportunità crescenti di autonomia. Le differenze nel livello iniziale sono importanti per progettare il sostegno, ma non definiscono un limite massimo immutabile. Il risultato educativo più ambizioso non è attribuire un'etichetta definitiva, bensì creare condizioni nelle quali persone diverse possano apprendere e dimostrare ciò che hanno appreso.
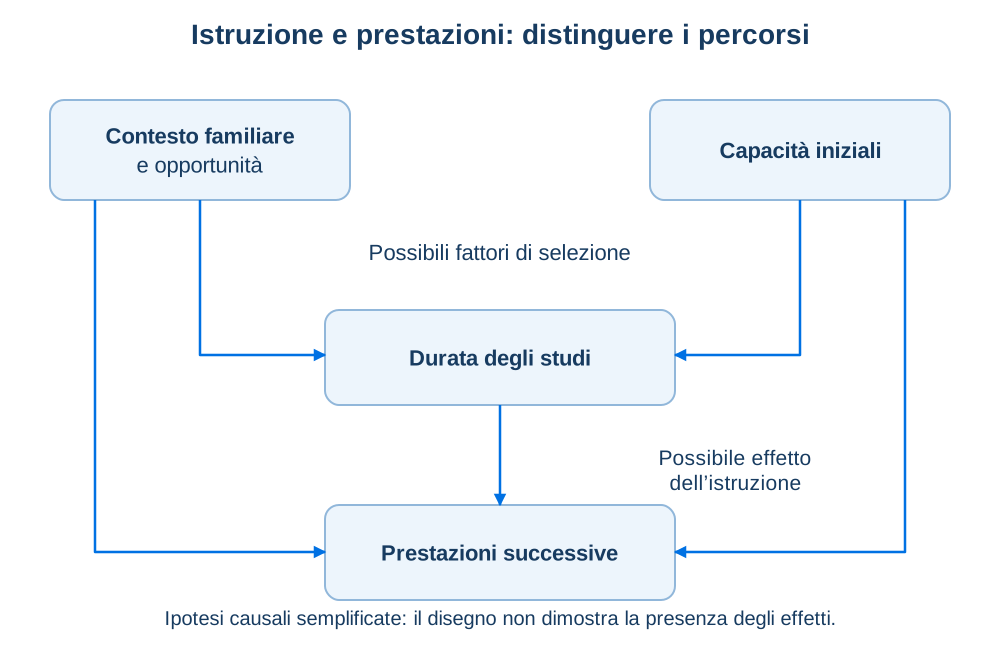
Tabella 10.9 — Strategie di ricerca sull’effetto dell’istruzione
Disegno | Strategia | Limite |
|---|---|---|
Punteggi precedenti | Controllo statistico della capacità iniziale | Possibile confondimento residuo |
Riforma dell’obbligo | Variazione istituzionale nella scolarizzazione | Possibili altri cambiamenti contemporanei |
Soglia d’ingresso | Confronto attorno a un criterio | Effetto locale, non sempre generalizzabile |
10.8 — Culture, equità di misura e differenze tra gruppi
Le prove cognitive vengono svolte da persone con storie linguistiche, culturali e formative differenti. Un item può apparire neutrale al ricercatore e richiedere invece conoscenze o convenzioni comunicative meno familiari ad altri partecipanti. La correttezza di una valutazione implica chiedersi se lo stesso punteggio abbia un significato comparabile nei gruppi esaminati. Il funzionamento differenziale degli item e le analisi di invarianza di misura offrono strumenti per studiare alcune di queste questioni, ma l’equità non si riduce a un singolo indicatore statistico: comprende accesso, condizioni di prova, uso dei risultati e possibili effetti discriminatori.
Quando si osserva una differenza media fra due gruppi, bisogna distinguere almeno tre livelli: l’esistenza statistica di una differenza nella popolazione campionata, l’identificazione dei processi che la producono e la valutazione delle sue implicazioni pratiche. La prima non dimostra la seconda. Differenze medie non annullano la sovrapposizione delle distribuzioni individuali, spesso considerevole, e non permettono di descrivere una persona tramite una media del gruppo. Confondere categorie sociali, origini ancestrali, caratteristiche genetiche e opportunità ambientali è uno dei più seri errori possibili in questo campo.
La storia della psicometria mostra anche come risultati numerici siano stati impiegati per legittimare gerarchie sociali preesistenti. Il compito della ricerca contemporanea non consiste nel rifiutare la misurazione per paura delle sue applicazioni, bensì nel esplicitare cosa il dato permette di concludere e cosa rimane ignoto, evitando determinismo e inferenze causali non giustificate. Il linguaggio scientifico deve separare differenze osservate, ipotesi sui meccanismi e decisioni normative. L’eguaglianza di dignità e diritti non dipende da un punteggio cognitivo né richiede che tutti ottengano risultati uguali.
10.8.1 — Un confronto equo non si esaurisce nella traduzione linguistica
Un test può essere corretto grammaticalmente e tuttavia risultare non equivalente fra popolazioni. Parole di uso comune in un ambiente possono essere rare in un altro; determinati oggetti, formati grafici o procedure di risposta possono risultare familiari a un gruppo e meno familiari a un altro. Quando il contenuto culturale non è pertinente all'abilità misurata, genera una fonte di variazione estranea al costrutto. Ma eliminare il linguaggio non è sempre sufficiente: le differenze nell'esperienza con prove astratte, nell'uso della tastiera, nel ritmo delle interazioni o nella familiarità con esami a tempo possono influenzare anche compiti «non verbali».
La psicometria dispone di strumenti per indagare la comparabilità. L'invarianza di misura valuta, all'interno di un modello, se item e fattori mantengono rapporti sufficientemente simili in gruppi differenti. Il funzionamento differenziale dell'item, o DIF, si verifica quando, a parità del livello del tratto stimato, un item ha probabilità di risposta differenti nei gruppi. Un item con DIF richiede indagine, ma non dimostra sempre da solo una discriminazione intenzionale; può riflettere strategie, contenuti o differenze reali nel sottodominio richiesto. La ricerca deve chiarire se il comportamento dell'item è pertinente al costrutto oppure introdotto da caratteristiche estranee.
L'equità riguarda anche le condizioni di utilizzo. Un sistema di selezione può impiegare un test strutturalmente valido ma applicarlo con soglie arbitrarie, senza considerare condizioni di disabilità o differenze linguistiche, e produrre decisioni ingiustificate. I principi contemporanei di valutazione richiedono quindi di considerare attendibilità, validità, accessibilità e conseguenze. Nessuna di queste dimensioni elimina le altre. Una procedura equa mira a ottenere informazioni comparabili per lo scopo definito, non a forzare artificialmente la stessa distribuzione di punteggi in tutti i gruppi.
10.8.2 — Differenze individuali e medie dei gruppi: due livelli distinti
Le distribuzioni dei risultati cognitivi possono differire per molti motivi, e confrontare le medie rappresenta soltanto l'inizio dell'analisi. Una differenza media non dice nulla, da sola, sulla capacità di un individuo scelto a caso. Quando due gruppi hanno distribuzioni largamente sovrapposte, molte persone del gruppo con media inferiore possono superare molte persone del gruppo con media superiore. Anche quando una differenza è statisticamente attendibile, la sua interpretazione richiede dimensioni dell'effetto, variabilità interna, criteri di campionamento e condizioni di somministrazione. Presentare soltanto le medie può quindi creare un'impressione fuorviante della separazione tra persone.
Un errore frequente consiste nel trasferire al confronto fra gruppi una stima di ereditarietà ricavata all'interno di uno di essi. Anche se le differenze individuali in una popolazione fossero in parte spiegate statisticamente da varianti genetiche, ciò non identificherebbe la causa della differenza fra due popolazioni. È un problema logico simile a quello delle piante: all'interno di ciascun vaso, alcune differenze di altezza possono dipendere dalla genetica; la differenza media tra vasi, se ricevono quantità diverse d'acqua, può essere ambientale. L'analogia illustra il principio, senza pretendere di rappresentare la complessità genetica e sociale degli esseri umani.
Le categorie sociali non devono essere scambiate per unità biologiche naturali con confini netti. Lingua, storia migratoria, istruzione, discriminazione e condizioni economiche possono differire in modo sistematico fra gruppi e incidere sulle prestazioni o sulla loro misurazione. Analizzare questi fattori non significa presumere che tutte le differenze derivino da un'unica causa ambientale; significa evitare inferenze che i dati non consentono. Per descrivere le differenze umane con rigore, la ricerca deve mettere al centro il contesto e utilizzare categorie definite con precisione, sapendo che nessuna etichetta demografica esaurisce la variabilità individuale.
10.8.3 — Neurodiversità, disabilità e limiti degli indici aggregati
Nelle persone neurodivergenti, in quelle con disabilità sensoriali o motorie e in individui con storie linguistiche particolari, la struttura delle prestazioni può essere particolarmente eterogenea. Un QI totale può restare informativo per determinati scopi, ma risultare poco descrittivo quando tra i diversi indici compaiono discrepanze marcate e attendibili. Gli strumenti devono essere scelti e interpretati considerando la possibilità che il formato del compito introduca limitazioni non pertinenti. Una difficoltà nel rispondere verbalmente, per esempio, non equivale necessariamente a una difficoltà nel comprendere il problema; una limitazione visiva può richiedere materiali alternativi.
Nella valutazione di una disabilità intellettiva, le capacità cognitive non esauriscono il quadro: è necessario considerare anche il funzionamento adattivo, cioè la capacità di affrontare compiti concettuali, sociali e pratici nella vita quotidiana, e il contesto di sviluppo. Questa precisazione evita di trattare un punteggio come una diagnosi autosufficiente. L'obiettivo della valutazione professionale è comprendere il funzionamento della persona per orientarvi sostegni, opportunità e interventi appropriati. Un esito numerico isolato non dovrebbe sostituire una valutazione complessiva condotta da professionisti competenti.
L'accessibilità non è un favore che altera automaticamente la scientificità della prova: è spesso una condizione per misurare realmente il costrutto. Ciò richiede però trasparenza sulle modifiche e sulle relative evidenze di validità. Un metodo alternativo può aumentare l'accessibilità e nello stesso tempo cambiare il peso di alcuni processi; il professionista deve capire e spiegare queste conseguenze. Lo stesso principio vale per prove digitali adattive: l'algoritmo può rendere efficiente la stima del livello, ma non elimina i problemi di comparabilità, sicurezza dei dati e giustificazione dell'uso dei risultati.
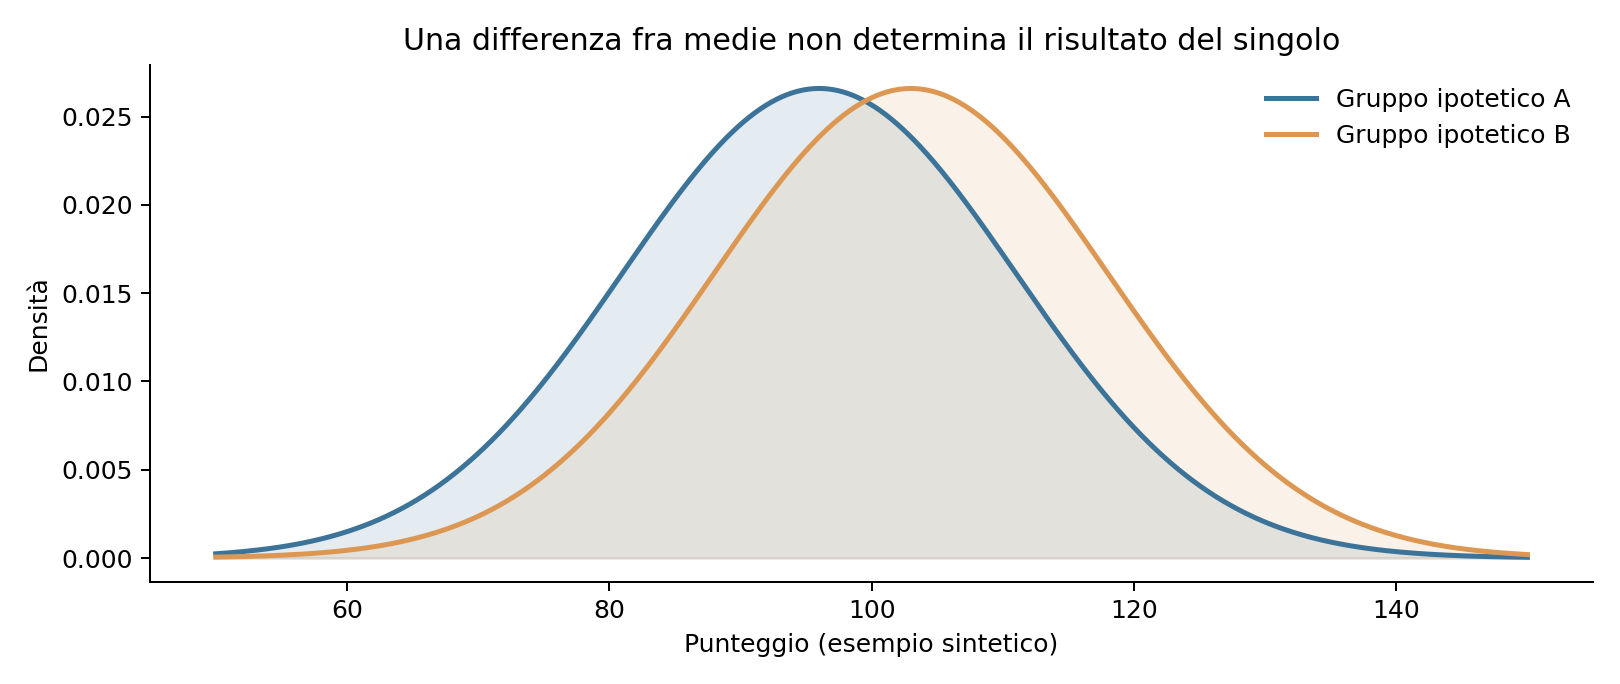
Tabella 10.10 — Domande fondamentali per la comparabilità
Questione | Verifica richiesta |
|---|---|
Lingua della prova | Comprensione delle istruzioni e carico linguistico |
Accessibilità | Modalità di risposta, tempi, dispositivi |
Invarianza | Relazioni equivalenti fra item e fattori |
Uso dei risultati | Decisioni appropriate, conseguenze ed errori |
10.9 — Interventi cognitivi, trasferimento e controversie
Un programma di allenamento della memoria di lavoro può insegnare a svolgere meglio esercizi molto simili a quelli praticati. La questione decisiva è il trasferimento: il miglioramento riguarda soltanto gli esercizi allenati oppure si estende stabilmente a competenze lontane, come il rendimento scolastico generale o il ragionamento astratto? Il cosiddetto trasferimento vicino è metodologicamente meno sorprendente del trasferimento lontano, e molte affermazioni commerciali di potenziamento cognitivo confondono i due fenomeni. Per verificare l’efficacia servono gruppi di confronto appropriati, misure indipendenti dal materiale allenato e controlli a distanza.
L’effetto placebo, le aspettative, la motivazione a dimostrare un miglioramento e la ripetizione degli stessi test possono simulare progressi attribuiti impropriamente a un programma. Un controllo attivo è utile perché coinvolge i partecipanti in attività plausibilmente credibili, anziché limitarli all’inattività. Anche in presenza di un risultato statisticamente significativo è importante conoscere la dimensione dell’effetto, la precisione della stima e la rilevanza pratica. La domanda non è soltanto se un training possa produrre una differenza misurabile, ma se questa differenza giustifichi costi, tempo e aspettative.
La ricerca sulle capacità cognitive incontra oggi questioni nuove: prove digitali adattive, intelligenza artificiale per selezionare item, problemi di privacy dei dati psicometrici e rischi di decisioni automatizzate. La rapidità di somministrazione non garantisce automaticamente validità; un algoritmo addestrato su un gruppo limitato può funzionare meno bene in altri contesti. Ogni innovazione richiede controlli di attendibilità, equità e interpretabilità. L’obiettivo più difendibile non è produrre etichette sempre più precise sulle persone, ma utilizzare le misure per individuare bisogni reali, opportunità formative e interventi appropriati.
10.9.1 — Che cosa significa «allenare il cervello»?
L'espressione «allenare il cervello» è suggestiva perché suggerisce che esercitare una funzione mentale possa accrescere un'abilità generale, come l'allenamento fisico può migliorare alcune capacità dell'organismo. Nella pratica, ripetere un compito cognitivo migliora spesso la prestazione proprio in quel compito. Il problema scientifico è stabilire se il guadagno dipenda da una capacità generale o da strategie specifiche, familiarità con gli stimoli, riduzione dell'ansia e maggiore velocità d'esecuzione. Le evidenze sul trasferimento lontano sono più deboli di quelle sui compiti esercitati. Questa distinzione impedisce di trasformare qualunque progresso in un gioco mentale in una promessa di aumentare l'intelligenza complessiva.
Una prova sperimentale convincente dovrebbe prevedere, prima della raccolta dei dati, quali esiti distanti ci si aspetta che migliorino; utilizzare misure non identiche a quelle allenate; includere un gruppo di controllo attivo altrettanto impegnato; valutare l'influenza delle aspettative e ripetere la misurazione dopo settimane o mesi. Senza queste cautele è possibile confondere un effetto di novità, un miglioramento specifico o la regressione verso la media con una trasformazione generale. Le rassegne metodologicamente rigorose hanno spesso riscontrato benefici limitati sui compiti non allenati, mentre la qualità del disegno spiega parte delle differenze tra studi.
I risultati non autorizzano a concludere che l'esercizio mentale sia privo di valore. Imparare una lingua, suonare uno strumento, studiare matematica o praticare un'attività creativa produce conoscenze e abilità importanti; questi obiettivi sono utili anche quando non si osserva un aumento del QI generale. La distinzione fra beneficio specifico e trasformazione generale tutela il lettore da promesse commerciali non giustificate e valorizza risultati realistici. Un programma educativo dovrebbe essere giudicato sugli apprendimenti che produce, non su un'etichetta di «potenziamento cognitivo» non definita.
10.9.2 — Valutare un intervento: dimensione dell'effetto e durata
Immaginiamo un intervento che migliori di due punti una prova standardizzata con deviazione standard 15, rispetto a un gruppo di controllo. La differenza standardizzata, in un esempio didattico che ignora ulteriori complicazioni, sarebbe d ≈ 2/15 = 0,13: un effetto piccolo. Il valore non è privo di significato per definizione, ma va rapportato a costo, durata, rischi, gruppo beneficiario e importanza dell'esito. Se il miglioramento scompare dopo alcune settimane o riguarda solo una prova molto simile agli esercizi, non possiamo presentarlo come aumento stabile dell'intelligenza. Se invece un intervento migliora concretamente competenze scolastiche o autonomia quotidiana, tale beneficio merita attenzione anche se l'effetto sul QI globale è modesto.
La dimensione dell'effetto va accompagnata dalla precisione statistica. Un campione piccolo può produrre una stima apparentemente elevata ma molto incerta; gli studi con molti confronti non preregistrati aumentano il rischio di evidenziare selettivamente i risultati favorevoli. Anche un intervento apparentemente efficiente può essere poco generalizzabile se il campione comprende soltanto volontari molto motivati, se i ricercatori hanno escluso molti partecipanti o se i valutatori conoscono la condizione sperimentale. La meta-analisi può aiutare a sintetizzare, ma non corregge automaticamente tutti i difetti degli studi originali.
Quando si parla di potenziamento cognitivo farmacologico o tecnologico, la prudenza deve essere ancora maggiore. Aumentare temporaneamente la vigilanza non equivale a migliorare l'intelligenza complessiva; stimolazioni cerebrali o trattamenti sperimentali richiedono controlli su benefici e rischi, modalità di somministrazione ed effetti a lungo termine. Non esiste una scorciatoia scientificamente consolidata che trasformi persone sane in individui generalmente più intelligenti mediante una procedura semplice. In questo campo, la qualità dell'evidenza e la sicurezza devono prevalere sul fascino delle promesse.
10.9.3 — Intelligenza artificiale e intelligenza umana: analogie ingannevoli
Il termine «intelligenza» viene utilizzato anche in informatica per descrivere sistemi capaci di risolvere problemi, classificare informazioni e produrre testi o immagini. L'analogia è utile quando si confrontano funzioni specifiche, ma diventa ambigua se si suppone che prestazioni simili implichino identici meccanismi psicologici. Un modello computazionale può ottenere risultati elevati in una prova di ragionamento verbale senza possedere le stesse esperienze, motivazioni e traiettorie evolutive di una persona. Viceversa, gli esseri umani affrontano problemi con corpi, relazioni sociali e obiettivi pratici che non si riducono alle operazioni svolte da un sistema artificiale.
L'impiego dei test cognitivi su sistemi di intelligenza artificiale solleva una questione di validità. Prove costruite per distinguere persone possono perdere significato quando applicate a sistemi addestrati su quantità enormi di testi, esempi e soluzioni. È spesso difficile sapere se una risposta derivi da capacità di generalizzazione, riconoscimento di strutture già incontrate o una loro combinazione. Anche quando il sistema non abbia visto gli stessi item, il confronto con gli esseri umani richiede attenzione ai tempi, agli strumenti disponibili e alla natura dei compiti. Parlare di un «QI dell'IA» senza chiarire queste condizioni può essere mediaticamente efficace ma scientificamente fuorviante.
Gli strumenti digitali possono inoltre trasformare la valutazione umana: prove adattive, correzione automatica e analisi dei tempi di risposta offrono nuove possibilità, ma introducono rischi di opacità algoritmica, raccolta eccessiva di dati e funzionamento non equivalente fra popolazioni. Se un algoritmo decide quali compiti proporre, bisogna poter esaminare su quali informazioni opera, come è stato validato e quali errori commette. La tecnologia non rende superflua la psicometria; ne aumenta, in alcune applicazioni, la responsabilità metodologica ed etica.
10.9.4 — Falsi miti e conclusioni operative
Un primo falso mito sostiene che una persona possieda una quantità fissa di intelligenza determinata una volta per tutte alla nascita. Le differenze individuali presentano componenti biologiche, ma lo sviluppo e l'istruzione influenzano le prestazioni cognitive. Un secondo mito afferma che sia sufficiente esercitare pochi giochi su uno schermo per migliorare qualunque abilità mentale: i miglioramenti specifici sono più facili da dimostrare del trasferimento generale. Un terzo mito identifica un singolo valore di QI con il valore, la creatività o le possibilità di una persona. La scienza non fornisce alcuna giustificazione per questa riduzione.
Un ulteriore equivoco riguarda il significato sociale della misurazione. Rifiutare abusi e discriminazioni non richiede di negare ogni differenza psicometrica; riconoscere tali differenze non autorizza a classificare gli esseri umani per dignità. Il compito dello psicologo è produrre interpretazioni circoscritte, fondate su strumenti adeguati e aperte a revisione. La stessa persona può beneficiare di una valutazione accurata se essa consente di individuare sostegni efficaci, ma essere danneggiata da una conclusione affrettata o dall'uso selettivo di un numero.
La prospettiva più feconda considera l'intelligenza un oggetto di ricerca multilivello: distribuzioni psicometriche, processi cognitivi, sviluppo, sistemi neurali, influenze genetiche e condizioni sociali. Ciascun livello permette alcune inferenze e ne lascia aperte altre. Una valutazione seria non propone un numero come risposta a tutte le domande sulla mente, ma usa misure contestualizzate per capire come le persone apprendono, risolvono problemi e possono essere messe nelle condizioni di sviluppare le proprie capacità.
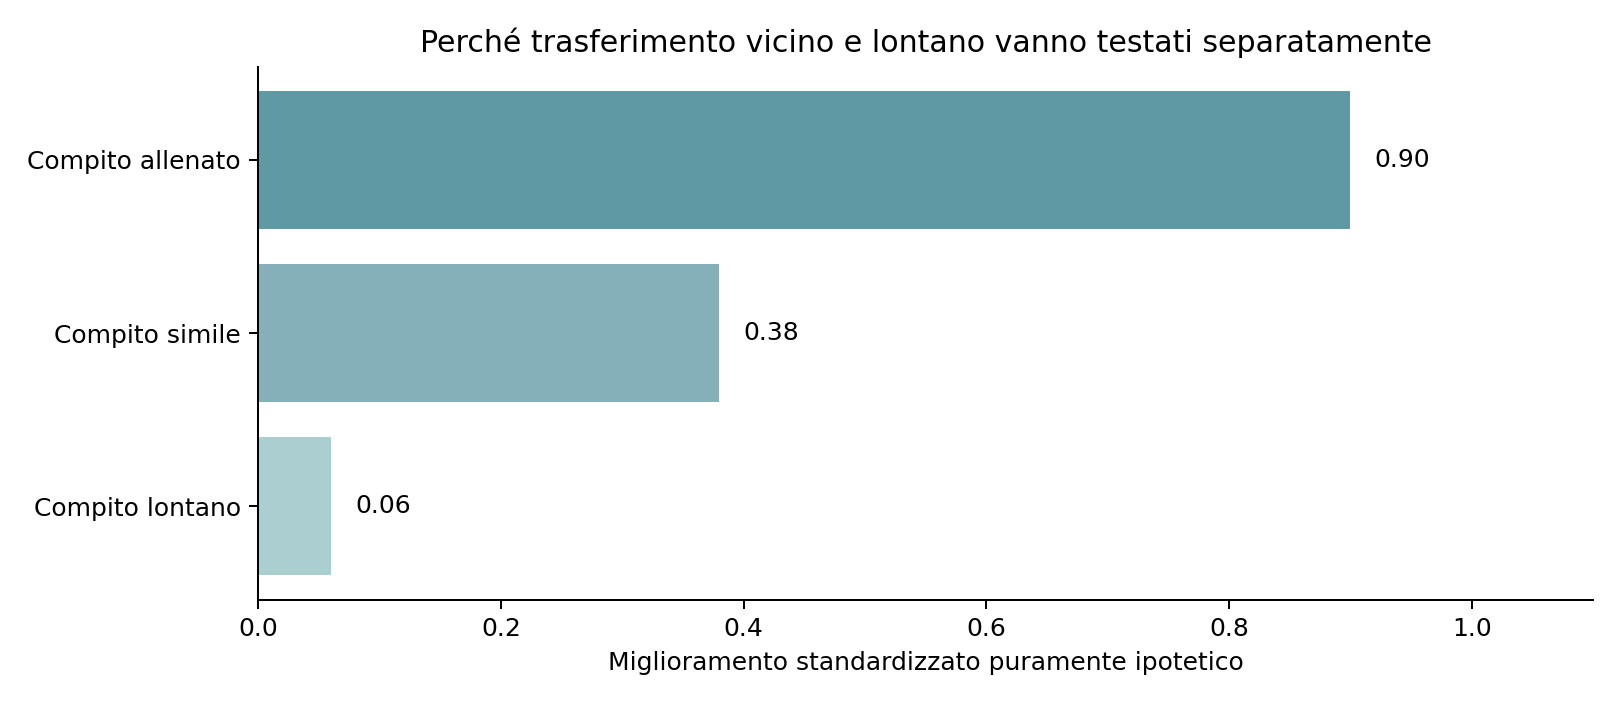
Tabella 10.11 — Interventi e natura delle prove
Esito | Esempio | Interpretazione |
|---|---|---|
Miglioramento specifico | Più risposte corrette nel gioco praticato | Apprendimento del compito |
Trasferimento vicino | Beneficio in un esercizio simile | Generalizzazione circoscritta |
Trasferimento lontano | Beneficio in ragionamento indipendente | Richiede controllo rigoroso |
Persistenza | Beneficio ancora presente a distanza | Da verificare con follow-up |
Laboratorio 10.A — Il significato quantitativo di un punteggio
Consideriamo un insieme di 10.000 risultati che, soltanto per esercizio, segua esattamente una distribuzione normale con media 100 e deviazione standard 15. Questo modello descrive una popolazione teorica e non una ricerca reale. Una persona con punteggio 130 avrebbe z = (130 − 100)/15 = 2. In una normale standard, l'area al di sopra di z = 2 è circa il 2,28%; perciò ci aspetteremmo, a grandi linee, 228 osservazioni superiori a 130 su 10.000. È tuttavia improprio usare questa stima per stabilire il numero esatto di persone con una certa capacità in una popolazione reale. Occorrono dati di normazione, una distribuzione appropriata e attenzione agli errori di misura e ai limiti estremi della scala.
Un secondo soggetto ottiene 85, cioè z = −1. I due punteggi distano 45 punti, ma questa distanza aritmetica non dice quanto differiscano nella vita quotidiana in termini di adattamento, successo o benessere. I punteggi standardizzati confrontano posizioni sulla scala della prova; non trasformano automaticamente differenze numeriche in conseguenze causali. Se i due individui appartengono a fasce d'età differenti, il confronto richiede norme appropriate a ciascuna fascia; se sono stati valutati con strumenti diversi, serve verificare la comparabilità. Il modello normale è utile per comprendere le scale, ma non sostituisce il giudizio professionale.
È importante distinguere il confronto con una popolazione dal confronto con se stessi nel tempo. Se la stessa persona ottiene 100 a un primo esame e 106 dopo due mesi, non basta la differenza di sei punti per affermare un miglioramento sostanziale. A seconda della precisione della scala, una parte del cambiamento può derivare da errore di misura, familiarità col test o modifiche del contesto. In un percorso educativo, il miglioramento deve essere valutato anche attraverso compiti autentici: comprensione, autonomia, capacità di applicare strategie e qualità del ragionamento. L'interpretazione corretta comincia quando il numero viene messo in relazione con il problema concreto, anziché essere trattato come un risultato autosufficiente.
Laboratorio 10.B — L'errore standard e le decisioni vicino a una soglia
Immaginiamo un programma didattico che offra sostegno aggiuntivo a persone con punteggi inferiori a 90 su una determinata scala. Una studentessa ottiene 89 e un'altra 91. La soglia amministrativa le colloca in due categorie differenti, ma il margine d'incertezza della misura può essere più grande della distanza che le separa. Se il SEM è di 4 punti, ad esempio, entrambi i punteggi sono compatibili con una gamma di valori molto ampia, sotto le ipotesi del modello. Perciò il professionista non dovrebbe concludere che le due persone abbiano capacità nettamente differenti. Una decisione equa può richiedere altri dati, valutazione del funzionamento reale e un criterio esplicito per i casi prossimi alla soglia.
Il problema può essere espresso come differenza fra una regola decisionale e un'affermazione scientifica. Un'amministrazione ha talvolta bisogno di una soglia per assegnare risorse limitate, ma non ne segue che esista una discontinuità naturale esattamente a quel punteggio. La statistica aiuta a stimare l'errore di classificazione e a discutere il rischio di false esclusioni e false inclusioni. Quanto maggiore è il costo di un errore, tanto più importante è il ricorso a misure multiple e alla possibilità di riesame. Sarebbe sbagliato attribuire alla linea amministrativa una precisione psicologica che il test non possiede.
Un controllo etico ulteriore riguarda il linguaggio del referto. Dire «ha un QI di 89» può sembrare un dato assoluto; scrivere che «nelle condizioni di valutazione ha ottenuto un punteggio standardizzato di 89 sulla scala impiegata, da interpretare con la relativa incertezza e insieme ad altre informazioni» rappresenta meglio la conoscenza disponibile. La seconda formulazione è più lunga, ma evita il salto dal risultato al giudizio sulla persona. Non è un dettaglio retorico: formulazioni diverse possono influenzare aspettative di insegnanti, famiglie e persone valutate.
Laboratorio 10.C — Interpretare correttamente uno studio sui gemelli
Si consideri un esempio didattico con correlazione fra gemelli monozigoti pari a 0,78 e correlazione fra dizigoti pari a 0,52. Nella formulazione semplificata del modello ACE, e assumendo che tutte le ipotesi pertinenti siano rispettate, la componente genetica additiva può essere stimata come A ≈ 2 × (0,78 − 0,52) = 0,52. La componente ambientale condivisa risulterebbe C ≈ 2 × 0,52 − 0,78 = 0,26, mentre la componente residua E ≈ 1 − 0,78 = 0,22. I valori sono inventati per esercizio e non descrivono una popolazione reale. La loro somma è uno, ma il fatto che la scomposizione sia coerente aritmeticamente non prova che il modello causale sia corretto.
Nel modello questo risultato non significa che il 52% dell'intelligenza di ogni partecipante sia genetico o che il 26% sia stato «insegnato dai genitori». Le componenti riguardano la varianza fra persone nelle condizioni osservate. Inoltre, il disegno può essere influenzato da assortimento dei genitori, interazioni, ambienti non equivalenti, dipendenza dall'età e misurazione. Per questo le inferenze dovrebbero essere confrontate con dati di adozione, studi longitudinali e metodi genomici. Una stima di ereditarietà, anche precisa, non implica che una politica educativa non possa modificare la media dei punteggi né indica quale intervento sarà efficace.
Se in una seconda popolazione le opportunità scolastiche fossero molto più differenziate, la scomposizione statistica potrebbe essere diversa pur mantenendo invariati molti meccanismi biologici. Le stime sono perciò inseparabili dalla popolazione e dall'ambiente cui si riferiscono. Il laboratorio mostra perché il metodo quantitativo debba essere accompagnato da un'interpretazione sostanziale: usare correttamente una formula è necessario ma non sufficiente per comprendere il significato scientifico del risultato.
Laboratorio 10.D — Disegnare uno studio sul potenziamento cognitivo
Un gruppo di ricerca vuole verificare se un programma di esercizi di memoria di lavoro migliori la capacità di ragionamento in studenti universitari. Prima della raccolta dei dati dovrebbe specificare un outcome primario, per esempio una prova indipendente di ragionamento astratto, e definire un confronto credibile. Assegnare casualmente alcuni studenti agli esercizi e gli altri a non fare nulla sarebbe poco convincente, perché il gruppo sperimentale riceverebbe più attenzione, stimoli e aspettative di miglioramento. Un controllo attivo, composto da attività alternative con impegno e plausibilità simili, aiuta a isolare gli effetti specifici del programma.
Occorre poi distinguere le prove vicine agli esercizi dalla misura indipendente di ragionamento. Se il programma usa sequenze di simboli, il miglioramento su sequenze quasi identiche può essere effetto della pratica. Per valutare il trasferimento lontano, le misure devono richiedere operazioni differenti e non essere state utilizzate durante l'allenamento. È utile raccogliere i dati a distanza di tempo, preregistrare ipotesi e analisi, considerare il numero di abbandoni e riferire tutti gli esiti previsti anche se nulli. Un risultato favorevole su una sola delle molte misure non preregistrate deve essere interpretato con prudenza.
Immaginiamo che, alla fine, il gruppo sperimentale migliori significativamente nelle sequenze allenate, migliori poco in un compito simile e non differisca dal controllo nella prova indipendente di ragionamento. Questo risultato sarebbe perfettamente compatibile con un apprendimento efficace delle strategie specifiche, ma non con la conclusione di un aumento dimostrato dell'intelligenza generale. Presentare separatamente questi esiti è un esempio di rigore scientifico: evita sia di svalutare ogni apprendimento sia di promettere effetti non verificati.
Laboratorio 10.E — Leggere criticamente una notizia sulle differenze fra gruppi
Supponiamo che un articolo giornalistico riporti una differenza media di cinque punti fra due campioni su una prova cognitiva. Prima di formulare una spiegazione, dobbiamo sapere come sono stati selezionati i partecipanti, quale fascia di età rappresentano, quale lingua conoscono, se il test è equivalente fra i gruppi e quale sia la variabilità interna. Occorre poi conoscere intervalli di confidenza, entità dell'effetto standardizzato e fattori di confondimento. Anche una differenza stimata con precisione può essere dovuta a cause molteplici che il disegno non è in grado di distinguere.
Se i gruppi hanno medie diverse ma distribuzioni sovrapposte, il dato non consente di giudicare la capacità di una singola persona in base alla sua appartenenza. Il rischio dell'errore ecologico consiste precisamente nel trasferire una proprietà aggregata ai singoli senza prove adeguate. D'altra parte non è scientificamente corretto negare l'esistenza di una differenza osservata soltanto perché la sua interpretazione può essere socialmente delicata. Il metodo richiede due passaggi distinti: descrivere con precisione ciò che i dati mostrano e delimitare le spiegazioni causali realmente supportate.
Il lettore dovrebbe inoltre chiedersi quale scopo serva il confronto. Un'analisi può aiutare a identificare opportunità educative diseguali e progettare interventi di sostegno; può essere anche abusata per attribuire etichette essenzialistiche e giustificare decisioni discriminatorie. Il controllo critico non riguarda solo le procedure statistiche, ma l'adeguatezza delle categorie e la proporzionalità delle conclusioni. Una ricerca responsabile presenta incertezze e limiti con la stessa evidenza dei risultati principali.
Approfondimento — Calcolo illustrativo di un punteggio standardizzato
Si immagini un test con media normativa 100 e deviazione standard 15. Per una persona che ottiene 112, il punteggio z è (112−100)/15 = 0,80. Il risultato indica una distanza di 0,8 deviazioni standard sopra la media del gruppo normativo, non una quantità di intelligenza assoluta. La trasformazione presume che la scala e il campione siano appropriati. Non è sufficiente per una diagnosi, né descrive da sola le abilità del soggetto.
Approfondimento — Un esempio di errore standard di misura
Supponiamo, soltanto a fini illustrativi, che la deviazione standard della scala sia 15 e l’attendibilità utilizzabile per questo scopo sia 0,90. L’errore standard di misura classico risulta 15 × √0,10 ≈ 4,74. Una fascia indicativa ottenuta come punteggio ±1,96 SEM attorno a 112 va da circa 102,7 a 121,3. Non si tratta di un intervallo clinico valido per qualsiasi strumento e non significa che la vera capacità della persona vari giorno per giorno entro tale fascia. I manuali professionali applicano procedure coerenti con lo strumento e lo scopo.
Approfondimento — Leggere uno studio sull’intelligenza
Una ricerca riferisce una correlazione di 0,45 fra un punteggio cognitivo e un indicatore di apprendimento. Il primo passo consiste nel chiedere come siano state definite e misurate entrambe le variabili. Il secondo è controllare il campione, la precisione della stima e le possibili variabili confondenti, fra cui istruzione precedente e condizioni sociali. In un modello lineare semplice, r² = 0,2025 descrive circa il 20% di varianza condivisa statisticamente; non significa che il test causi il 20% dell’apprendimento, né che il restante 80% dipenda da un’unica forza esterna. La traduzione da un indice aggregato a una previsione individuale richiede analisi ulteriori.
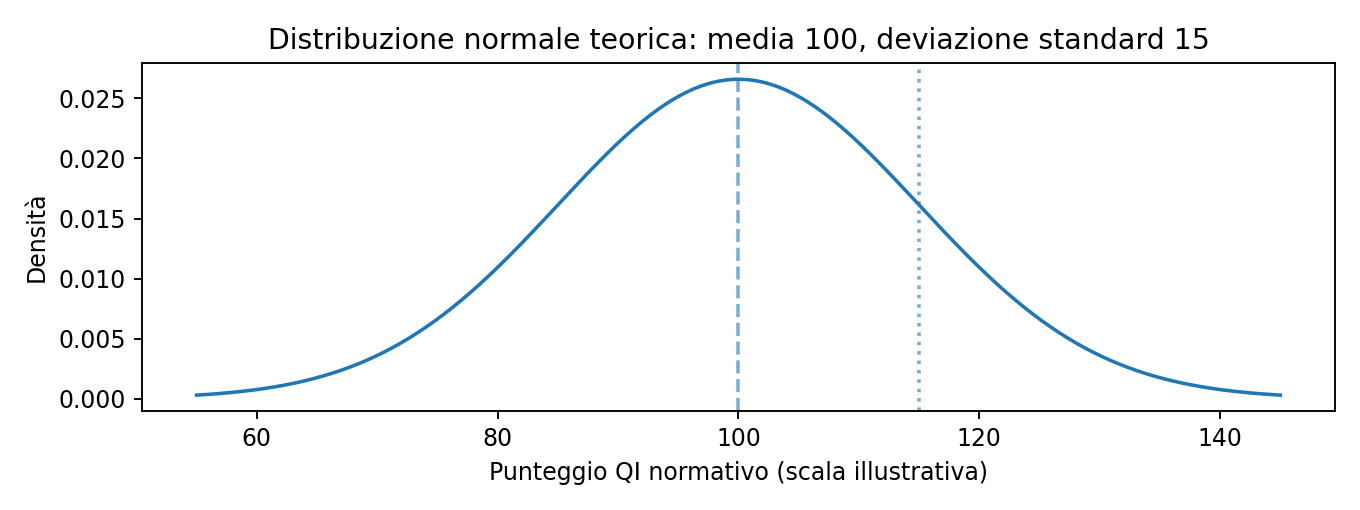
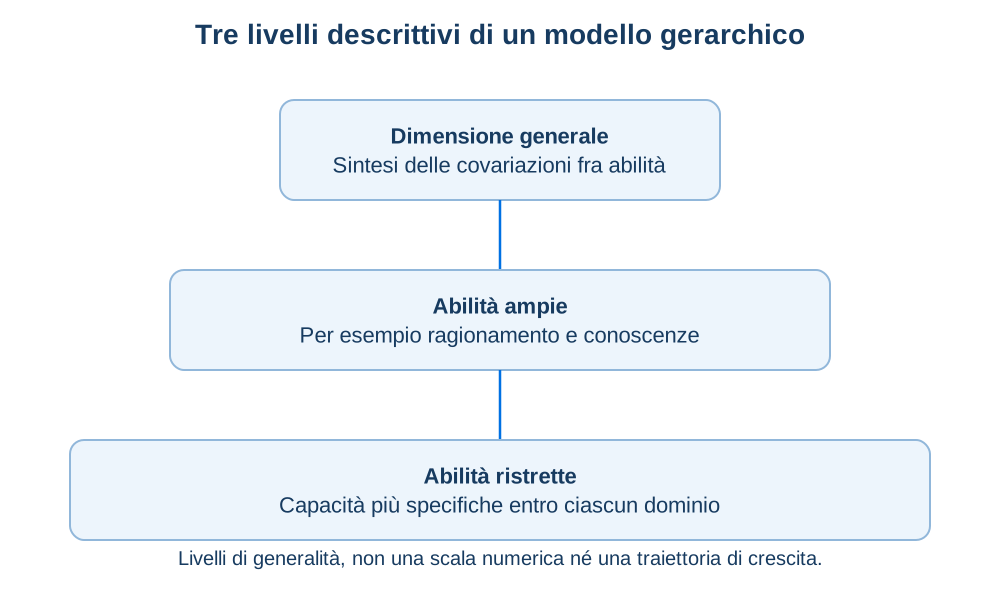
Tabella 10.1 — Dimensioni della qualità della misurazione
Concetto | Domanda | Limite interpretativo |
|---|---|---|
Attendibilità | Quanto è coerente il punteggio? | La coerenza non prova da sola validità |
Validità | Quali inferenze risultano giustificate? | Dipende da scopo e popolazione |
Norme | A quale popolazione si confronta? | Campione normativo e data contano |
Equità | Il test funziona comparabilmente? | Richiede prove statistiche e analisi sociali |
Tabella 10.2 — Alcune abilità cognitive, senza pretendere una tassonomia esaustiva
Dimensione | Caratteristiche prevalenti | Esempio |
|---|---|---|
Fluida | Relazioni e problemi relativamente nuovi | Individuare una regolarità astratta |
Cristallizzata | Conoscenze e linguaggio acquisiti | Definire parole e comprendere concetti |
Memoria di lavoro | Mantenere e trasformare informazioni | Riordinare mentalmente una sequenza |
Velocità di elaborazione | Eseguire compiti semplici accuratamente e rapidamente | Ricerca visiva a tempo |
Tabella 10.3 — Errori comuni sull’intelligenza
Affermazione | Valutazione critica |
|---|---|
Alta ereditarietà implica immutabilità | Falso: riguarda varianza in un contesto |
Un QI di 120 indica il 20% più intelligenza | Falso: scala standardizzata, non rapporto |
La differenza tra medie spiega le sue cause | Falso: descrizione e spiegazione sono distinte |
Migliorare il gioco allenato prova trasferimento lontano | Falso: servono misure indipendenti |
Collegamenti interdisciplinari
La psicometria incontra la statistica multivariata quando si stimano strutture fattoriali; la genetica comportamentale affronta problemi di attribuzione causale; l’economia dell’istruzione studia il rendimento degli investimenti educativi e i vincoli che limitano l’accesso alle opportunità; le neuroscienze analizzano sistemi distribuiti coinvolti nel controllo e nel ragionamento. Un programma di ricerca integrato evita di attribuire a uno solo di questi livelli una risposta esaustiva. La stessa prestazione può essere osservata come risultato misurabile, processo cognitivo, attività neurale, traiettoria di sviluppo e conseguenza di condizioni sociali.
Sintesi ragionata
L’intelligenza è un costrutto utile ma multidimensionale. La psicometria descrive regolarità fra prestazioni cognitive; i modelli gerarchici rendono interpretabili tali correlazioni, pur lasciando aperta la spiegazione dei meccanismi. I punteggi standardizzati acquistano significato solo in rapporto a norme, errore di misura, validità ed equità. Influenze genetiche e ambientali interagiscono e le stime di ereditarietà non autorizzano conclusioni di immutabilità. La qualità dell’istruzione e le opportunità sociali incidono sulla formazione e sull’espressione delle competenze. Infine, le promesse di potenziamento cognitivo devono essere valutate con prove di trasferimento e benefici durevoli, non soltanto osservando progressi nell’esercizio ripetuto.
Glossario del capitolo
Abilità ampia — dimensione cognitiva che raggruppa processi e prove correlate.
Abilità ristretta — competenza specifica nella struttura psicometrica.
Analisi fattoriale confermativa — Procedura per confrontare un modello latente predefinito con covarianze osservate.
Analisi fattoriale esplorativa — Metodo per ricercare strutture latenti plausibili senza imporre completamente la struttura iniziale.
Ancoraggio culturale — Dipendenza di una prestazione da esperienze e convenzioni proprie del contesto di apprendimento.
Attendibilità — coerenza di una misura nelle condizioni pertinenti.
Bias culturale — distorsione della prova dovuta a caratteristiche culturali non pertinenti.
Campione normativo — gruppo di riferimento usato per interpretare punteggi.
Capacità cristallizzata — conoscenze consolidate attraverso apprendimento ed esperienza.
Capacità fluida — ragionamento relativamente indipendente da conoscenze specifiche.
Contingenza causale — Rapporto nel quale un cambiamento di un fattore produce, date alcune condizioni, una modificazione dell’esito.
Controllo attivo — condizione sperimentale che offre attività alternativa credibile.
Correlazione gene-ambiente — associazione fra caratteristiche genetiche ed esposizioni ambientali.
Costrutto — entità teorica definita tramite rete di osservazioni e ipotesi.
Deviazione standard — indice di dispersione dei valori rispetto alla media.
Effetto della pratica — cambiamento del risultato dovuto alla familiarità col compito.
Effetto Flynn — Variazione intergenerazionale dei punteggi in molte prove cognitive, diversa fra popolazioni e periodi.
Equità — appropriatezza della misurazione nei diversi gruppi e contesti.
Ereditarietà — proporzione della varianza attribuita statisticamente a differenze genetiche.
Errore standard di misura — stima dell’incertezza associata a un punteggio.
Fattore g — dimensione generale di covariazione fra prestazioni cognitive.
Funzionamento adattivo — Competenze concettuali, sociali e pratiche nella vita quotidiana.
Funzionamento differenziale dell’item — Differente probabilità di risposta a un item nei gruppi, a pari livello stimato della caratteristica.
Intelligenza — insieme di capacità cognitive di apprendimento, ragionamento e adattamento.
Interazione gene-ambiente — situazione in cui gli effetti sono condizionati dal contesto.
Intervallo di confidenza — intervallo ottenuto da una procedura statistica con copertura attesa specificata.
Invarianza di misura — comparabilità del costrutto misurato nei gruppi.
Manifold positivo — tendenza delle prove cognitive a essere correlate positivamente.
Meta-analisi — sintesi quantitativa dei risultati di studi comparabili.
Modello gerarchico — modello delle abilità organizzate su livelli di generalità.
Norme — distribuzioni di riferimento per interpretare punteggi.
Psicometria — disciplina che studia misurazione di attributi psicologici.
Punteggio grezzo — risultato prima della trasformazione normativa.
Qi di deviazione — punteggio standardizzato relativo a distribuzione di riferimento.
Regressione verso la media — Tendenza di misurazioni ripetute dopo risultati estremi ad assumere valori meno estremi in presenza di variabilità e errore.
Scala normativa — Sistema di conversione dei punteggi basato su una popolazione di riferimento.
Standardizzazione — uniformazione delle procedure e costruzione di norme.
Trasferimento lontano — generalizzazione a compiti differenti da quelli allenati.
Trasferimento vicino — generalizzazione a prove simili.
Validità — grado di sostegno alle interpretazioni dei punteggi.
Validità predittiva — Sostegno empirico all’uso di un punteggio per prevedere un risultato definito.
Varianza — misura della dispersione dei risultati.
Velocità di elaborazione — rapidità nello svolgimento di compiti cognitivi appropriati.