
4. Inferenza statistica — Riassunto Completo per l’Esame
L’obiettivo dell’inferenza statistica è usare i dati del campione per formulare conclusioni sulla popolazione.
Simboli chiave:
X: variabile aleatoria.
X₁,...,Xₙ: campione casuale di n osservazioni.
μ (mu): media della popolazione.
σ² (sigma quadrato): varianza della popolazione.
σ: deviazione standard della popolazione.
(theta): parametro generico da stimare.
p: proporzione della popolazione.
(theta cappello): stimatore del parametro θ.
α (alfa): livello di significatività nei test (probabilità di errore di I tipo).
β (beta): probabilità di errore di II tipo.
Φ (Phi maiuscola): funzione di ripartizione della normale standard.
4.1 Modello statistico parametrico e campionamento
Modello statistico parametrico
Un modello statistico è una famiglia di distribuzioni che assumiamo possa descrivere la popolazione.
È scritto come:
{ f(x; θ) : θ ∈ Θ }
dove:
f(x; θ) è la densità o la funzione di probabilità;
θ è il parametro (o vettore di parametri) da stimare;
Θ è lo spazio dei parametri.
Esempi:
- Normale N(μ, σ²) con parametri μ e σ².
- Bernoulliana con parametro p.
- Poisson con parametro λ.
Campione casuale
Un campione casuale è una sequenza di variabili indipendenti e identicamente distribuite (i.i.d.) con distribuzione comune f(x; θ).
Questo significa:
- stessa distribuzione (identicamente distribuite),
- indipendenti una dall’altra,
- non influenzano il valore delle altre.
4.2 Stima puntuale e proprietà degli stimatori
Stima puntuale
Una stima puntuale è un singolo numero calcolato dal campione che approssima un parametro incognito.
Esempi:
- Stimatore della media:
- Stimatore della proporzione: , dove k è il numero di successi.
- Stimatore della varianza:
Proprietà desiderabili degli stimatori
1. Non distorsione (unbiasedness)
Uno stimatore è non distorto se:
Esempio: la media campionaria è un stimatore non distorto di μ.
2. Distorsione ed errore quadratico medio
La distorsione, o bias, di uno stimatore T del parametro è:
Se: lo stimatore è non distorto.
L’errore quadratico medio misura quanto lo stimatore si discosta mediamente dal parametro vero:
Vale la scomposizione fondamentale:
Per confrontare due stimatori, si preferisce quello con MSE minore.
Attenzione: se entrambi gli stimatori sono non distorti, il confronto si riduce al confronto tra le varianze.
3. Consistenza
è consistente se, al crescere di n, converge al valore vero del parametro:
Significa: con grandi campioni, lo stimatore diventa sempre più preciso.
4. Efficienza
Tra due stimatori non distorti, è più efficiente quello con varianza minore.
5. Sufficienza
Un stimatore è sufficiente se cattura tutta l’informazione del campione sul parametro.
Esempio: per una normale con varianza nota, la media campionaria è sufficiente per μ.
Standard error degli stimatori principali
Lo standard error misura la variabilità dello stimatore.
Media campionaria
Se la deviazione standard della popolazione è nota:
Se è ignota, si utilizza la stima:
Proporzione campionaria
Attenzione: nel calcolo dello standard error stimato della proporzione utilizzi .
Stimatore, stima ed errore standard
Lo stimatore è una regola applicabile a qualsiasi campione; la stima è il numero ottenuto dopo aver osservato un campione specifico. La media campionaria è uno stimatore, mentre “102 grammi” può essere una sua realizzazione. Le proprietà come non distorsione e consistenza riguardano la regola e la sua distribuzione campionaria, non certificano che il numero osservato sia vicino al parametro in ogni singolo caso.
Non distorto significa corretto in media su campioni ripetuti. Uno stimatore può essere non distorto ma molto variabile. Per esempio, usare soltanto la prima osservazione per stimare μ produce uno stimatore non distorto, ma la sua varianza non diminuisce aggiungendo dati che la regola ignora. La media di tutte le osservazioni ha invece varianza σ²/n ed è consistente nelle condizioni della LGN. Non distorsione e consistenza sono quindi proprietà diverse.
La scomposizione dell’errore quadratico medio in varianza e distorsione al quadrato chiarisce il compromesso. Per stimare lo stesso parametro, una regola non distorta con varianza 9 ha errore quadratico medio 9; una regola con distorsione 1 e varianza 4 ha errore quadratico medio 5. La seconda può essere preferibile secondo questo criterio, pur essendo distorta. Il confronto va fatto al medesimo valore del parametro: l’ordinamento può cambiare nei diversi punti dello spazio dei parametri.
La deviazione standard dei dati descrive quanto differiscono le singole osservazioni; l’errore standard della media descrive quanto variano le medie di campioni ripetuti. Con deviazione standard stimata di 12 e 36 osservazioni indipendenti, l’errore standard stimato è 12/√36 = 2. Se la numerosità sale a 144 e la dispersione resta simile, l’errore standard scende a 1; la deviazione standard dei singoli dati non si dimezza per questo motivo.
Il denominatore n − 1 della varianza campionaria corretta deriva dal fatto che la media è stata stimata dagli stessi dati: gli scarti dalla media hanno somma zero e soltanto n − 1 possono variare liberamente. Per osservazioni i.i.d. con varianza finita questa correzione rende la varianza campionaria non distorta. Non rende automaticamente non distorta anche la sua radice quadrata.
Infine, la formula σ/√n presuppone il modello indipendente adottato. Nel campionamento casuale semplice senza reinserimento da una popolazione finita, le estrazioni sono dipendenti e compare una correzione per popolazione finita. Con dati raggruppati per famiglie, classi o periodi temporali occorre rispettare la struttura di dipendenza nel calcolo dell’incertezza: trattare tutte le osservazioni come indipendenti può sottostimarla.
4.3 Stima intervallare
I metodi intervallari costruiscono un intervallo che contiene il parametro con un certo livello di confidenza (1 − α).
Intervalli di confidenza per μ
1. Varianza nota (σ nota)
Per campione grande o X normale:
2. Varianza sconosciuta (σ ignota)
Uso della distribuzione t di Student con n − 1 gradi di libertà:
Intervallo per una proporzione p
Valido per n grande:
Come interpretare e costruire un intervallo di confidenza
Un intervallo di confidenza combina una stima centrale e un margine di errore. Quest’ultimo è il prodotto tra un quantile della distribuzione di riferimento e l’errore standard. L’interpretazione frequentista del 95% riguarda la procedura: ripetendo molte volte il campionamento e costruendo ogni volta l’intervallo nello stesso modo, circa il 95% degli intervalli conterrà il parametro, se il modello e il metodo sono corretti. Il parametro è fisso; gli estremi dell’intervallo cambiano da un campione all’altro.
Una volta calcolato uno specifico intervallo, esso contiene il parametro oppure no. Nel quadro frequentista non si assegna una probabilità del 95% al parametro fisso di trovarsi in quegli estremi. Inoltre, l’intervallo per la media non contiene necessariamente il 95% dei dati individuali: un intervallo di previsione per una nuova osservazione affronta una domanda diversa e deve includere anche la variabilità della nuova osservazione.
Esempio svolto: peso medio di una produzione
Supponiamo 100 misurazioni indipendenti da una popolazione normale con deviazione standard nota di 20 grammi e media osservata di 102 grammi. L’errore standard è 20/√100 = 2 grammi. Per un intervallo bilaterale al 95% il quantile normale è circa 1,96: il margine è 1,96 per 2 = 3,92 grammi. L’intervallo va quindi da 98,08 a 105,92 grammi. La simmetria della costruzione lascia il 2,5% in ciascuna coda della distribuzione standardizzata.
Se la deviazione standard è ignota, si stima con s e, per un campione da popolazione normale, si usa la t di Student con n − 1 gradi di libertà. La distribuzione t ha code più pesanti della normale e tiene conto dell’incertezza aggiuntiva sulla dispersione. La procedura è esatta sotto normalità; fuori da questa ipotesi può essere un’approssimazione per campioni sufficientemente grandi, da valutare in rapporto ad asimmetria, valori estremi e dipendenza.
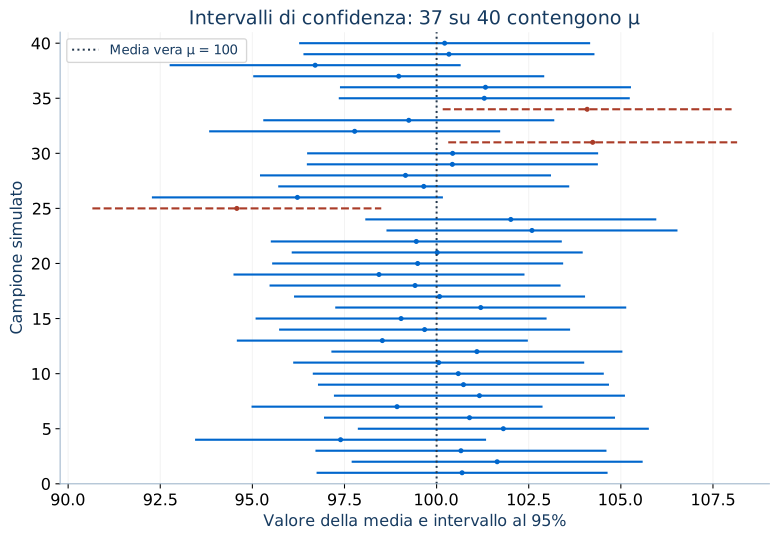
Aumentare il livello di confidenza dal 95% al 99% rende l’intervallo più largo, a parità di dati; aumentare n tende a restringerlo. Un intervallo molto stretto non protegge da errori sistematici: uno strumento mal calibrato o una selezione distorta possono produrre una stima precisa del valore sbagliato. Precisione e accuratezza non coincidono.
Per una proporzione, l’intervallo normale elementare riportato sopra è detto intervallo di Wald. Non basta che n sia genericamente “grande”: servono sufficienti successi e insuccessi, e vicino a 0 o 1 la copertura può essere scadente. Può persino dare estremi esterni a [0, 1]. In questi casi si considerano procedure come l’intervallo di Wilson o un intervallo binomiale esatto, specificando il metodo usato.
4.4 Verifica di ipotesi
Una ipotesi è un’affermazione sul parametro della popolazione.
Formulazione
H₀: ipotesi nulla (assunta per costruire la distribuzione di riferimento del test).
H₁: ipotesi alternativa.
Tre tipi di test:
- Bilaterale: H₁: θ ≠ θ₀
- Unilaterale destro: H₁: θ > θ₀
- Unilaterale sinistro: H₁: θ < θ₀
Errori
Errore di I tipo (α): rifiutare quando è vera.
Errore di II tipo (β): non rifiutare quando è falsa.
Il livello di significatività nominale viene fissato prima di svolgere il test ed è normalmente indicato nel testo dell’esercizio. Rappresenta la probabilità massima tollerata di rifiutare quando è vera.
Test sulla media
1. σ nota (test Z)
2. σ ignota (test t)
Se il valore del test cade nella regione critica, si rifiuta .
Test sulla proporzione
P-value o livello di significatività osservato
Il p-value misura quanto il risultato osservato sia incompatibile con .
Regola decisionale:
Non si scrive mai che è sicuramente vera. Si può soltanto rifiutare o non rifiutare .
Per il test sulla proporzione:
| Ipotesi alternativa | p-value |
| {} |
P-value, potenza e significatività: leggere il risultato
Un test confronta ciò che osserviamo con ciò che sarebbe plausibile assumendo l’ipotesi nulla e il modello. Il p-value è la probabilità, sotto queste ipotesi, di ottenere una statistica almeno altrettanto estrema di quella osservata nella direzione indicata dall’alternativa. Un test bilaterale considera scostamenti in entrambe le direzioni; un test unilaterale considera quella specificata prima di esaminare i risultati.
Il p-value non è la probabilità che l’ipotesi nulla sia vera, né la probabilità che il risultato sia “dovuto al caso”. Un valore piccolo segnala scarsa compatibilità tra dati e ipotesi del test. Un valore grande non dimostra l’assenza di un effetto: il campione potrebbe essere troppo poco informativo per rilevarlo. È preferibile riportare anche la stima dell’effetto e un intervallo di confidenza.
Esempio svolto: dalla statistica alla decisione
Per verificare una media teorica di 100 con alternativa bilaterale, supponiamo dati indipendenti normali, deviazione standard nota 20, numerosità 100 e media osservata 104. L’errore standard è 2 e la statistica Z vale (104 − 100)/2 = 2. Sotto l’ipotesi nulla, la probabilità di uno scostamento standardizzato almeno pari a 2 in valore assoluto è circa 0,0455. Al livello del 5% rifiutiamo l’ipotesi nulla; al livello dell’1% non la rifiutiamo. Il livello va fissato prima, non scelto dopo per ottenere la conclusione desiderata.
Lo stesso esempio produce l’intervallo bilaterale al 95% da 100,08 a 107,92: il valore ipotizzato 100 ne resta escluso. La corrispondenza tra test e intervallo vale quando entrambi derivano dalla stessa procedura e usano livelli coerenti. Non autorizza a confondere un intervallo per la media con un intervallo di previsione, né test unilaterali e bilaterali.
L’errore di primo tipo è rifiutare una nulla vera; il livello α ne controlla la probabilità secondo il modello. L’errore di secondo tipo è non rifiutare una nulla falsa. La sua probabilità β dipende dal valore alternativo effettivo: un effetto grande è in genere più facile da distinguere dal rumore. La potenza è 1 − β, cioè la probabilità di rilevare l’effetto quando quel valore alternativo è vero. A parità delle altre condizioni, più osservazioni aumentano la potenza; abbassare α rende il rifiuto più difficile e può ridurla.
La significatività statistica non misura l’importanza pratica. Con moltissimi dati può risultare significativo un cambiamento trascurabile; con pochi dati un cambiamento rilevante può avere un intervallo molto ampio. La conclusione deve quindi dire quanto è grande l’effetto, con quale incertezza e in quale contesto. Se si eseguono molti test, cresce il rischio di trovare almeno un risultato significativo per caso: servono una pianificazione esplicita e, quando appropriate, correzioni per confronti multipli.
Nel test su una proporzione, l’errore standard della statistica normale si calcola con la proporzione ipotizzata sotto la nulla, perché è quella la distribuzione di riferimento del test. Nell’intervallo di Wald, invece, si inserisce la proporzione stimata dal campione. Confondere questi due passaggi significa usare la variabilità del modello sbagliato.
4.5 Test di bontà di adattamento (Goodness of Fit)
Serve per verificare se i dati seguono una distribuzione teorica (esempio Poisson, normale, multinomiale).
Si usa il test (lettera greca che si legge chi quadrato).
Formula:
dove:
Oᵢ: frequenze osservate,
Eᵢ: frequenze attese sotto H₀,
k: numero di categorie.
Gradi di libertà: df = k - 1 - m
dove m è il numero di parametri stimati dai dati.
Regola: rifiuto H₀ se il valore calcolato supera il quantile critico
4.6 Test di indipendenza (tabella di contingenza)
Serve per verificare se due variabili categoriali sono indipendenti.
Ancora test χ²:
- H₀: le due variabili sono indipendenti.
- H₁: non sono indipendenti.
Frequenze attese:
Test statistico:
Gradi di libertà:
df = (r − 1)(c − 1)
dove r è il numero di righe e c delle colonne.
4.7 Test di omogeneità
È simile al test di indipendenza ma la domanda è diversa:
- test di indipendenza: un solo campione con due variabili.
- test di omogeneità: più campioni da popolazioni diverse e si verifica se le proporzioni sono uguali.
Si usa sempre χ².
Ipotesi:
- H₀: tutte le popolazioni hanno la stessa distribuzione delle categorie.
- H₁: almeno una popolazione ha distribuzione diversa.
Formula identica:
Quando usare l’approssimazione chi quadrato
Nei test chi quadrato si confrontano conteggi osservati e attesi, non percentuali trattate come se fossero conteggi. Le categorie devono essere definite in modo coerente e le osservazioni devono rispettare le ipotesi di indipendenza del disegno. Con frequenze attese molto piccole l’approssimazione può essere inadeguata: la regola di almeno 5 attesi per cella è un criterio prudente frequente, non una legge universale. Si possono considerare test esatti o simulazioni appropriate; un eventuale accorpamento delle categorie deve avere senso sostanziale e non essere scelto per forzare il risultato.
I gradi di libertà riflettono i vincoli e i parametri stimati. Nel test di adattamento, k − 1 − m è la formula usuale sotto le condizioni regolari del metodo di stima: k è il numero di categorie e m il numero di parametri stimati dai dati. In una tabella di indipendenza con r righe e c colonne, la formula usuale è (r − 1)(c − 1). Un rifiuto indica che il modello non descrive bene i conteggi, ma non spiega da solo dove sia la differenza: occorre esaminare anche frequenze, residui e dimensione dell’associazione.